# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
在 24GB GPU 上本地运行日常智能体任务
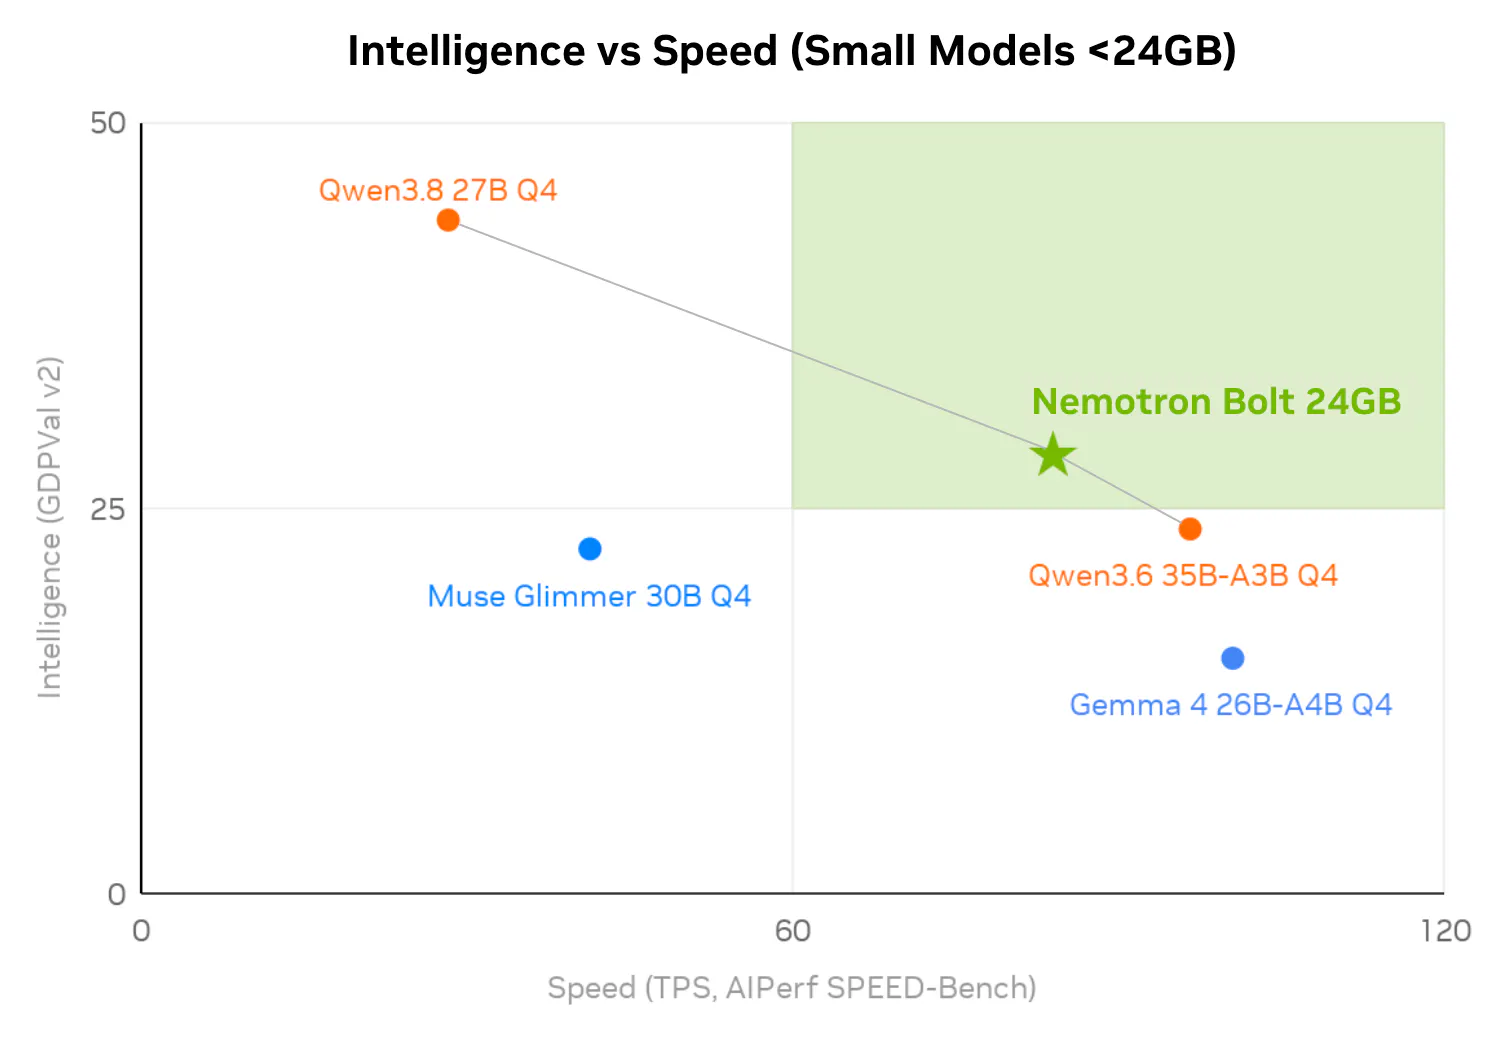
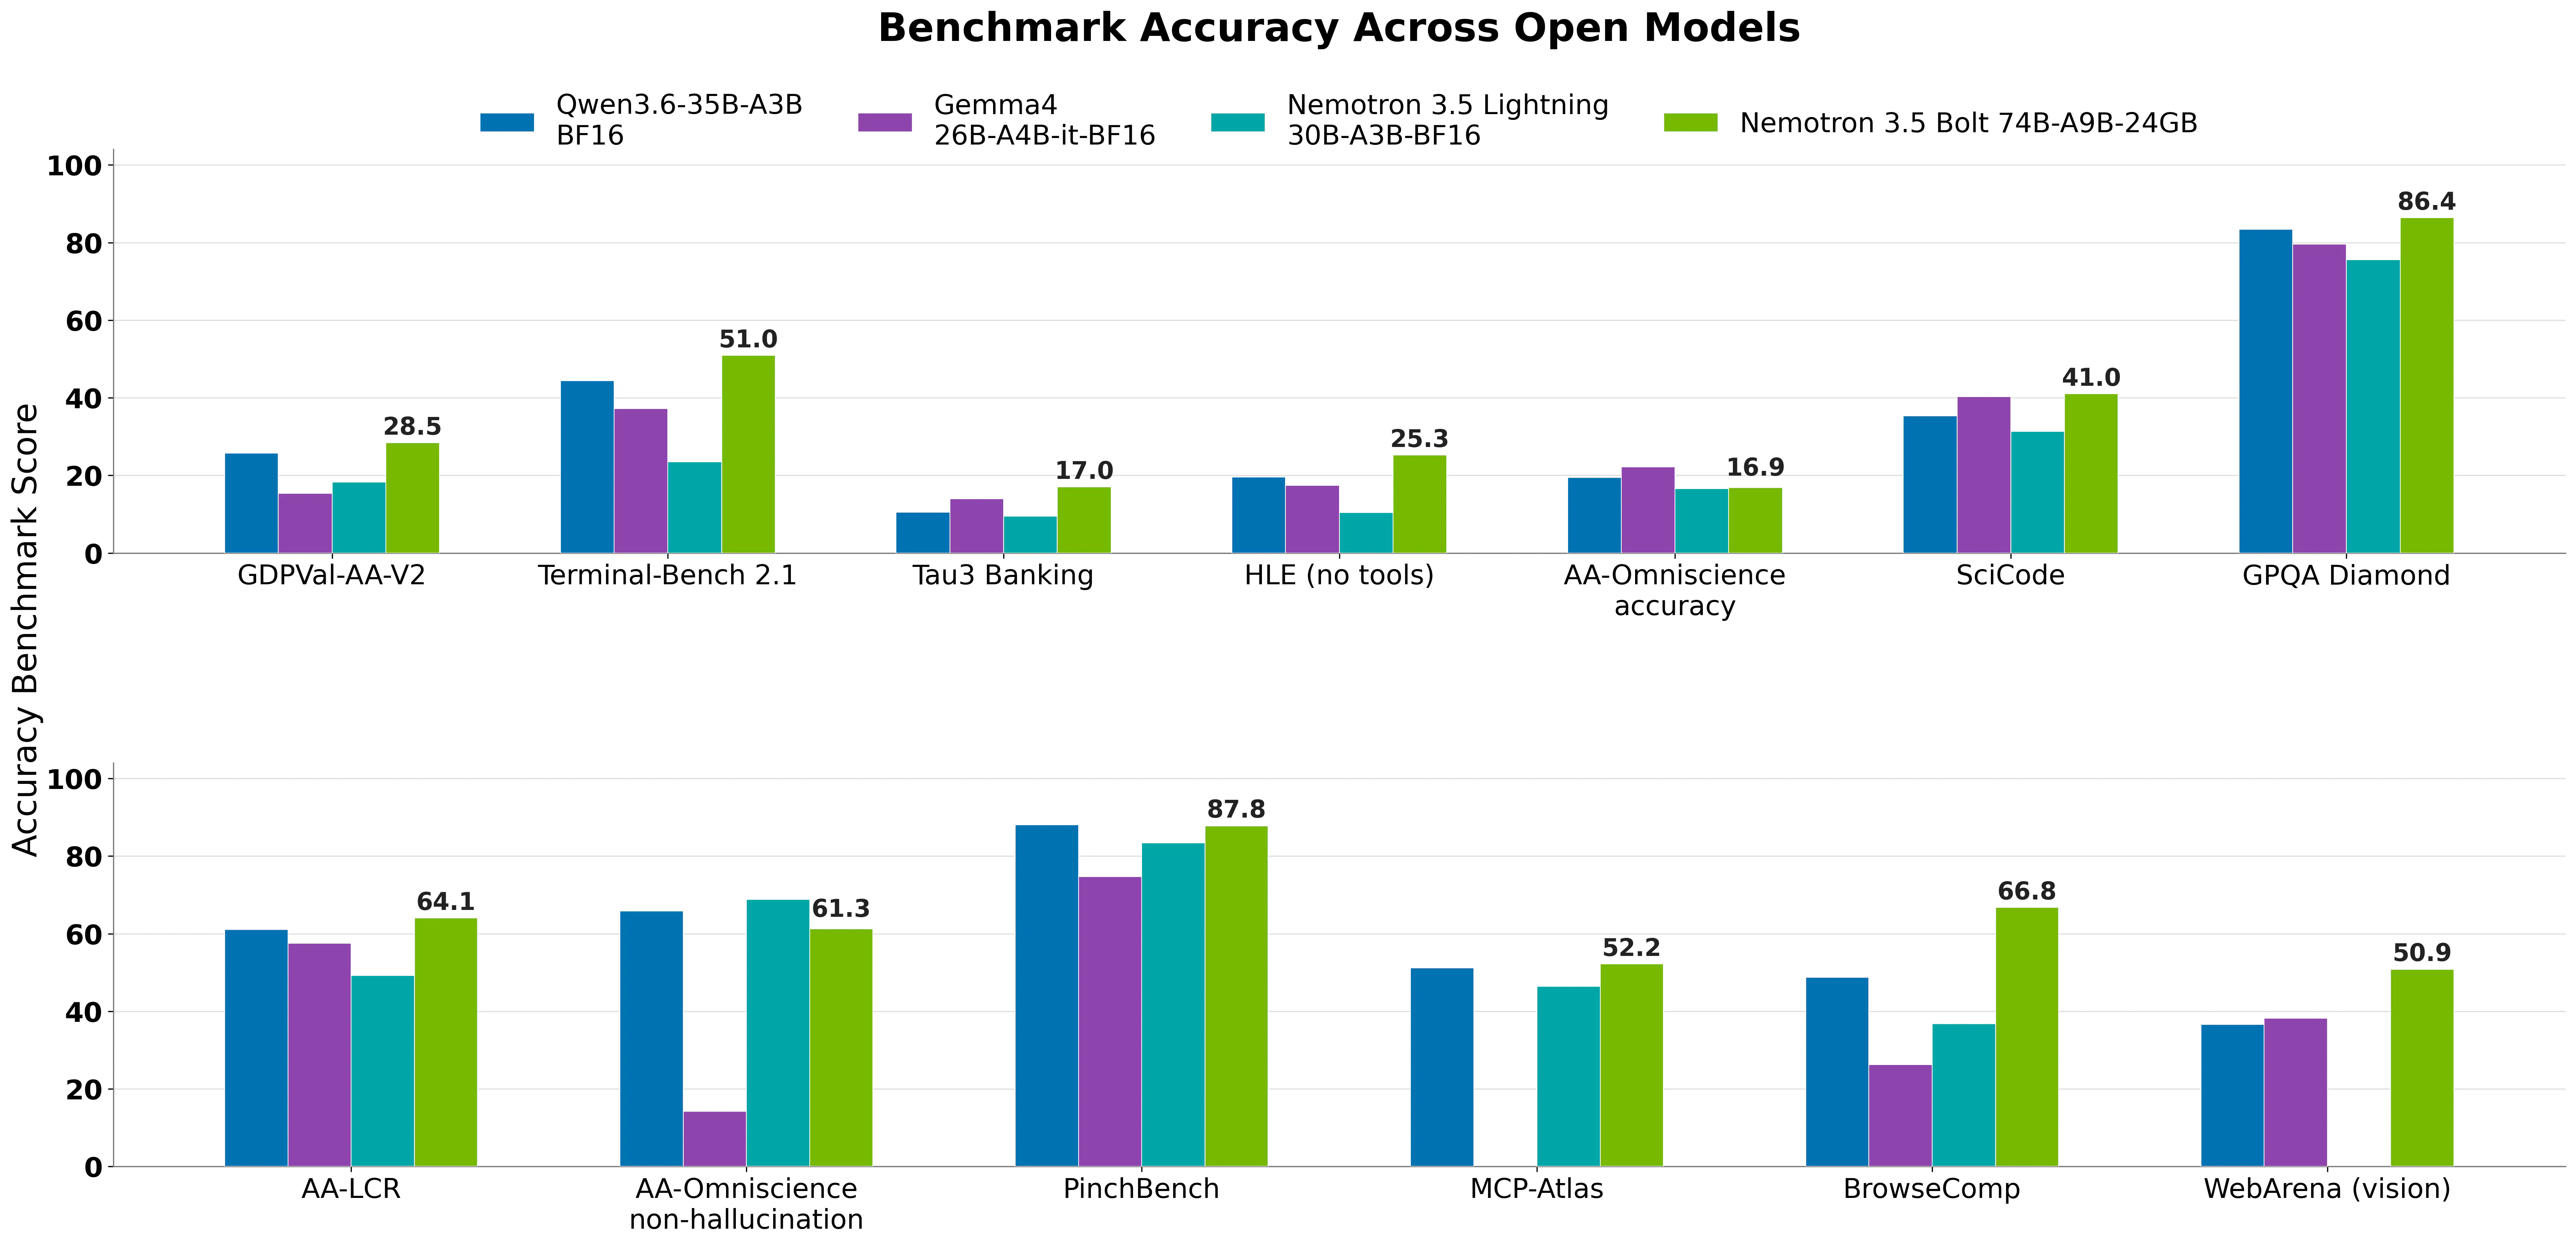
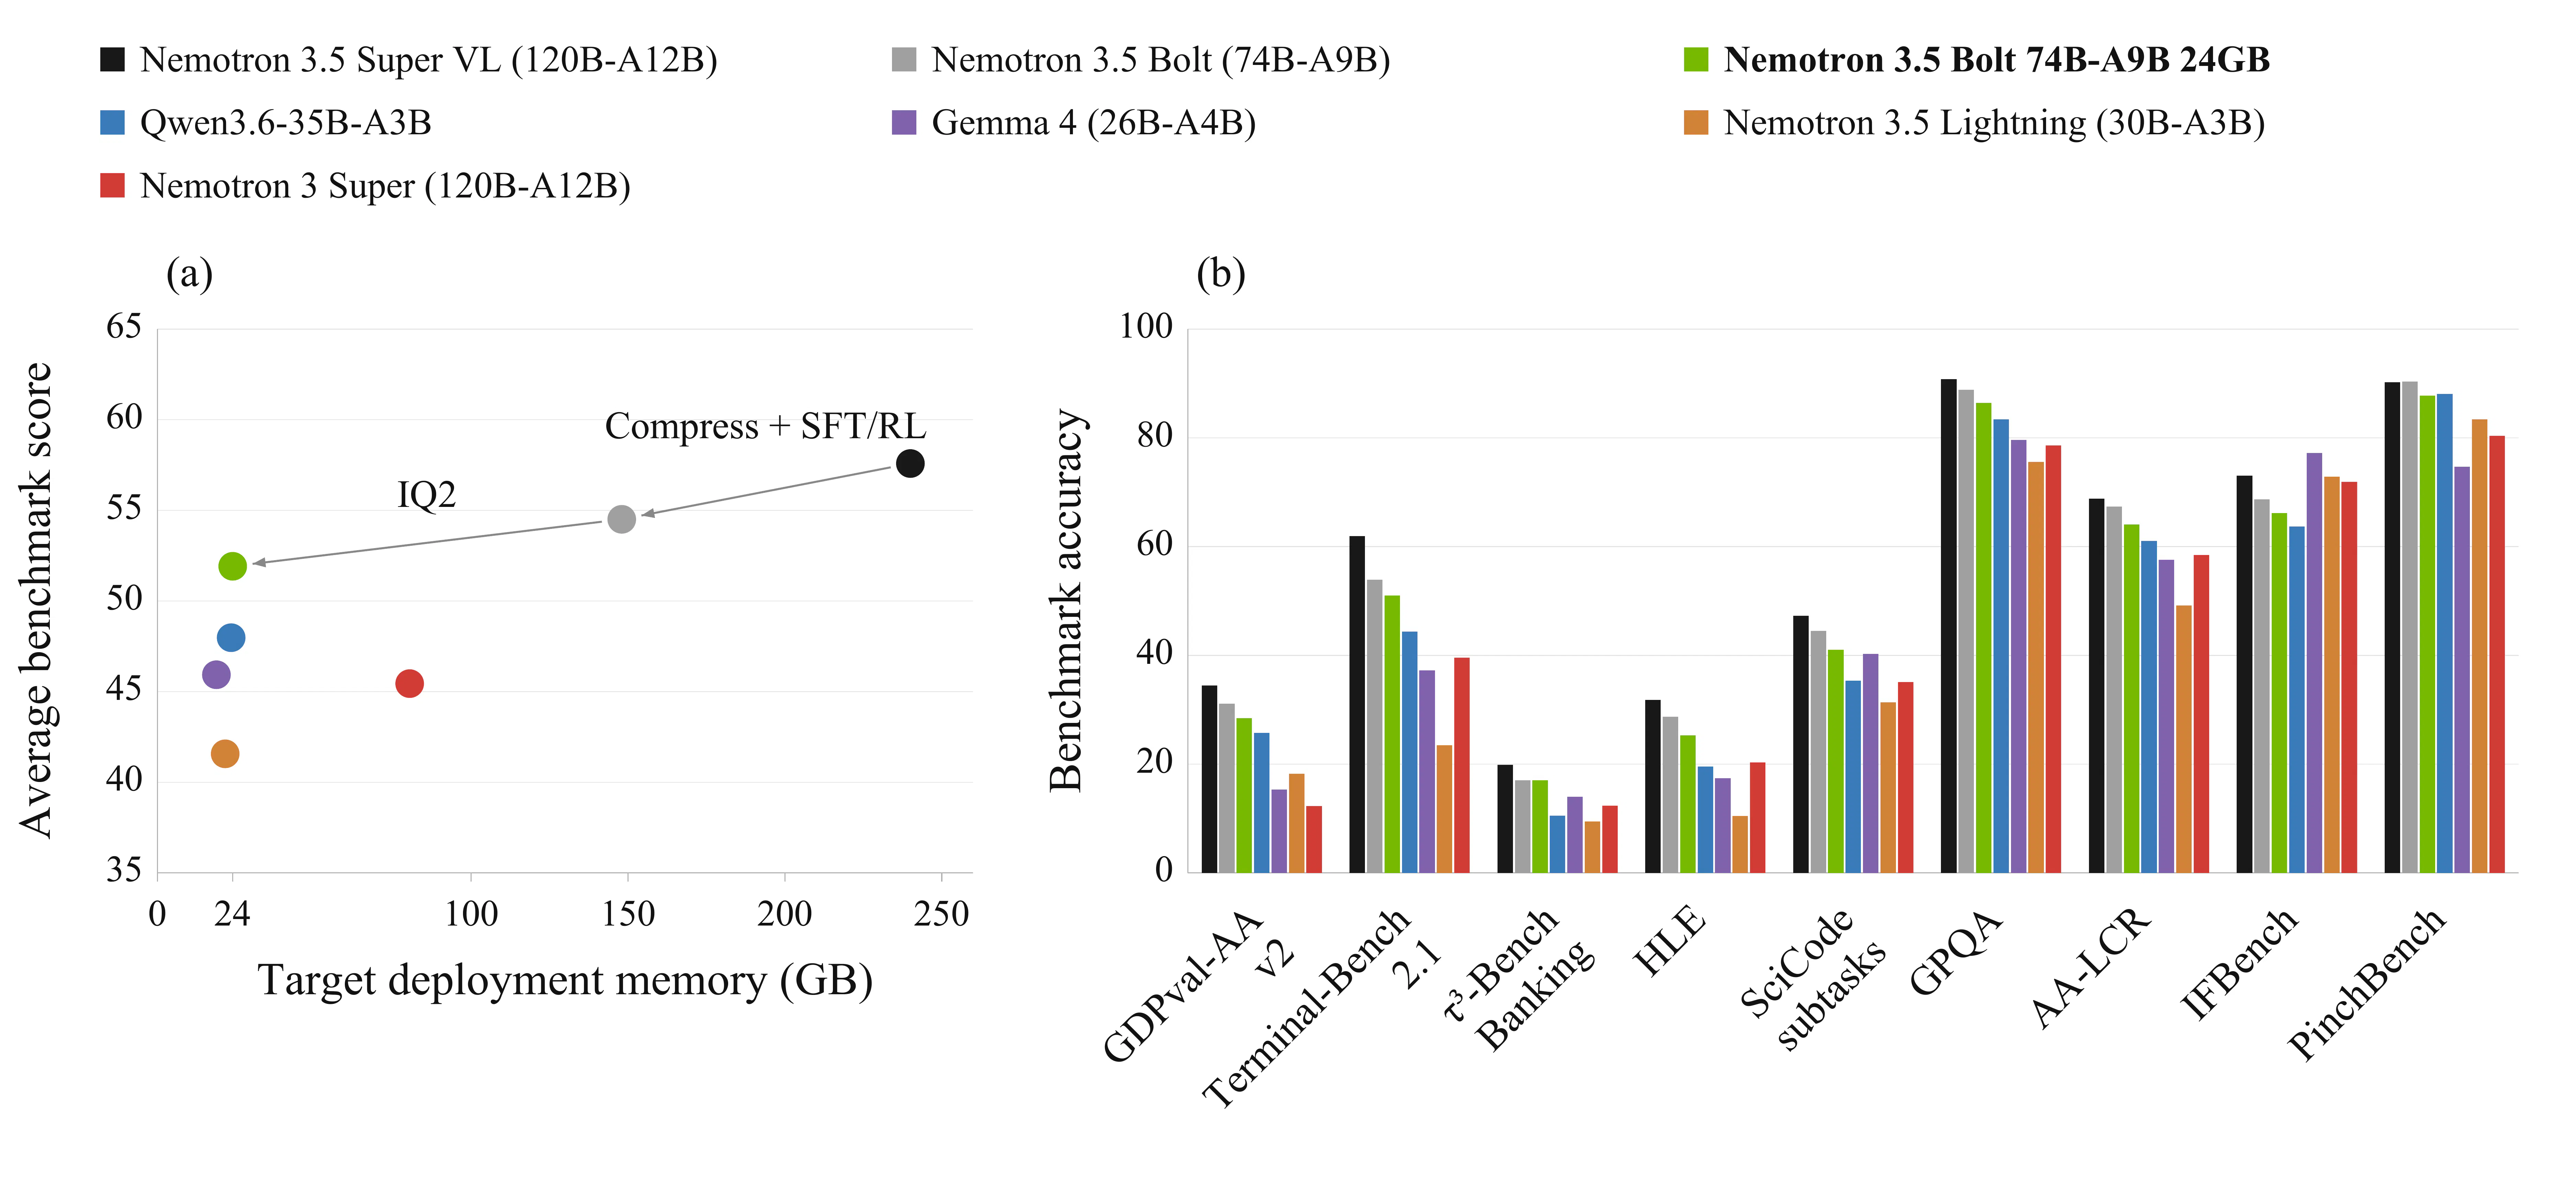
Nemotron 3.5 Bolt 24GB 是 NVIDIA 推出的轻量化模型,专为在 24GB 显存的 RTX 和 DGX Spark 硬件上本地运行日常智能体任务而设计。它基于 Nemotron 3.5 Super VL 压缩而来(从 120B 总参 / 12B 活跃参降至 74B 总参 / 9B 活跃参),在 RTX Spark 上可达每秒 84 token 的生成速度,并同时支持文本与视觉理解。该模型的检查点、GGUF 文件以及推测解码草稿模型均已发布在 Hugging Face 平台。