
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
经济学里的杰文斯悖论认为:一种资源的使用效率越高、单位成本越低,它的总消耗量往往不降反升。当前,大模型行业正被这个定律演绎得淋漓尽致——模型越便宜、速度越快,调用量就越呈现爆发式增长。
而最近席卷硅谷的新物种 Jev,与杰文斯悖论同名的“大模型”,正把这套攻势推向极致。
它拒绝为你写诗、拒绝跟你探讨人生,甚至连一句完整的废话都不屑于生成。但就是这样一个冷酷的“哑巴”模型,发布不到 48 小时,就在 X 上引发了超 3000 万的狂热围观,吸引了 2.5 万名开发者涌入内测;上线大模型托管平台 Vercel 的 24 小时后,近 13% 的付费团队火速接入——这个渗透速度,是当年 GPT-4 的两倍。
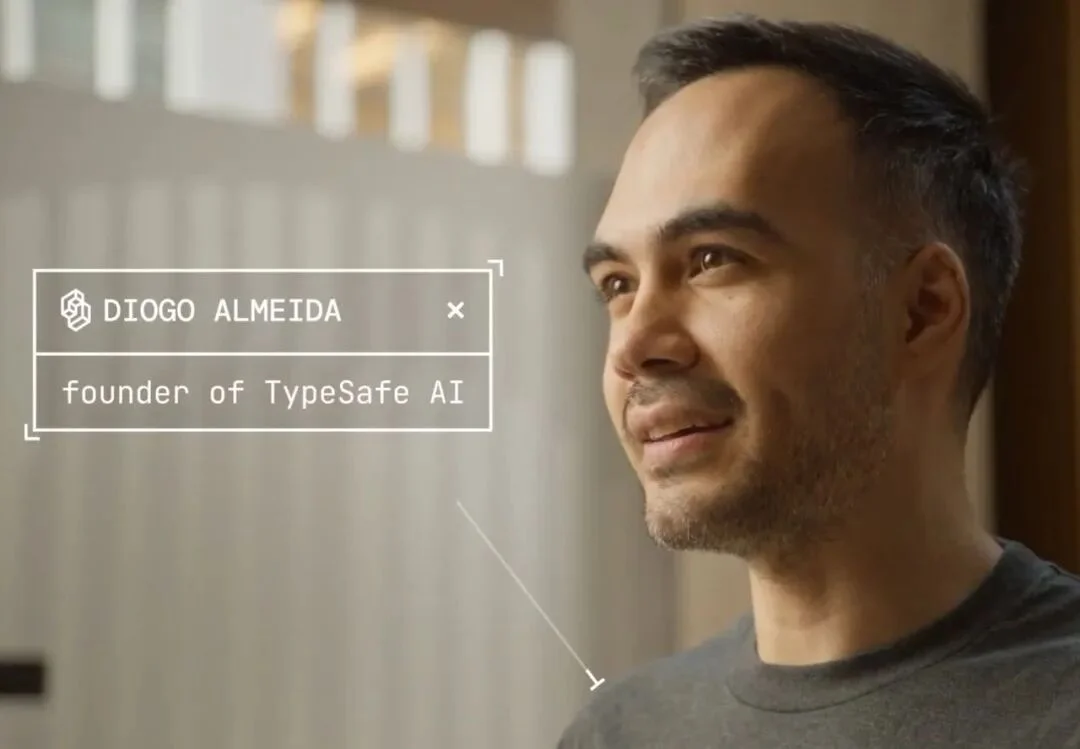
天下武功,唯快不破。Jev 的杀手锏亦是如此:极速,且极度便宜。作为前 OpenAI 核心研究员、RLHF 技术的共同发明者,Jev 创始人 Diogo Almeida 甚至放出豪言:“下一个时代并不属于 Claude Code 这种辅助工具,Jev 才是未来!它比通用模型快 200 倍,便宜 400 倍,而且零幻觉。这将是继 RLHF 之后的 next big thing。”
从毫秒级响应的浏览器插件,到高频执行的链上交易决策,再到每秒 10 次决策、吊打人类玩家的《毁灭战士》的通关外挂,开发者围绕 Jev 打造的应用案例呈井喷之势。
然而,面对这样一个估值一夜之间飙至 2 亿美元、却至今将训练方案与底层权重捂得严严实实的“黑箱”,业界的好奇心与质疑声也达到了高潮:它到底是模型架构革命,还是被营销包装的“分类器”(Classifier)?
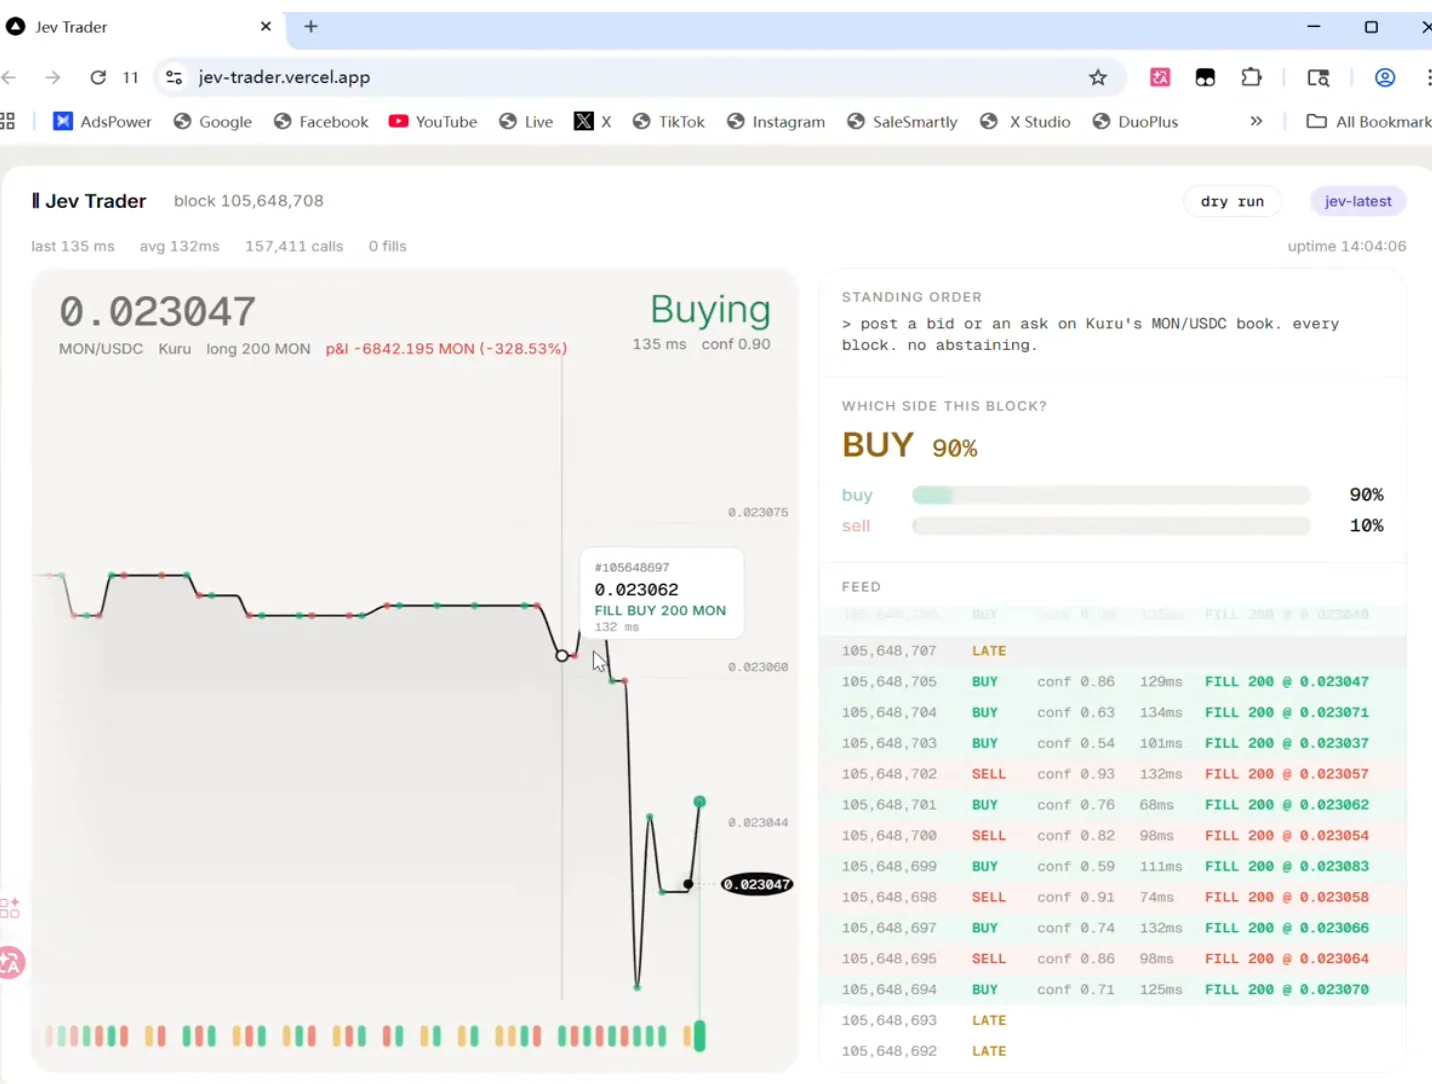
开发者把 Jev 接进 Monad 链上交易系统,模型每 0.3 秒即可读取一次盘口并完成一次买卖决策
就在昨日上午,国内人工智能企业 APUS(麒麟合盛)旗下 AI 实验室,公开了全球最早一批针对 Jev 的独立开源复现成果,并将其封装为开箱即用的 Agent Skill fast-browser-use。该项目支持纯本地模型离线执行,横跨 macOS、Linux、Windows 三大桌面与服务器操作系统,甚至无需独立 GPU,在普通 Mac 和 PC 上也能本地跑通。
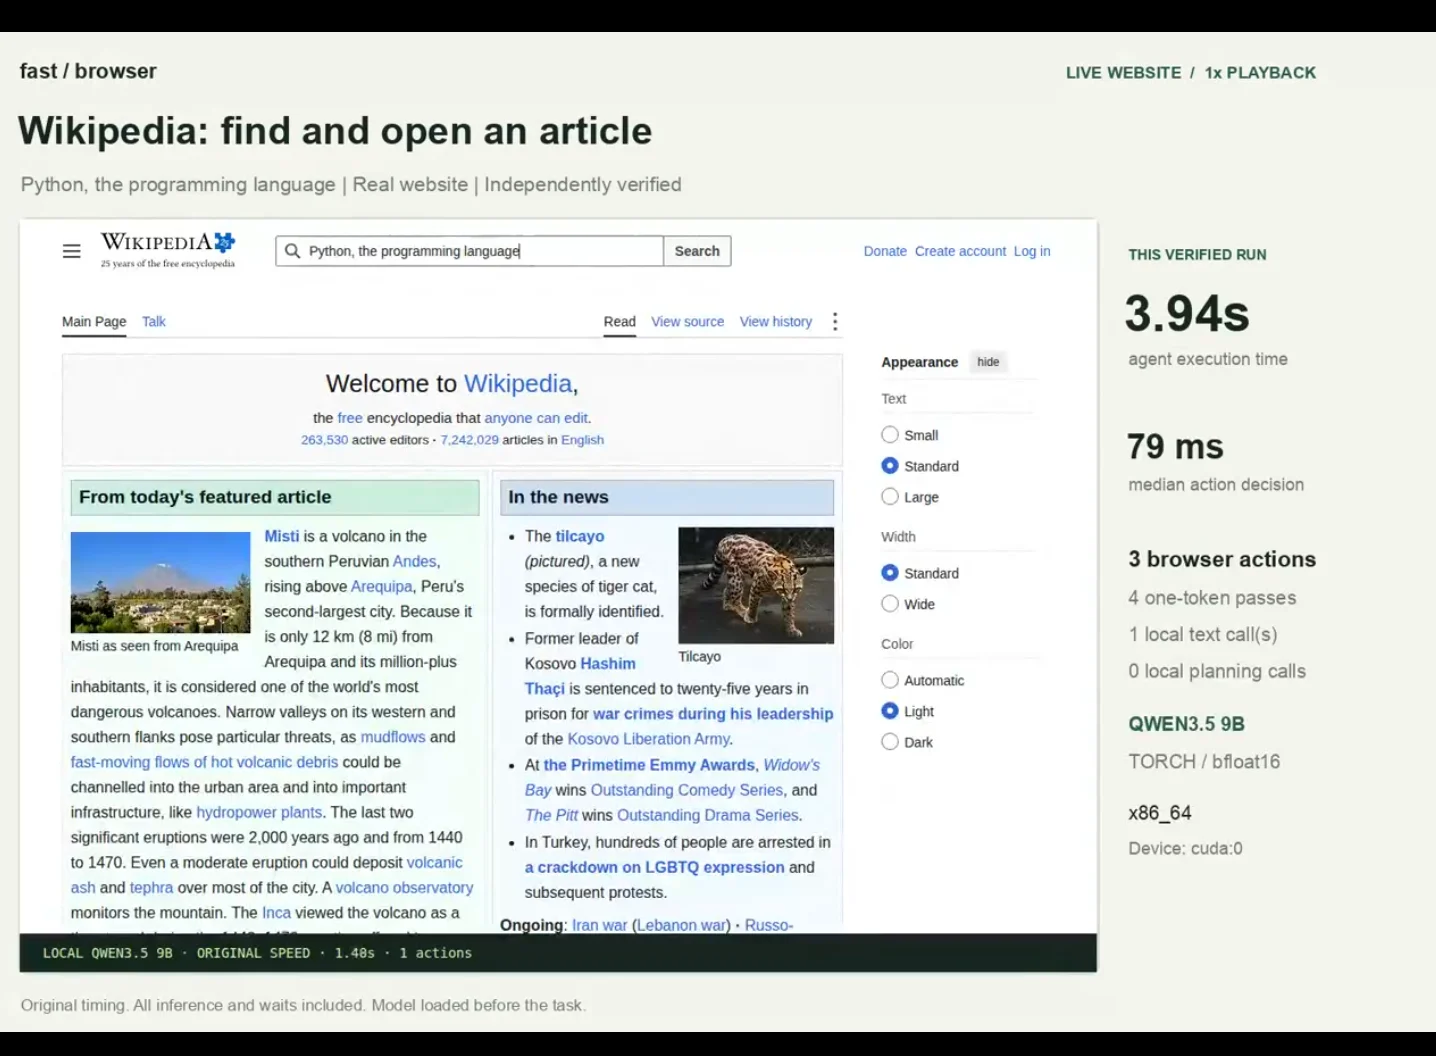
目前,该项目完整代码已通过 MIT 协议向社区开放 (https://github.com/APUS-AI-Lab/fast-browser-use)。
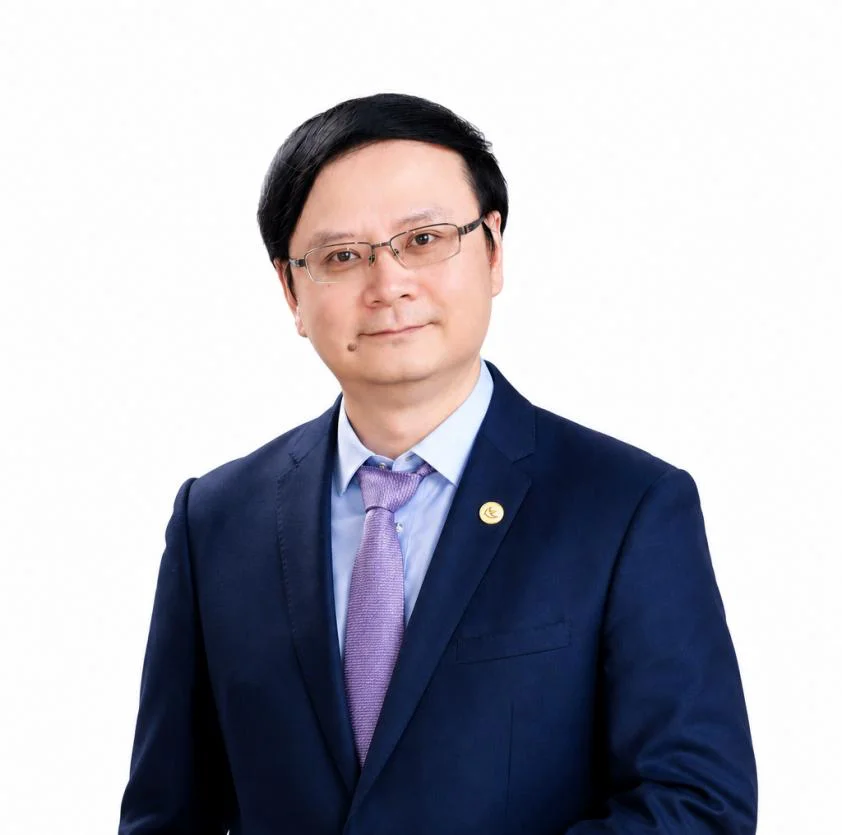
张旭博士,清华大学本硕博连读,工学博士,APUS AI 首席科学家
笔者第一时间联系到了该项目的负责人——APUS AI 首席科学家张旭博士。我们围绕Jev 的底层技术逻辑和路线、APUS 的复现与改造逻辑,这类快速决策模型的应用潜力,以及 Agent 未来的“快慢分工”趋势等话题进行了详尽探讨。
准确来说,张旭团队并没有拿到 Jev 的模型权重、完整架构和训练方法;而是通过公开资料和实际输入输出反推其工作机制,基于 Qwen3.5 系列、Google Gemma 系列等开源模型还原了 Jev 最核心的工作流,并在推理速度上实现了对标。
开源当天(9 月 20 日)上午 APUS 公布首轮结果:真实浏览器任务里,维基百科检索约 18 秒完成,表单填写、站内跳转等更短链任务则在数秒内完成,全程无需调用云端模型;下午采访,张旭团队把测试迁移到了RTX PRO 6000,单次决策时间压缩到了 79 毫秒,与Jev 响应时间 70~500 毫秒成功看齐。
他还透露,其内部自研模型可实现更小 9B、4B 参数规模复现 Jev 的性能,并将于近期开源。(截至发稿前,已开源https://huggingface.co/apus-ailab/APUS-OpenJev-v1)
以下为笔者与张旭博士的访谈精要。为便于阅读,本文对原始对话进行了提炼与整合。
拆解 Jev 的底层逻辑
AI 前线:如果抛开官方的概念话术,您能不能用更直观的方式解释一下,Jev 和今天常见的大模型到底有什么差别?它本质是什么?
张旭:理解这个问题的关键,在于看透大模型工作的两个基本步骤。第一步是 Prefill,也就是输入处理;第二步是 Decode,也就是自回归生成。
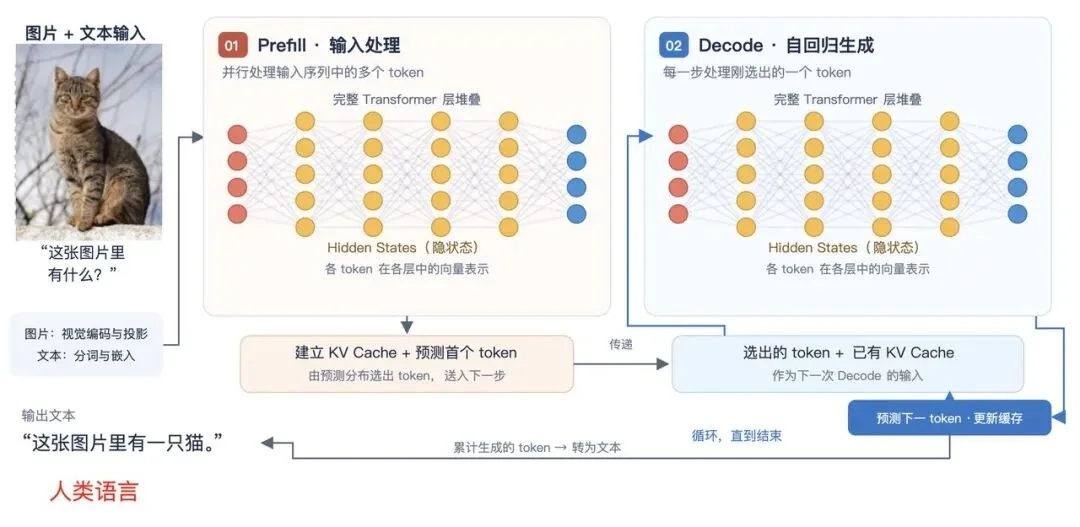
当大模型走完第一步 Prefill 时,它神经网络内部的“隐状态(Hidden States)”其实已经理解了你输入的文字和图片细节。
第二步的 Decode,是一个字一个字往外吐 Token,这一步纯粹是为了“翻译给人看”。
但人类语言的带宽很窄,存在极高的信息损耗。比如这张包含猫、树枝纹理和复杂光影的图片,无论你怎么用文字描述,都不可能毫无遗漏地还原给另一个人。
Jev 的核心本质,就是它砍掉了第二步(Decode),只保留了第一步。它不再为了迎合人类而去逐字生成文本,而是直接在模型理解完信息的“隐空间”(Latent Space)里计算出结果。
AI 前线:那它最后到底输出什么?就是 Choice、Score/概率这类东西吗?
张旭:对。普通大模型每生成一个 Token,本质上都是在十几、二十万词汇的词表里计算全量概率,再选择一个吐出来。
Jev 则是把这个过程极度收敛,变成了对有限选项的概率测算。比如你问“这份提纲完整了吗”,只给“完整”和“不完整”两个选项,它只返回这两个选项的概率得分(Score)。
这也是为什么它说自己不会出现幻觉。并不是说它不会判断错,而是说你只给它 A、B、C,它不会凭空给你编出一个 D。
但不出现幻觉和不出错是两回事。
AI 前线:既然只是给出固定选项的概率,业界有人质疑它只是被包装过的“动作分类器”,您怎么看?它到底新在哪里?
张旭:这么说也没错。但我觉得还要看到它背后更大的研究趋势。
比如一张图片里面包含非常丰富的信息,你不管用多长的文字去描述,都很难把全部细节还原出来。语言本身就会造成信息损失。
所以现在一个前沿方向是:既然模型内部已经有这些信息,我们是不是一定要先把它变成人类语言,再拿语言继续处理?
Jev 可以看成这个方向里的一个具体特例。它把后面的语言生成省掉,直接从模型内部状态里去完成判断。
AI 前线:所以您说的这个更大的方向,具体是什么?就是把“理解”和“生成”进一步解耦吗?
张旭:这是其中一个方面。行业里会把更大的一类思路叫作隐空间计算。
比如两个 Agent 之间通信,它们都不是人,为什么一定要把第一个 Agent 脑子里的信息翻译成人类语言,再让第二个 Agent 读一遍?理论上可以直接在模型内部状态之间做处理。
模型路由、Agent 之间通信、模型内部思考,都可以沿着这个方向做。Jev 只是拿这个思路去做了一件具体的事情:有限选项的概率判断和决策。
AI 前线:作为行业共识,那目前头部大厂在这方面的探索进展如何?Jev 的做法和他们有什么不同?
张旭: 是的,比如 DeepSeek-v4.1 Flash 版本,就已经在尝试把 Prefill 和 Decode 的能力解耦。更典型的代表是目前最新的 GPT-6(Astra),业界探讨的 Loop Transformer 机制,其本质就是让模型的思维链和思考过程,在“隐空间”内部进行循环计算,而不再转化为低效的人类文字吐出来。
对比而言,Jev 则是把隐空间计算的成果,讨巧地“产品化”了,它说明,把隐空间的中间结果直接拿出来用,已经足以颠覆当下的应用形态。
AI 前线:Jev 最明显的特点就是快。除了省掉长文本生成,它为什么还能快这么多?
张旭:不生成文本是最大原因,因为相当于“只吐第一个 Token”,只做判断。但除此之外,还有计算维度的降级。
第二个,原来是开放式生成,现在你给它的可能只有几个、几十个候选,计算范围更小。
第三个,这些候选之间相互独立,可以更多地并行判断;而传统的自回归生成前后有依赖,每一个 Token 都要等前一个。
我们自己的实现里也做了类似 KV Cache 广播这样的处理。所以总结下来就是:少生成、候选范围更小、还能并行。
AI 前线:那除了速度,它还有什么本质上的性能优势吗?
张旭:其他方面在我们看来,它跟大模型没有本质区别。它其实也就是一个大模型,只是只用了一半。
效果好不好,最终还是取决于模型本身训练得好不好。
如何复现 Jev
AI 前线:Jev 没有开源权重、完整架构和训练方案。在这种情况下,你们所谓的“复现”,严谨来说复现的是什么?
张旭:严谨来说,我们复现的是它的功能。
我把他们所有公开资料都看了一遍,也研究了创始人的背景,再自己实际调用 Jev,看它的输入和输出。
可以理解成我把它当成一个黑盒。如果我可以实现相同类型的输入、相同类型的输出,那我们认为基本复现出了它公开出来的功能。
AI 前线:那你们在千问上具体做了什么改动?
张旭:原版的 Qwen3.5 就可以。
模型本身不用改,主要是在外面的工作方式上处理。这次开源的东西,也是从我们公司已有的 Agent Harness 里抽了一部分出来,再精简以后放出来。
AI 前线:那是不是随便拿一个小模型也能跑?对底座模型能力、参数规模有没有要求?
张旭:这个实际测试以后还是有要求。
我看到开源社区有人拿五六亿参数模型复现,确实能跑起来,“能用两下”,但你会发现它很傻,没办法真正实用。
所以我自己把千问从小模型一路往上试。最后看下来,9B 基本上是最低的可用门槛,再小就很难实用;35B 效果会更好。选 9B 也是因为希望普通网友自己的电脑就能运行,不需要特别好的设备。此外,我们也在训练自己的模型,很快也会开源,初步看已经超过了 Jev 的效果。
AI 前线:这次复现有没有什么超出你预期的结果?比如原来以为很难,做完以后发现其实没那么复杂?
张旭:没有特别意外。
反而我们为什么能这么快做出来,就是因为过去在这个方向已经积累了很多,直接把已有的东西拿过来用了。
AI 前线:所以反过来说,你们这么快就复现出来,是不是说明 Jev 目前公开出来的东西,本身并没有特别高的技术门槛?
张旭:更客观地说,它背后还有没有别的东西我不知道。
但至少目前拿出来的部分,在我们看来,就是这个研究领域里的一个特例,没有什么特别神秘的地方。
“79 毫秒”能用在哪
AI 前线:你们为什么第一时间把复现做成一个 Browser Agent?
张旭:我们第一天先看了行业里大家拿 Jev 做什么,发现最多的就是操作浏览器。
而且我们希望开源出去的东西是有实际用途的,而不是一个技术 Demo 或者玩具,所以先把浏览器这个场景做出来。
以前很多 Agent 操作浏览器,需要让大模型先生成操作代码,再去执行。我们现在是把网页上可以交互的元素先列出来,比如输入框、链接、上下翻页,再让模型直接做选择:现在应该输入、点哪个链接,还是翻页。
后来模型本身已经做到毫秒级以后,我们统计发现,完整任务里大部分时间反而花在等网页加载、等网页刷新。
AI 前线:那你们为什么长期会往本地模型、CPU、小算力、模型路由这些方向走?这些看上去是很多单点技术,背后的逻辑是什么?
张旭:核心还是 AI 普惠。
我们一直在想,模型能不能不用很昂贵的 GPU,靠 CPU 也能有一个可以接受的速度和效果。因为绝大多数普通用户不会在电脑里装 5090,更不可能买 H100、B200。
如果 AI 最后真的要进入大规模 C 端产品,全部推理都依赖中心化大算力,本身会是一个限制。所以我们希望把一部分计算分散出去,分到 CPU 服务器,甚至分到用户手机上。
这也是我们做模型解耦、路由、本地推理这些事情背后的共同逻辑:用更高的性价比,让 AI 真正能够大规模普及。
AI 前线:如果不只看浏览器,这种模型还能用在哪里?
张旭:其实能落的场景很多。
比如我们经常会访问到一些网站上显示大量的广告、欺诈信息、杂乱的内容,那么浏览器有了这个能力加持,就可以快速筛选和过滤。
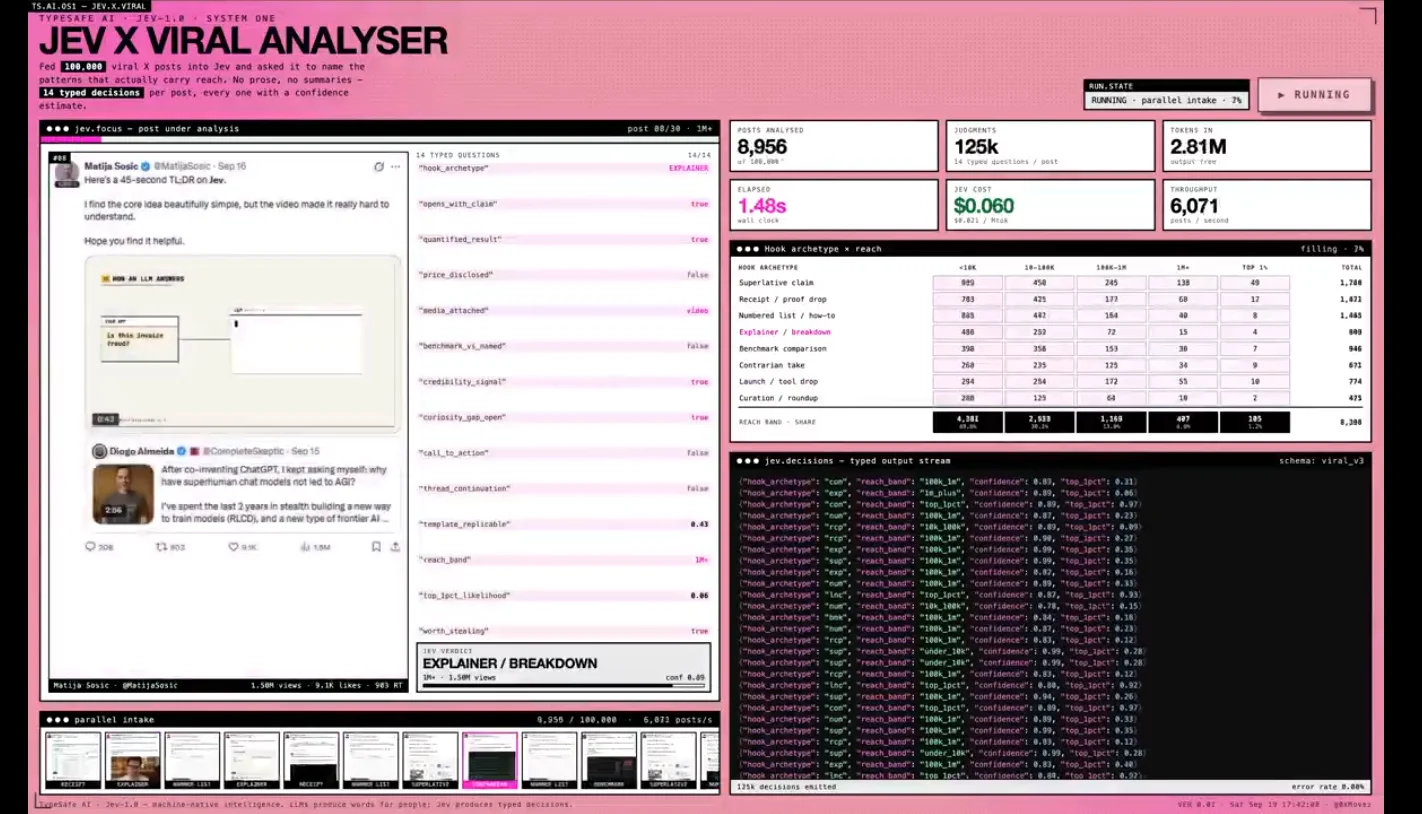
开发者 Movez 基于 Jev 分析了 10 万条 X 帖子,耗时仅为 20.4 秒,花费 0.67 美元
推荐系统也是很典型的场景。A 文章用户感兴趣的概率是多少,B 是多少,再把概率高的内容推荐出来。
我还看到有人拿它批量审文档,因为很多判断可以并行,所以一次处理上千份文档,速度和成本会有优势。
AI 前线:现在也有人拿 Jev 做炒股、交易。它因为决策快,会不会特别适合这一类场景?
张旭:快不代表它炒股水平高。
炒股最后还是看模型本身的智力水平,以及有没有针对金融这个方向做优化。Jev 现在应该没有专门针对这个方向优化。
所以不能因为它能很快做决策,就认为它一定能赚钱。
AI 前线:那再往长远一点看,还有什么你觉得值得关注的应用?
张旭:更长期可能会到工业自动化、智能家居这些领域,因为它们都需要很快做出行动。
现在不是已经有人拿 Jev 玩游戏了吗?
它能玩游戏,其实就能够操控机器人。
Agent 走向快慢分工
AI 前线:决策变得这么快以后,下一个挑战会在哪里?
张旭:一个很明显的问题,就是智力。
过去为什么大模型会吐很长的思维链?因为它要靠这些过程提升数学、编程、推理等复杂能力。
现在你把这部分砍掉,它就更依赖模型的“直觉”、第一反应。如果问题本身比较复杂,需要多步思考,那 Jev 当前的智力水平可能就不够。
AI 前线:也就是说,它更适合规则比较清晰、候选明确的任务;如果需要真正复杂推理,就会出现准确率问题?
张旭:对。复杂问题本身就可能超出它现在的能力。
AI 前线:为什么 Jev 一出来,开发者会这么兴奋?快思考、慢思考这套思想其实并不新鲜,去年 OpenAI、DeepSeek、Qwen 都尝试在基座模型里融入这套逻辑。
张旭:对,快思考和慢思考本身不是新东西。
以前很多模型也说自己有快模式、慢模式,但所谓“快”,本质上仍然是大模型一个 Token 一个 Token 生成,只是思维链短一些。从普通用户体验上看,它其实并没有真正快到像“本能”。
Jev 为什么火,我觉得一个原因就是,它真的快到足够实用了。以前那个“快思考”,其实也不快。
AI 前线:但这是不是意味着它没有办法单枪匹马完成一个长链条 Agent 任务,还是需要和完整的大模型配合?
张旭:我认为是两个类型互相需要。
比如机器人,如果所有操作都让大模型慢慢想,很难实用化。它一定需要一些非常快的模型去执行动作。
复杂任务规划、逻辑推演可以交给慢模型,而高频、原子化、环境交互类动作,就适合交给这种受限决策模型。
AI 前线:那快思考和慢思考,最终有没有可能重新融进同一个模型?
张旭:完全有可能。
系统一、系统二首先是一种架构设计思想。可以是两个模型,也可以一个模型承担两个角色。
通用模型厂商以后完全可能把长生成那部分屏蔽掉,提供一个快速决策模式。
但分成不同模型以后,每个模型可以更专注,也可能效率更高。最终要看是不是一家公司能够把整个生态都吃下来。
AI 前线:长远来看,Agent 和模型到底是什么关系?模型越来越强,会不会最终把外面的 Harness 都吃掉?
张旭:我认为不会。
可以打个比方:模型是发动机,Harness 是汽车的控制系统,Agent 是整辆汽车。
发动机可以越来越强,但你不会因为发动机越来越强,就不要轮子、方向盘和控制系统。所以大模型会越来越强,但它本质上还是Agent 里的驱动系统。
文章来自于微信公众号 “InfoQ”,作者 “InfoQ”


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
