
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
一片树林里分出两条路,而我选了人迹更少的一条。
最近一段时间,社媒上被一个 Jev 模型刷屏了。
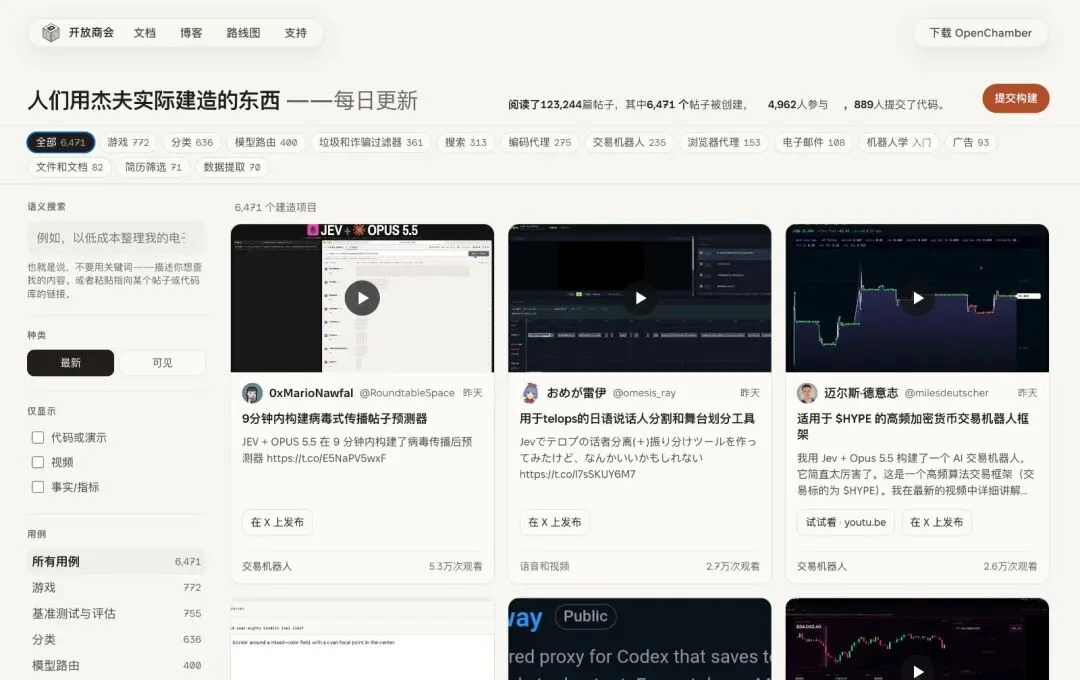
在 jev.openchamber.devg 上,关于 Jev 的应用,已经聚集了 6000 多个作品:有人用它搜航班,7 秒跑完整个流程,成本不到 0.004 美元。还有人让它同时跑 50 场《地铁跑酷》,速度快到像开了挂。
Jev 的创始人 Diogo Almeida 之前在 OpenAI 工作,他参与过让语言模型学会遵循指令的研究,那些工作后来成了 ChatGPT 的基础。
而这次,他创造的 Jev 走了一条几乎没人走过的路,做的事情跟我们熟悉的大模型完全不同。
Jev 的模型所属的类别「System One」,这个命名来自 Daniel Kahneman 的《思考,快与慢》。
Kahneman 把人类的认知分成两个系统:系统 1 是快速、自动、直觉式的,你看到一张愤怒的脸立刻知道对方在生气,不需要分析。系统 2 是缓慢、费力、需要集中注意力的,你算一道复杂的数学题,得一步步推导。
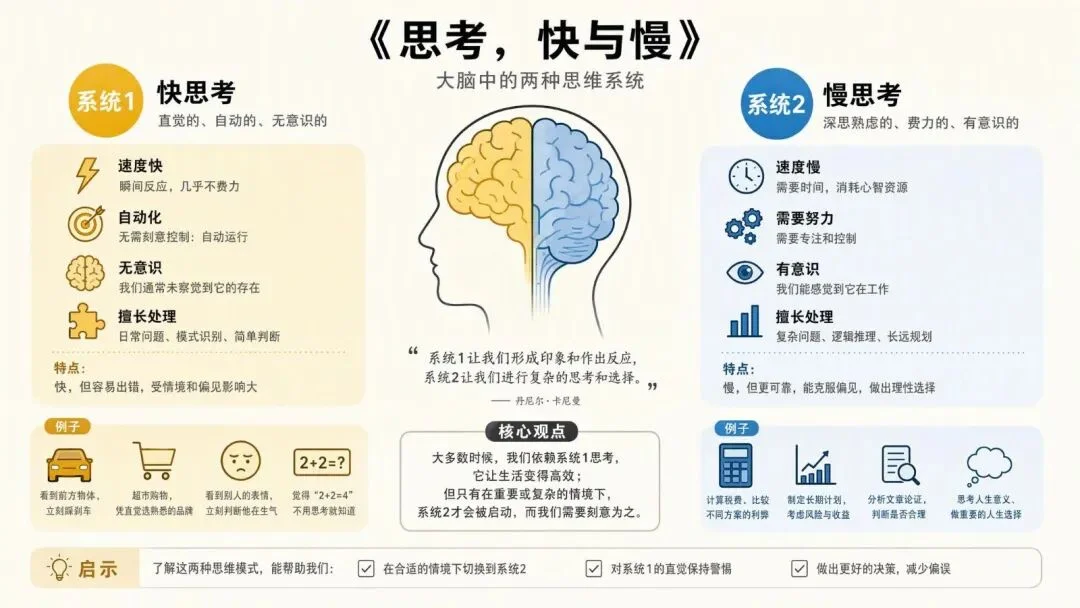
现在的大语言模型,尤其是加了推理能力的那些,走的是系统 2 的路线。它们逐个 Token 生成,一步一步思考,追求的是深度和准确性,代价是慢和贵。
而 Jev 走的是系统 1:它不逐 Token 生成,而是并行采样,一次性输出所有概率。
除此之外,它不生成文本,不写代码,不跟你聊天。它只做一件事:做决策。你给它一堆非结构化的信息,再给它几个预定义的选项,它从里面挑一个最合适的,然后把结果连同置信度一起返回给你。
整个过程 70 到 500 毫秒,输出 Token 的成本低到官方直接标注「免费,太便宜不值得计量」。
日常工作中有许多任务,本质上就是在做选择题:
比如分类任务:这封邮件是不是垃圾邮件?或者路由任务:这个用户请求应该路由给哪个客服?又或者评分任务:这段文本的情感倾向是正面还是负面?
这些任务的共同点是:你不需要模型洋洋洒洒写一大段话,它只需要一个快速、准确、带置信度的判断。
而 Jev 之所以能实现这些任务,是因为它放弃了字符串生成能力。它不会写文章,不会编代码,甚至不会说一句完整的话。
作为交换,它获得了几个能力:极快的速度、极低的成本、零类型错误、以及校准过的置信度。
官方给出的数据是:在同等智能水平下,Jev 比前沿模型快 40 到 200 倍,便宜两个数量级。输入 Token 的价格是每百万 0.042 美元,大约是 GPT 系列的百分之一。
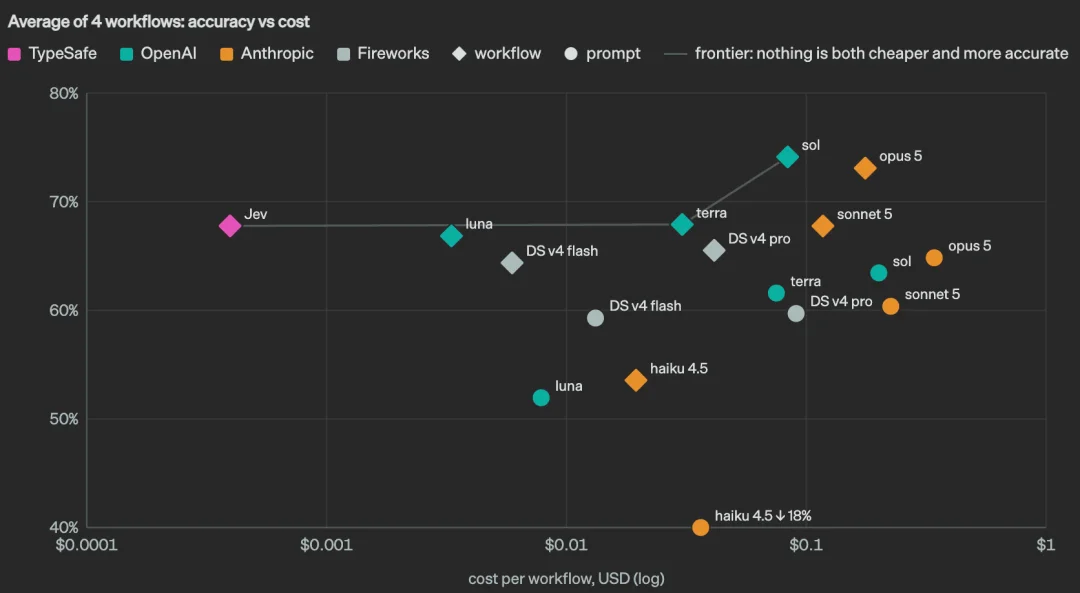
Jev 的处理方式,有什么特别的呢?
它的输入是一段话,输出是一段概率,并且非常快。
以一个用户退款的场景看,假设用户的输入是这样的:
用户留言:你们这个会员自动续费也不提醒一下,直接扣了我 88 块,我要退款!
那么经过 Api 封装后的完整请求是这样(一般需要给定预设的分类,然后让 Jev 进行判断):
POST https://tokendance.space/gateway/typesafe/v1/systemone
Authorization: Bearer sk-9f18…9f
{
  "model": "bocha-jev-v1",
  "state": "用户留言: 你们这个会员自动续费也不提醒一下,直接扣了我 88 块,我要退款!",
  "questions": {
    "q1": {
      "type": "noul",
      "instructions": "这段话带有负面情绪吗?",
      "criteria": {
        "true": "有负面情绪",
        "false": "无负面情绪"
      }
    },
    "q2": {
      "type": "choice",
      "instructions": "这段话的主要意图?",
      "criteria": {
        "咨询": null,
        "投诉": null,
        "退款售后": null,
        "闲聊": null
      }
    },
    "q3": {
      "type": "score",
      "instructions": "处理的紧急程度?",
      "criteria": [
        "不紧急",
        "一般",
        "较紧急",
        "非常紧急"
      ]
    }
  }
}
而 Jev 的输出,则长这样:
{
  "model": "bocha-jev-v1",
  "answers": {
    "q1": {
      "type": "noul",
      "noul": 0.9829739332199097
    },
    "q2": {
      "type": "choice",
      "probabilities": {
        "咨询": 0.007551450747996569,
        "投诉": 0.6349058151245117,
        "退款售后": 0.35735565423965454,
        "闲聊": 0.00018711277516558766
      },
      "confidence": 0.6349058151245117,
      "choice": "投诉"
    },
    "q3": {
      "type": "score",
      "probabilities": {
        "0": 0.048316895961761475,
        "1": 0.20446832478046417,
        "2": 0.36562931537628174,
        "3": 0.3815854787826538
      },
      "confidence": 0.3815854787826538,
      "score": 2.080483391880989,
      "legend": {
        "0": "不紧急",
        "1": "一般",
        "2": "较紧急",
        "3": "非常紧急"
      }
    }
  },
  "usage": {
    "input_tokens": 573,
    "output_tokens": 0
  },
  "metadata": {
    "inference_ms": 25.823,
    "cuda_graph_enabled": true,
    "checkpoint_status": "experimental",
    "calibrated": true,
    "confidence_definition": "maximum candidate probability; not guaranteed correctness"
  },
  "_elapsed_ms": 275
}
这样的模型,可以做什么呢?
让我们来看几个爆火的 Jev 应用:
第一个是 browser-use 团队做的航班搜索。
传统的浏览器 Agent 怎么工作?截图,用视觉模型识别页面元素,决定点哪里,执行操作,再截图,再识别。每一步都要等模型生成一段文字描述,再从文字里解析出动作指令。
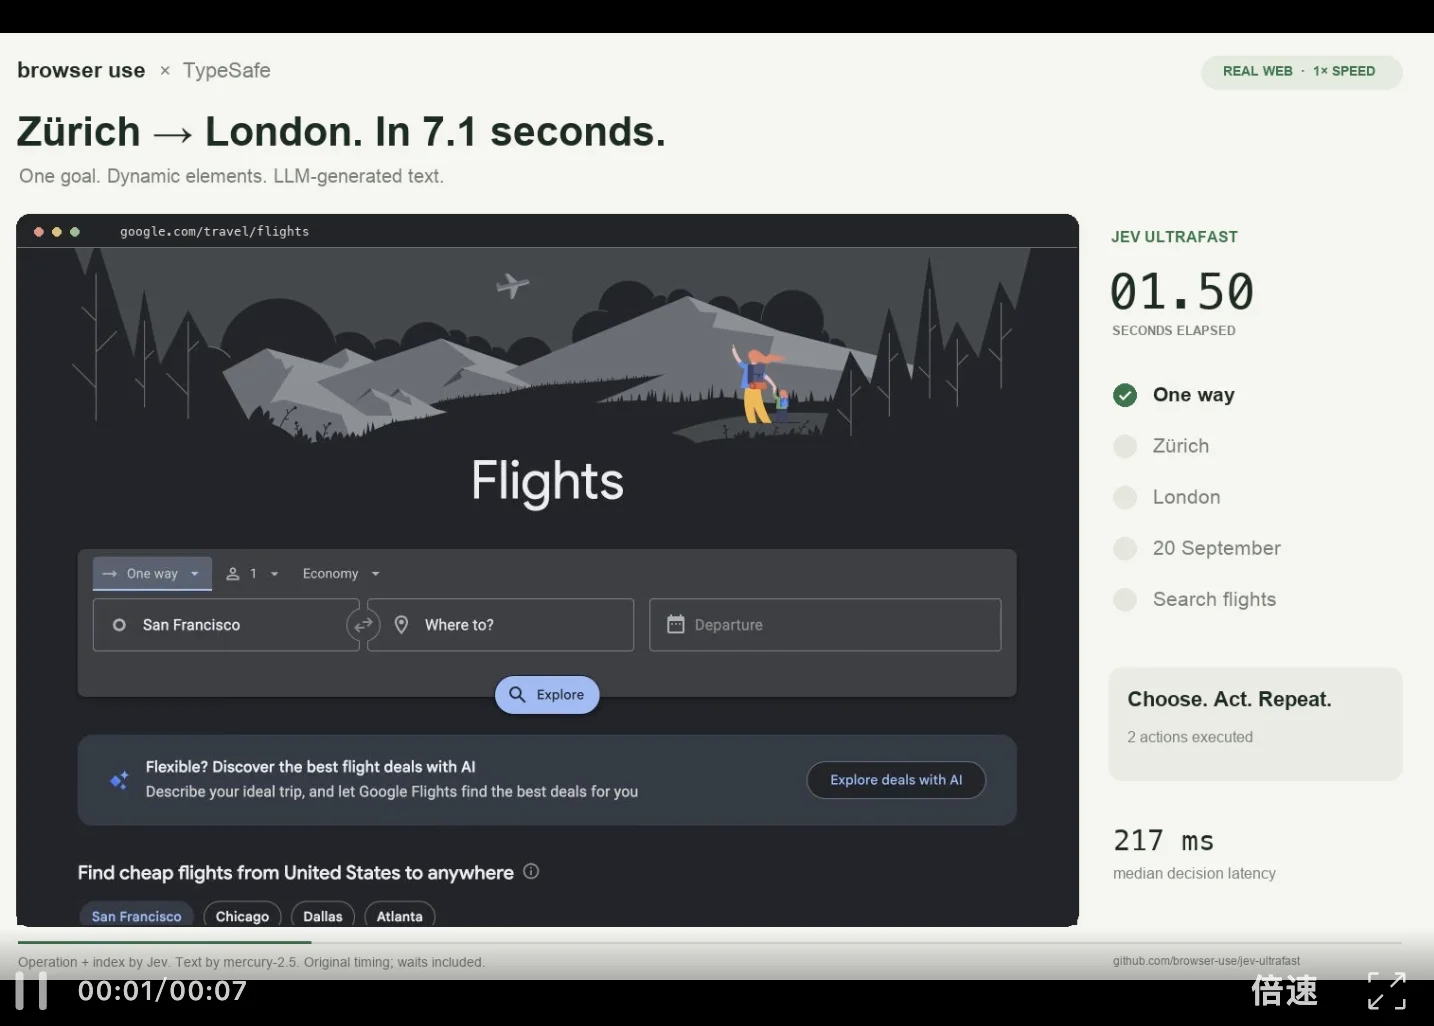
整个流程下来,搜一个航班可能要一两分钟。
而 Jev 全程不截图,不用视觉模型,它可以用一段轻量的 JavaScript 把当前页面里所有可交互的元素,提取成一张结构化的表格,标签名、ID、文本内容都列好,然后把这张表连同用户目标一起交给 Jev。
Jev 从这些元素里选一个去点击或填写,程序执行完毕后再提取新的元素表,再让 Jev 选。
用它在 Google Flights 上搜航线,8 次表单操作,总耗时 7.1 秒,仅花了 0.0039 美元。
第二个案例更有意思。
有个开发者叫 Toran Bruce Richards,他把 Jev 接到了一个驾驶模拟器的原始控制系统上:
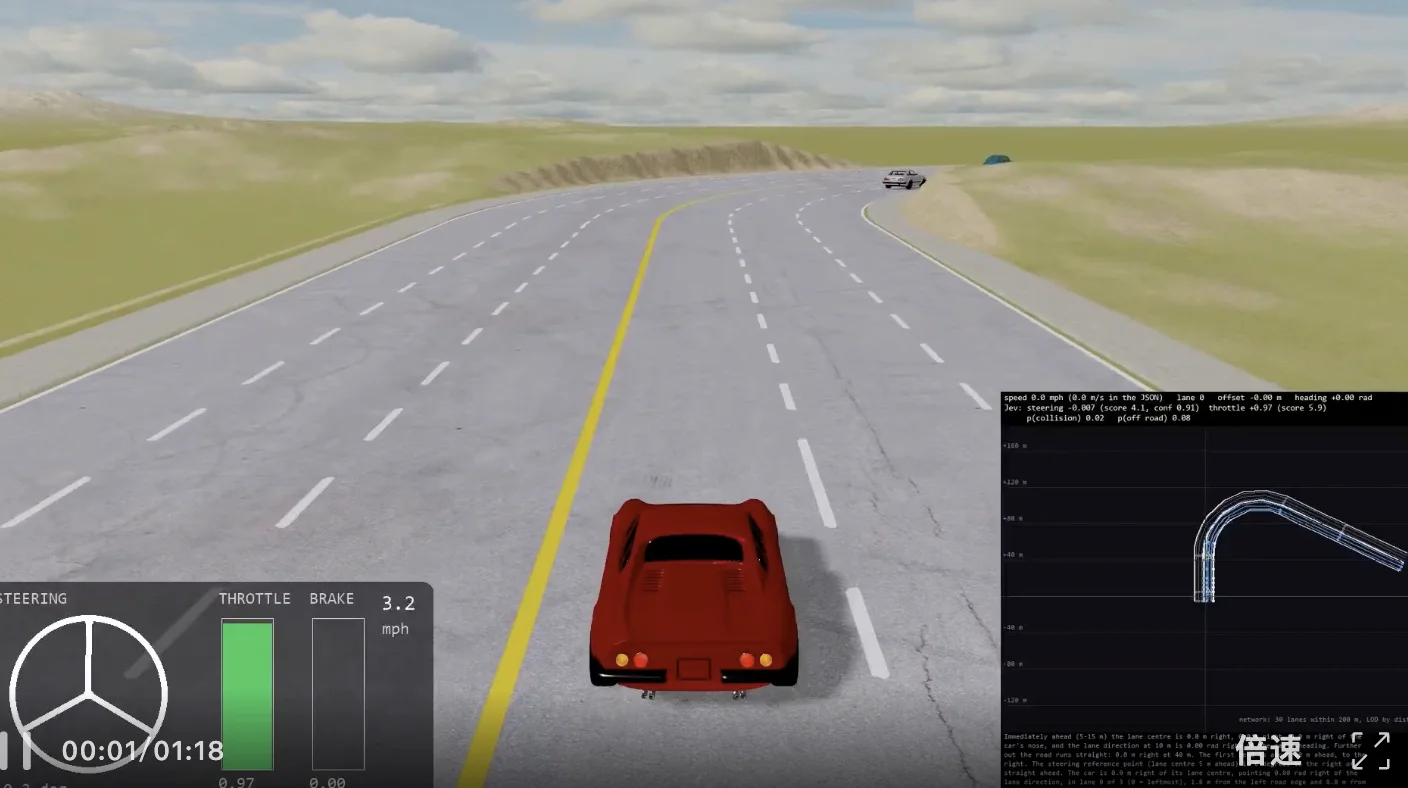
每 50 毫秒一个决策循环:程序把车辆状态发给 Jev,Jev 从「加速、减速、左转、右转、保持」这些选项里选一个,程序执行。已经接近人类的反应速度了。
第三个是一个实时股票交易的案例。
X 上的 @milesdeutscher 用 Jev + Opus 5.5 构建了一个 AI 交易机器人,他结合一个高频算法交易框架,实现了股票的实时自动交易。
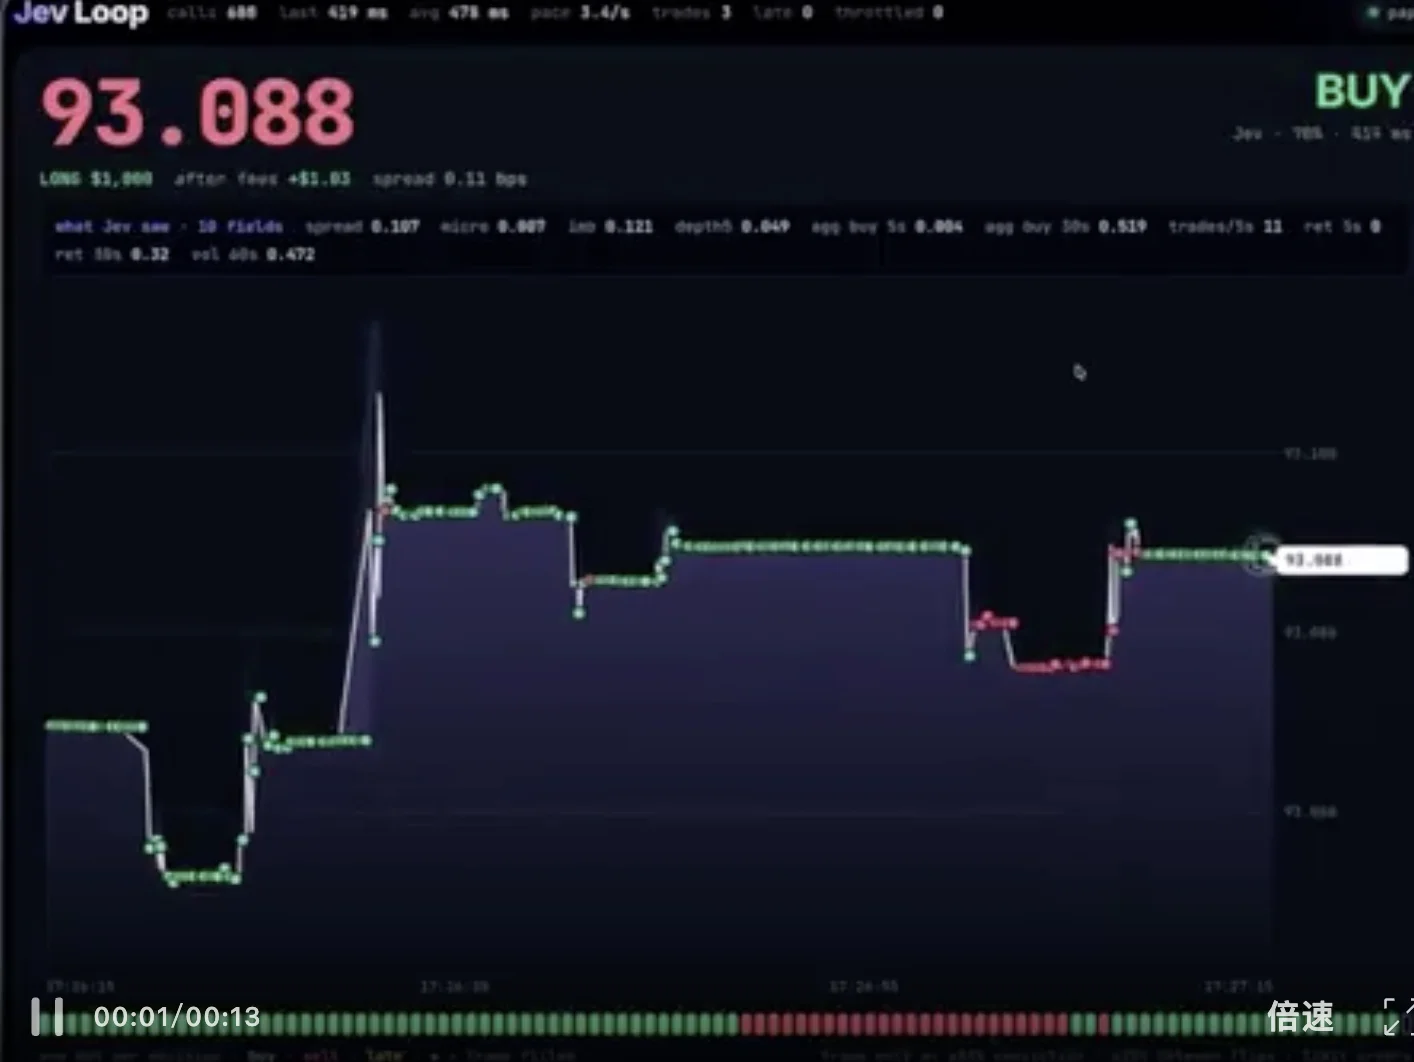
老实说,这也是我第一次见到,一个模型拥有这么多不同类型的案例:从这个意义上,Jev 的发布是一种很新颖的创新。
过去两年,大模型的竞争基本上就是一条赛道:通用智能。
模型越来越大,能力越来越强,价格越来越贵,然后再想办法降价。所有人都在同一条曲线上卷。
Jev 做的事情是跳出了这条曲线,并且垂类模型的训练成本更低,在特定任务上效果更好。
看到 Jev 这个模型,你可能会有一些疑问:
这些事情用大模型也能做啊,为什么以前没看到有人演示?
答案很简单:太慢,太贵。
用 GPT 来判断一封邮件是不是垃圾邮件,技术上完全可行,但你要等 3 到 5 秒,花几分钱。如果你每天要处理 10 万封邮件呢?光是 API 成本就够一个人喝一壶了,更别提用户等不了那么久。
而 Jev 把单次决策的成本压到了万分之一美元量级,延迟压到了 100 毫秒以内,直接把这些使用场景变得可以落地和解锁了。
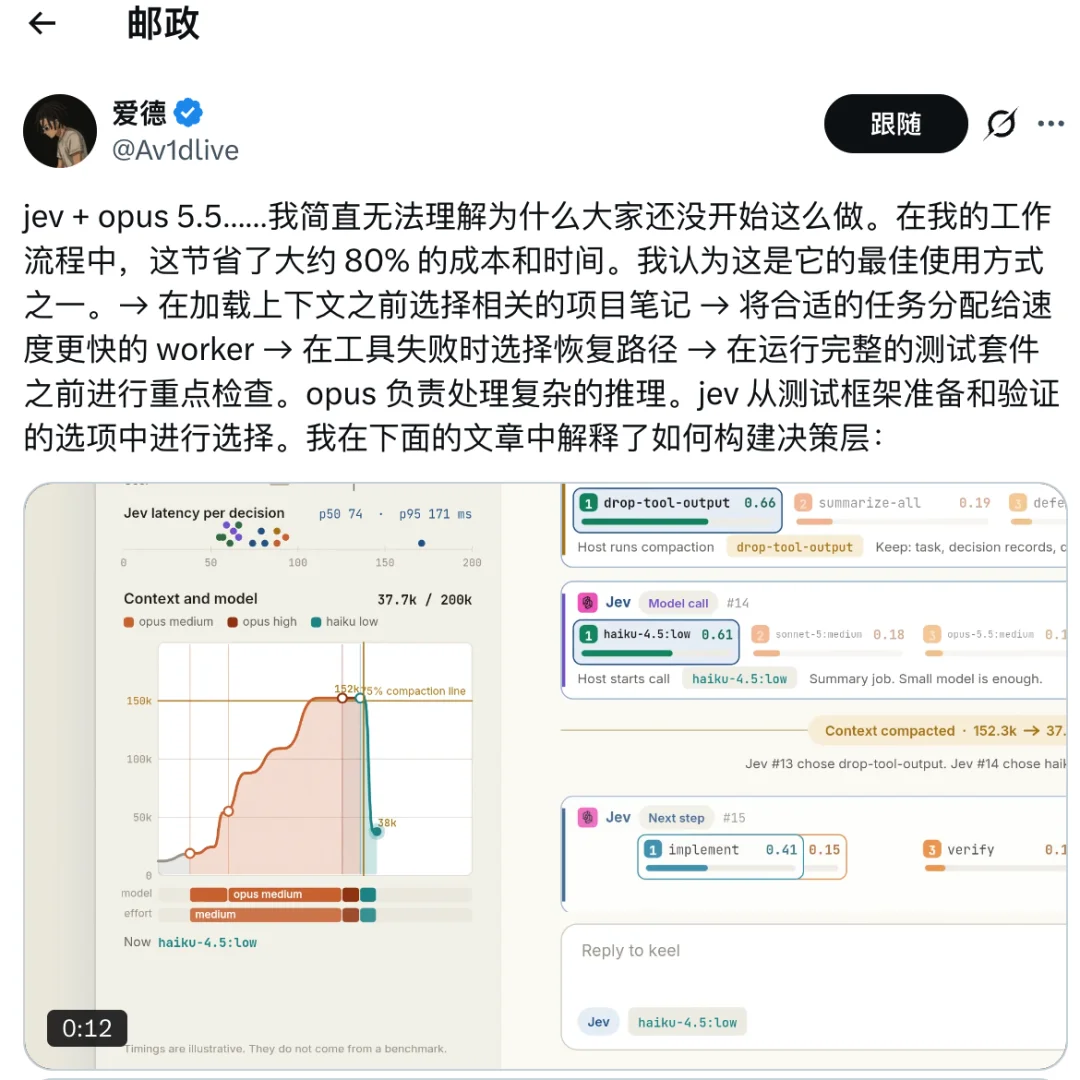
即使未来通用模型在决策任务上追了上来,Jev 在速度和成本上的优势依然存在。这跟各种大模型做 Flash 系列的逻辑很像,基于成熟的大模型蒸馏出更快更便宜的版本:
但 Jev 走得更极端,它直接放弃了生成能力。
这种取舍解锁了一些全新的可能性:
有人用 Jev 自动玩闯关类小游戏,每秒做几十次决策,成本几乎为零。有人根据任务难度做 LLM 自动路由,简单问题交给 Jev 瞬间判断,复杂问题才调用大模型深度推理。
官方博客里列了几类最适合 Jev 的场景:
总的来说,Jev 不是来替代大模型的,它填补的是一个此前被忽视的生态位:
如何通过 AI,实现一些高频、低延迟、结构化的微决策。
Jev 这件事,有一种文艺复兴的味道。
大模型这几年做的事情,本质上是把一切机器学习和自然语言处理的分类、翻译、预测任务都抽象成了同一个任务:
预测下一个 Token。
这种统一性带来了巨大的规模效应,但也意味着所有任务都在为「生成」这个能力买单,哪怕你的任务根本不需要生成。
而当大模型的能力逐渐接近人类,行业开始走回头路了:
不是所有任务都需要系统 2 的深度思考,有些任务天然就是系统 1 的直觉判断。Jev 把这部分需求剥离出来,用一套完全不同的架构去服务,反而做到了更好的效果。
此外,大模型为了提高思维的准确度,发明了思维链、重复提示、自我反思这些技巧,本质上是在用更多的 Token 换更好的结果。而 Jev 为了速度,把这些全部舍弃,用并行采样一步到位。
这也是自 GPT3 发布后,大模型第一次开始从通用回到专精。
Jev 的模型名字取自 William Stanley Jevons,一位 19 世纪的经济学家。他提出过一个著名的悖论:蒸汽机效率提升后,煤炭的消耗量不降反升,因为更高的效率解锁了更多的使用场景。
TypeSafe 团队相信:智能成本每下降一个数量级,就会解锁更多数量级的用例。
而 Jev 的爆火也证明了这件事:当一次 AI 决策的成本从几分钱降到万分之一美元,当延迟从几秒降到几十毫秒,开发者们几乎是本能地开始探索模型的新用法,甚至把 AI 放进之前想都不敢想的地方。
Jev 不会取代 GPT 或 Claude,就像系统 1 不会取代系统 2。
但它让我们看到了一种可能性:大模型的未来也许不只是越来越大、越来越强,也可以是越来越快、越来越专、越来越便宜。
这条新赛道才刚开始。
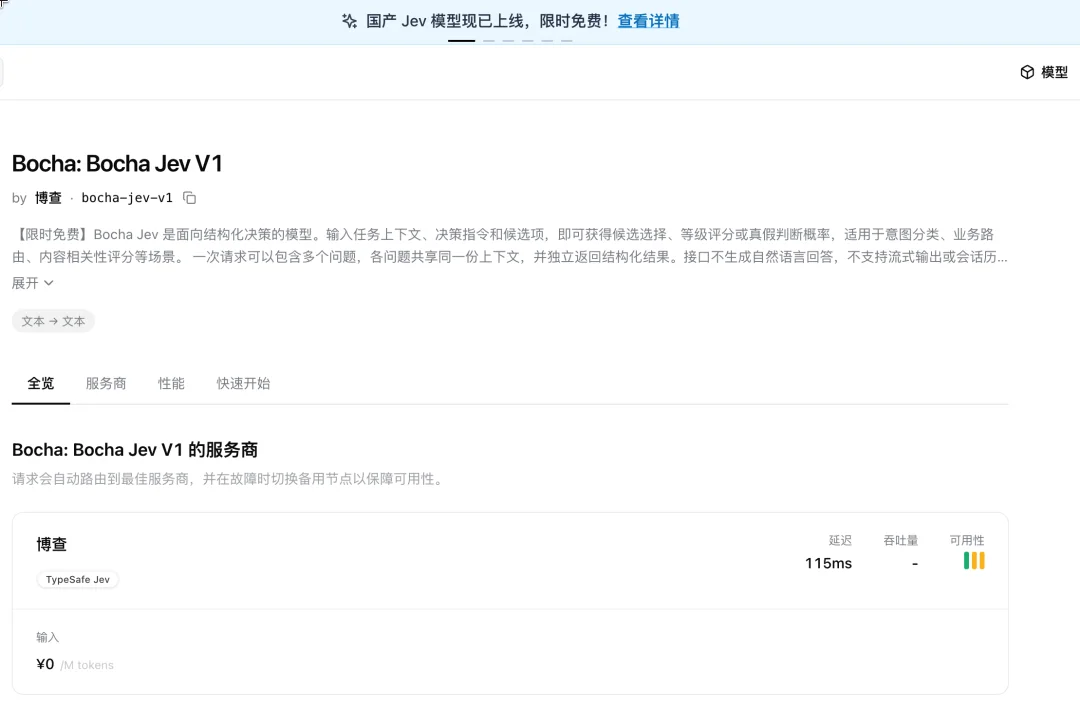
国产 Jev 模型现已在 TokenDance 上线,限时免费!
文章来自于微信公众号 “特工宇宙”,作者 “特工宇宙”


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
