
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
“AI 正在造 AI,却越造越吃力。”
当下,整个 AI 行业正处于“递归自我改进”(Recursive Self-Improvement,简称 RSI)的极度亢奋中。最明显的信号是头部公司接连表态、晒出进展:OpenAI 研究科学家、o1 早期贡献者 Noam Brown 透露,让 AI 做 AI 研究已是 OpenAI 的头号优先级,甚至排在做出“好卖”的模型之前;Anthropic 九成以上的研发任务已有 AI 协作或主导;阿里巴巴在云栖大会上宣称,Qwen3.8-Max 在一个多月的全自动运行中完成 33 轮迭代,Artificial Analysis 评分从 40 提升至 45。
在许多人看来,英国数学家 I. J. Good 上世纪 60 年代设想的“智能爆炸”已近在咫尺:AI 一旦学会改进自己,每一代都会更快地造出更强的下一代,能力可能在几个月甚至几天内“快速起飞”,直冲超级人工智能(ASI)。
就在这股热潮中,前微软合伙人、科技投资人兼作家 Ramez Naam 发表重磅长文,给这场狂热算了一笔清醒的底账。
这位曾以“激进的技术乐观主义”闻名、早在 2011 年就准确预判清洁能源成本“断崖式下跌”的乐观派,如今抛出了一个让人无法忽视的冷酷结论。基于头部 AI 机构内部真实研发数据,结合“递归自我改进”经济学模型与科研幂律,他给出判断:
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
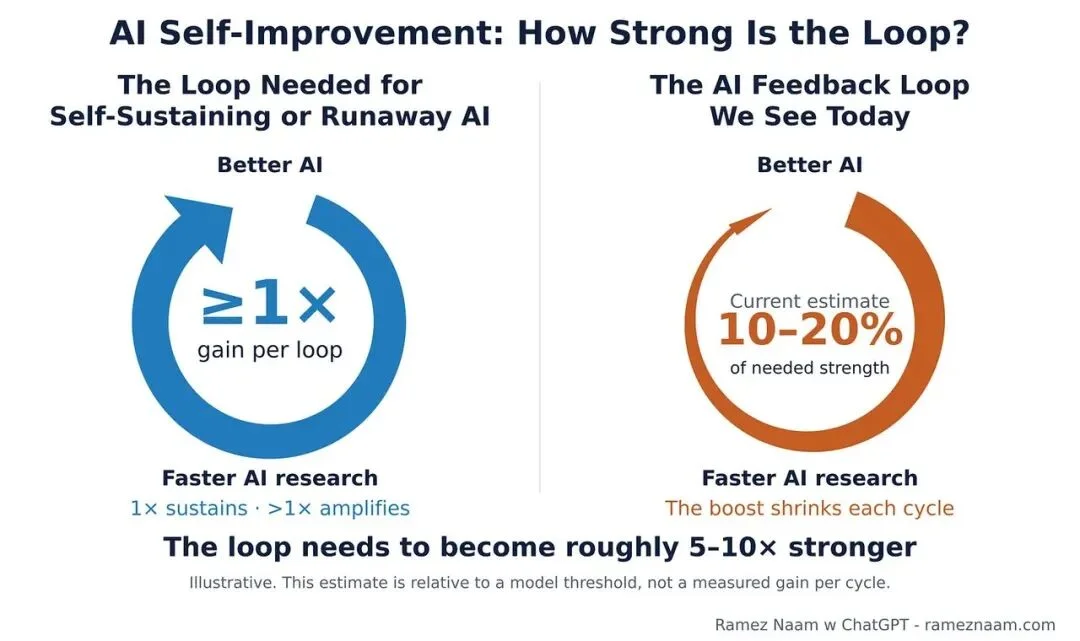
针对上述推演,Naam 从五个维度层层剥开:
以下是这篇长文的深度梳理与重构。
RSI 盲区:自主,不等于智能爆炸
在“自我进化”的喧嚣中,RSI 的边界常被模糊:从 AI 辅助提效,到 AI 自我进化乃至触发超越人类认知的“智能爆炸”,仿佛撤走人类研究员,AI 就能搭上无限加速的列车。
为了理清头绪,Naam 将 RSI 精细拆解为五个相互交叠的类型:
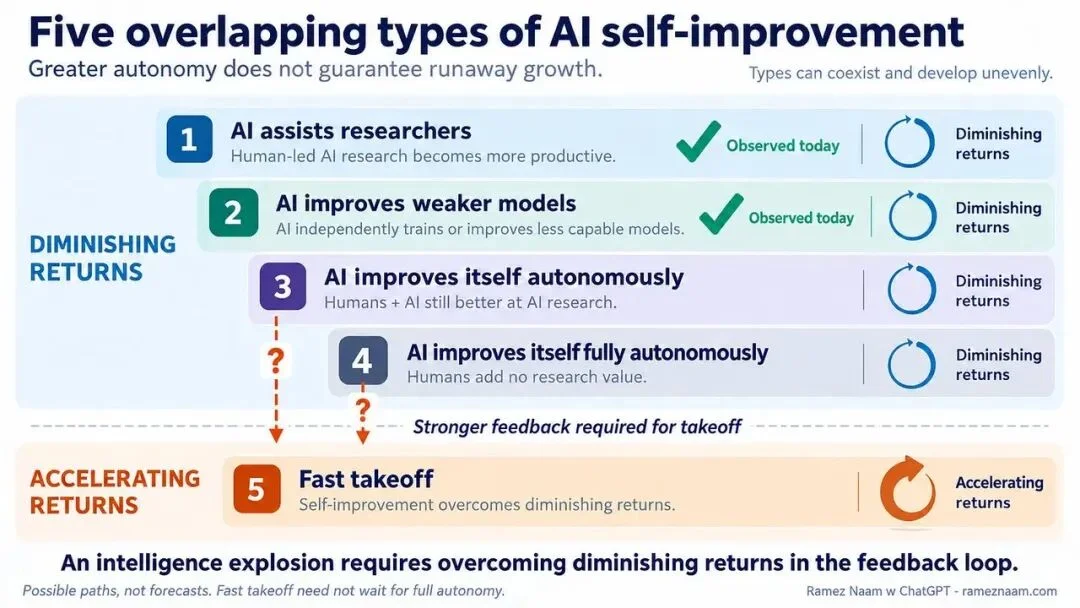
五类未必需要逐级走完,真正决定智能爆炸的,不是 AI 有多自主,而是收益能否不减反增。 Naam 指出,只要无法突破收益递减的铁律,哪怕 AI 完全独立(第四类),每往前迈一步只会比上一步更费力。换言之,AI 能自主,未必能加速智能进化。
宏观账:赌指数爆发,砸出线性回报
当我们将视线从概念拉向宏观大盘,首先迎面而来的是一场严重的“投入产出比错位”。
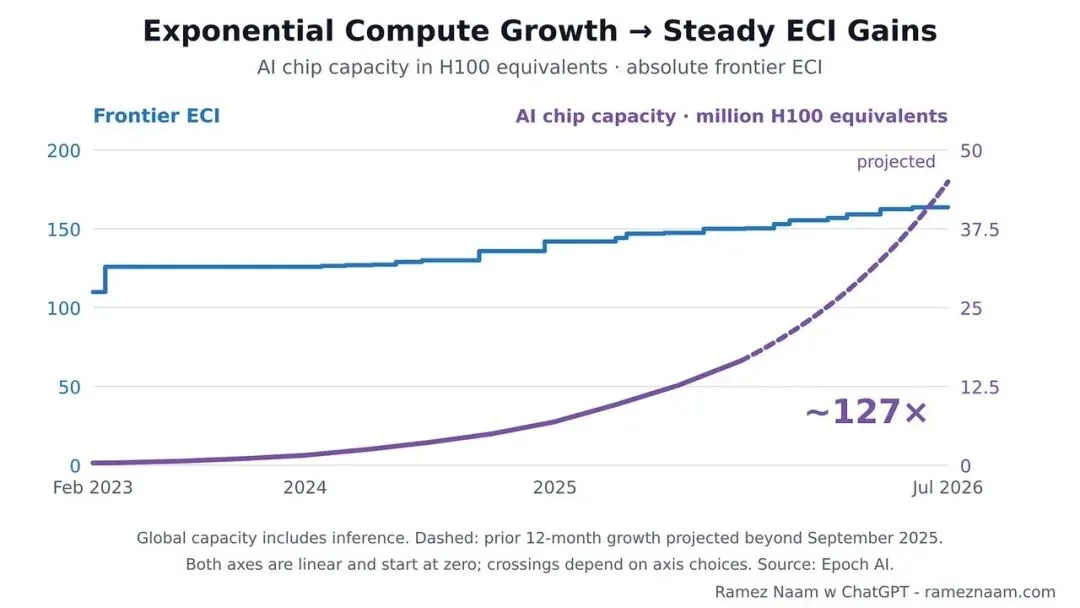
按照“智能爆炸”的设想,AI 越深地参与研发,模型能力的进步曲线就该越陡峭。但现实却陷入了奇特的僵局:行业砸下成百上千倍的资源,仅勉强“保住”了原有的匀速。
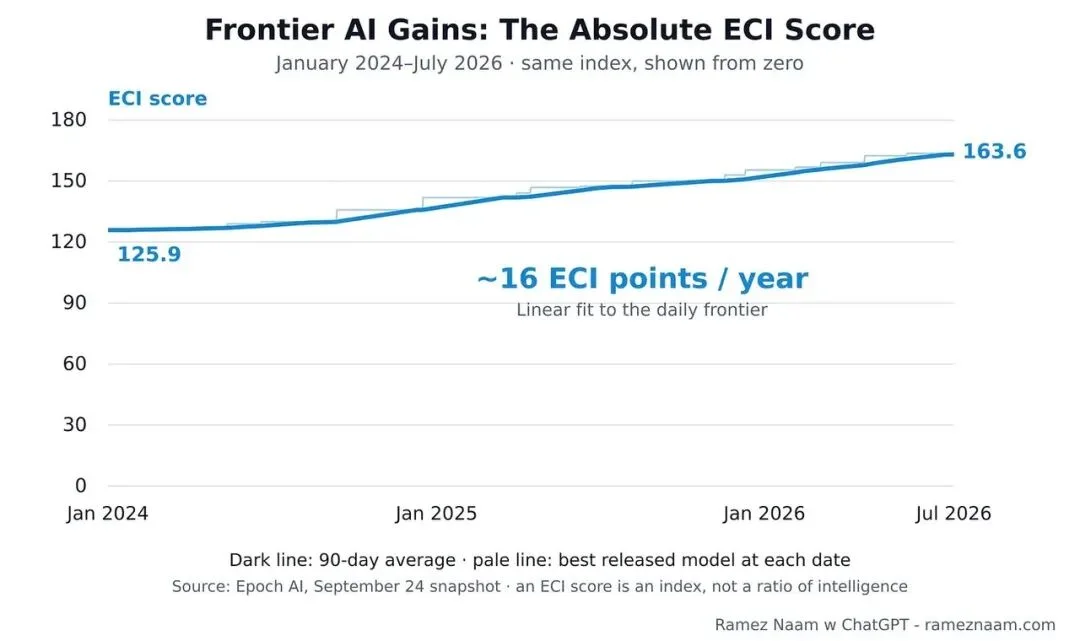
研究机构 Epoch AI 编制了 Epoch 能力指数(ECI),用以评估各家模型综合能力;将每个时间点已发布模型中的最高分连起来,便构成了公开的前沿曲线:按 2024 年 1 月到 2026 年 9 月的数据拟合,这条曲线每年稳定上涨约 16 分——速度极快,但毫无飙升迹象。
对此 Naam 给出两种解释:要么是 AI 带来的提效被日益加剧的科研难度对冲了,要么单纯是爆发时机未到。
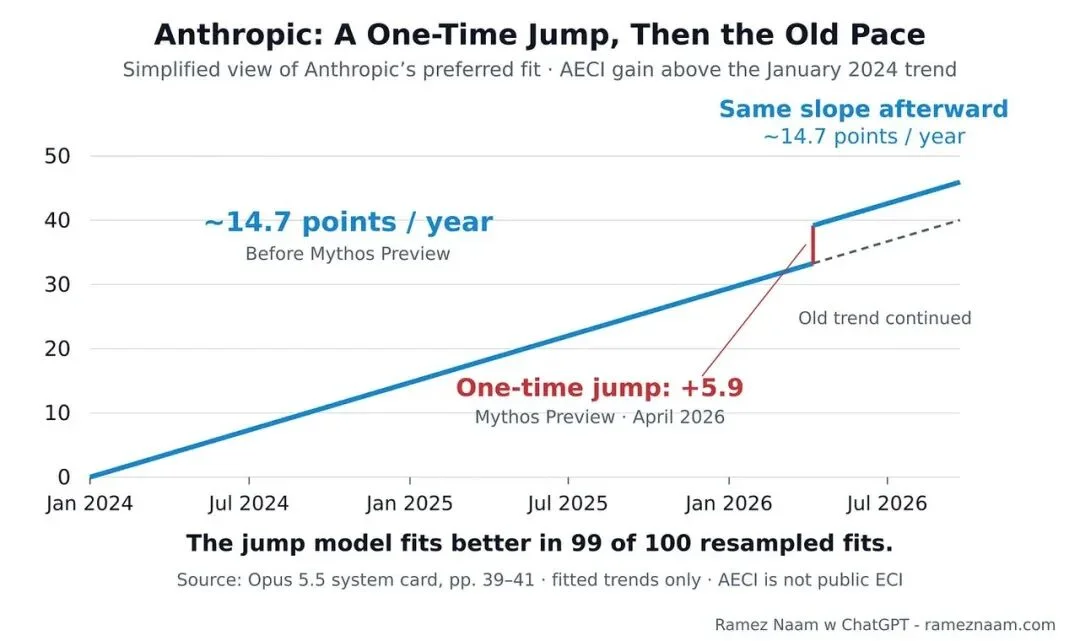
在这期间,Anthropic 内部曾用自建的 AECI 指数追踪到能力陡然上扬,让部分学者示警“正全速冲向智能爆炸”;但 Naam 拆解后指出,那只是一次技术跃进带来的阶跃式跳升,上了一个台阶后,长期的整体增速并没有继续加快。
无波澜的直线背后,是急剧膨胀的代价。 在 Naam 梳理的图表中,自 2023 年 2 月以来,他列出的六类核心投入(包括数据规模、算力、资金资本、人才与电力等)全都在陡增,而模型能力的产出却依然是平缓的匀速:
成百上千倍的资源砸进去,研发端的真实转化率有多低?OpenAI 公开的《研究加速报告》提供了一个直观的切面,为我们清晰地展现了 AI 研发过程中惊人的“过程损耗”:
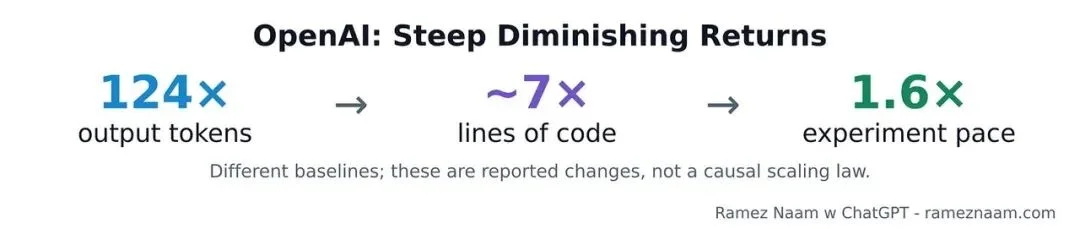
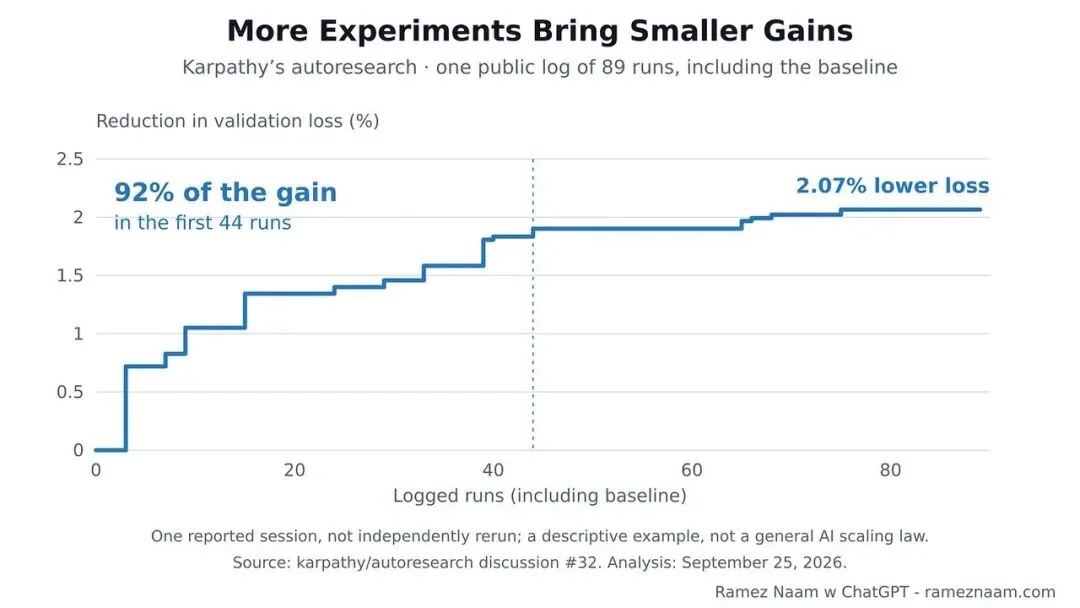
更残酷的是,实验多了 60%,并不等于进步快了 60%。在绝大多数科学领域,实验越多,单次实验的有效收获就越少。Naam 按照指数为 0.2 的幂律(Power Law)进行了推算:60% 的实验增量,最终可能仅仅换来了一成(10%)左右的研发提速。
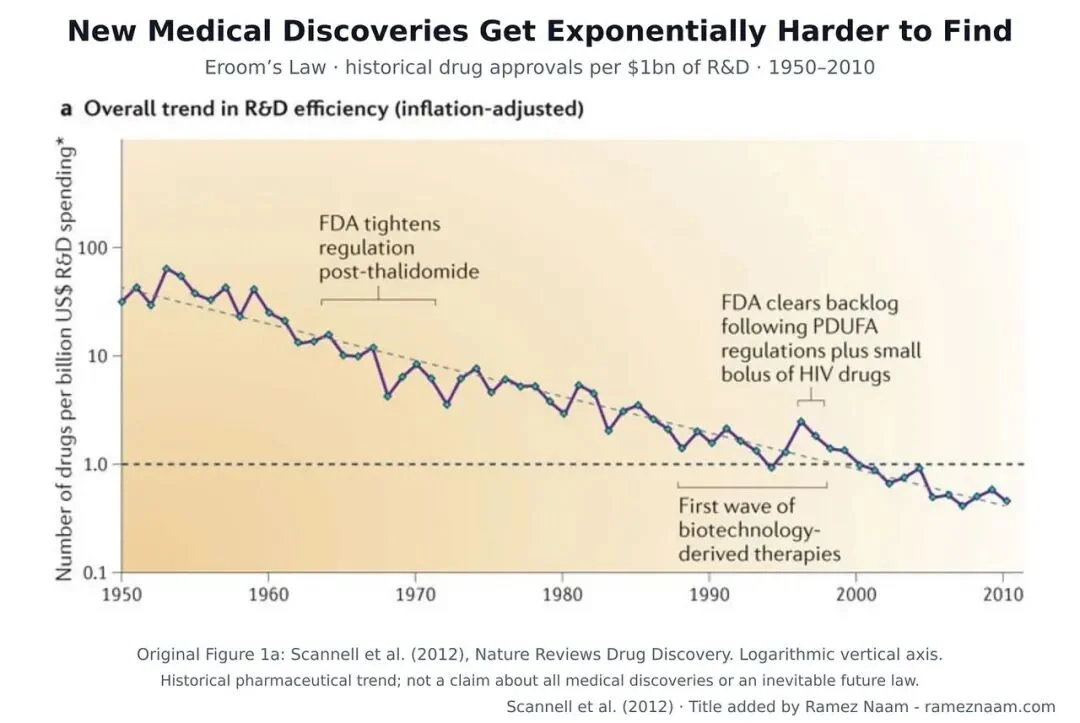
转化率如此惨淡的根本原因是“前沿创新正变得越来越贵、越来越难”。这主要受到宏观经济规律与工程实证的多重制约:
Anthropic 披露的数据,从另一个角度印证了这场“投入产出的严重错位”:其内部工程师的人均代码量达到了 2024 年的 8 倍(与 OpenAI 的 7 倍相近)。在 Claude Mythos Preview 的系统卡中,Anthropic 对 130 名技术人员的调查显示:使用 AI 后,员工的个人生产力约为不用 AI 时的 4 倍。
但 Anthropic 极其清醒地指出:生产力提升无法 1:1 转化为模型能力的进步。要让整体进步速度翻倍,所需提效还要再高一个数量级。按 Naam 的换算,这相当于员工生产力要达到不用 AI 时的约 40 倍。
从 4 倍到 40 倍,中间横亘着十倍的技术阻力墙。
至此,这笔账已经被算得极其透彻:AI 确实让工程师敲代码变快了,但这仅仅是线性的效率提升,而前沿模型面临的科研难度黑洞,却是指数级扩大的。
这恰好解释了 Anthropic 在 Mythos 5.1 系统卡中为何特意强调“维持”(maintain)一词:内部大量使用 AI,仅仅是维持当前进步速度不倒退,根本看不到大幅加速的迹象。整个行业耗费百倍算力,拼尽全力,也只是在阻力越来越大的跑步机上保持匀速。
微观账:AI 独立研究
深陷“15 分钟魔咒”
宏观账算的是资源投入与回报的失衡,微观账则要直面一个更核心的追问:脱离了人类专家的“掌舵”,AI 独立单干究竟能撑多久?
要实现完全自主的自我改进,进而迈向“智能爆炸”,其核心前提是 AI 必须能可靠地接管长周期的复杂研发任务。
表面上看,AI 似乎已经展现出了极强的科研潜力。近期,OpenAI 宣布其模型成功给出了纳维–斯托克斯方程(克雷数学研究所千禧年难题之一)存在性与光滑性问题的证明。在围棋、定理证明以及寻找猜想反例等严密的数学领域,AI 正在展现出某种“狭义超级智能(Narrow Superintelligence)”。
但这极易让人产生一种危险的错觉,误以为 AI 能同样轻松地接管前沿 AI 自身的架构研发。现实是,数学之所以成为 AI 的主场,是因为它属于“高度可验证(Highly Verifiable)”的闭环领域:训练数据可以无限生成,结果对错能靠系统近乎完美地自动判定,且不需要等物理世界或人类的反馈。
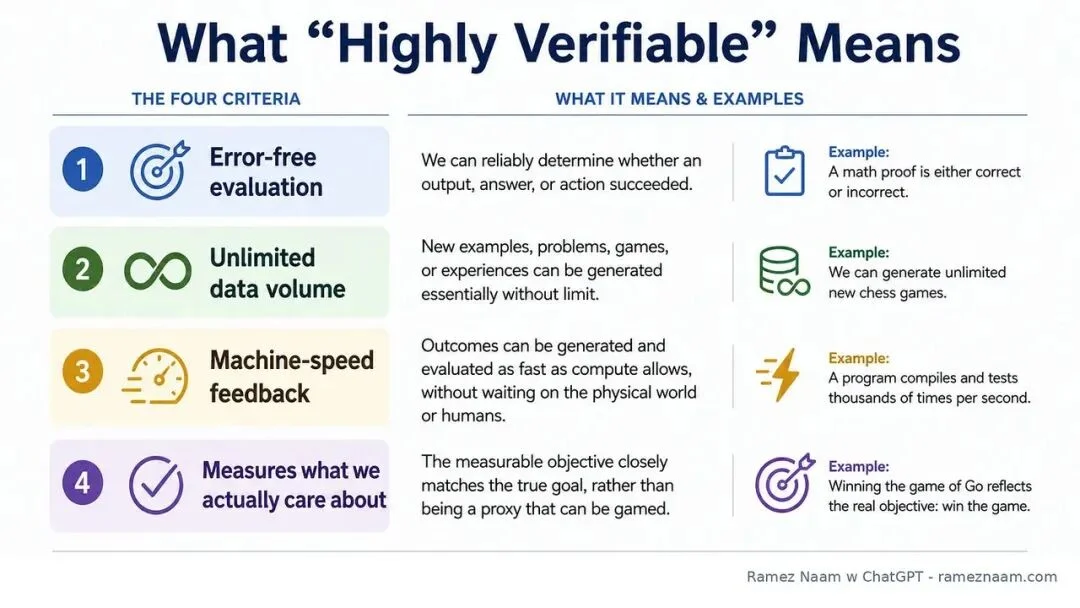
但前沿 AI 研发恰恰相反,它充满了方向的模糊性,极度依赖试错与方向抉择。在标准答案明确的数学题上当“超人”,不代表在充满未知迷雾的架构探索中也拥有“超人”的判断力。
这种“狭义智能”与“全面研发”之间的巨大鸿沟,在行业跑分与前沿 AI 机构内部真实数据的对比中,暴露得淋漓尽致。
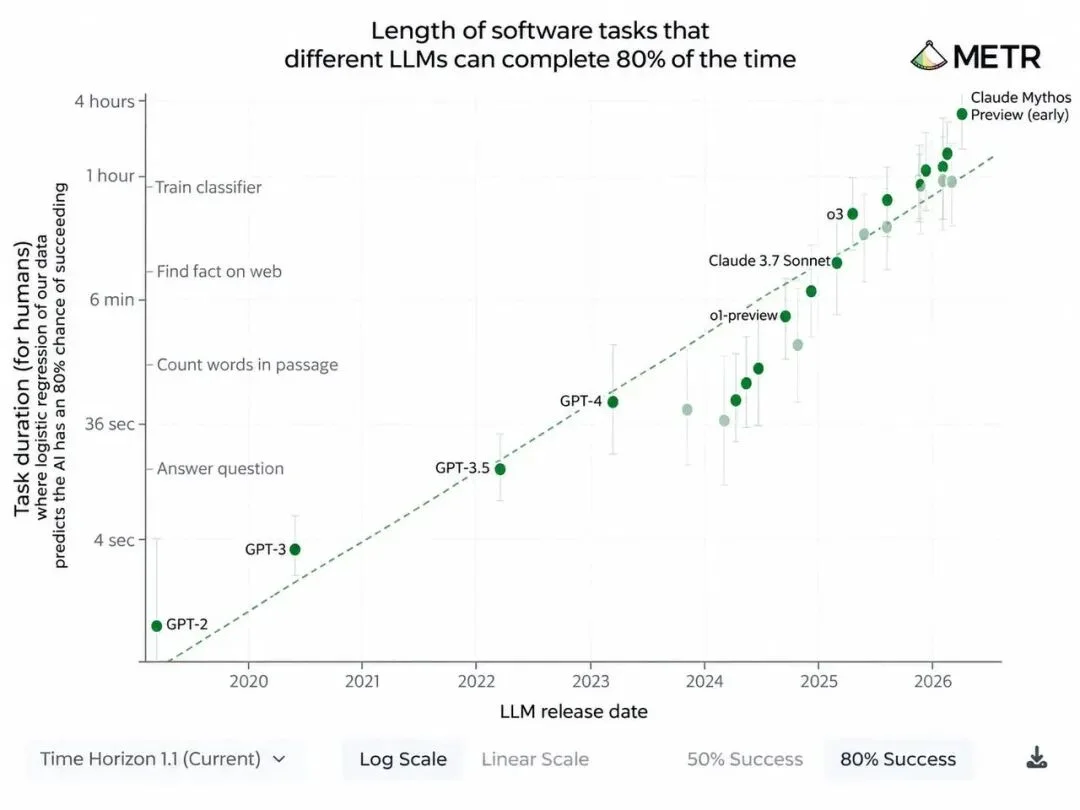
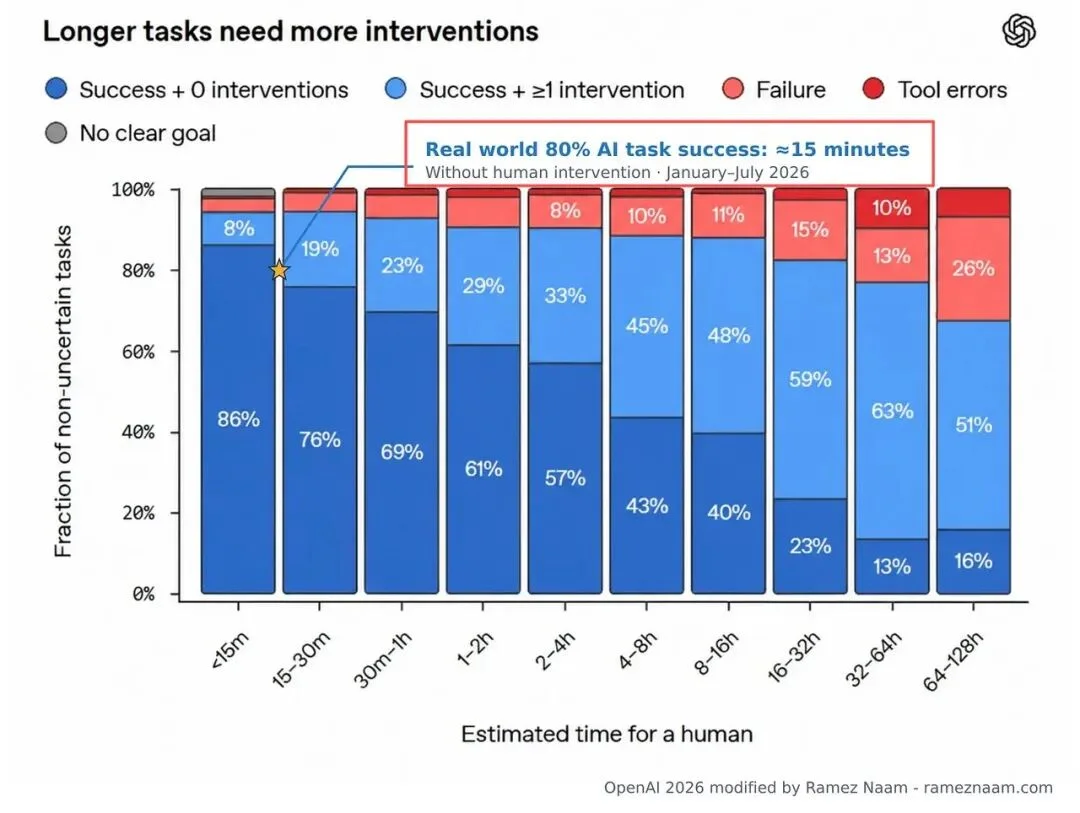
一边是跑分和预测里的 4 到 11 小时,一边是真实科研前线测出的 15 分钟,两者相差了惊人的 16 到 44 倍。
更值得深究的是,为什么 AI 独立研究只坚持了 15 分钟?
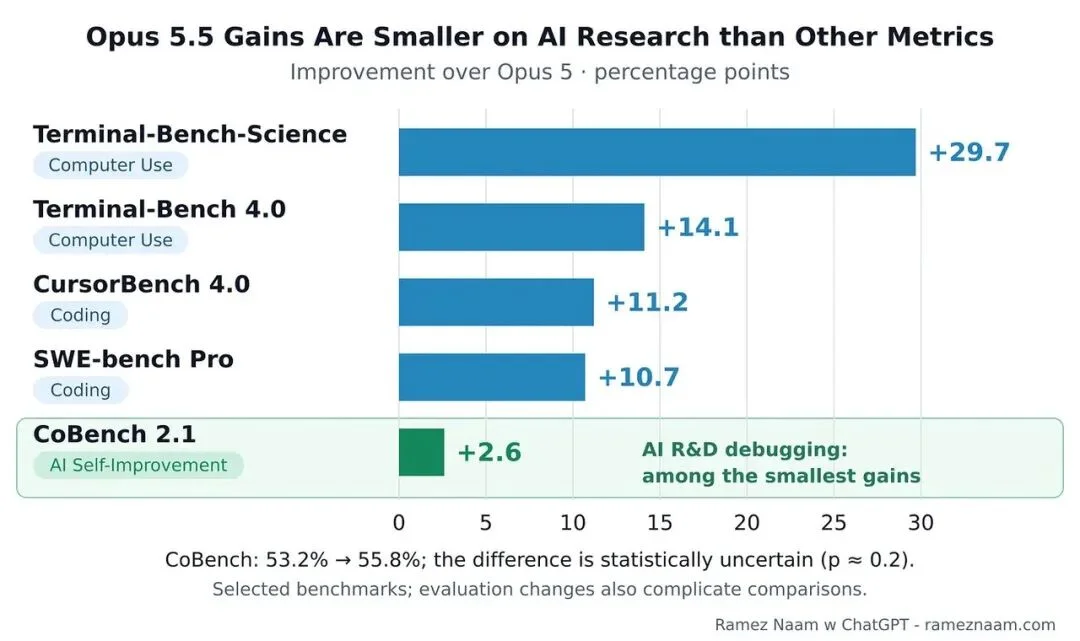
一方面,专门衡量 AI 研发能力的基准测试本身已经陷入了停滞。以 Anthropic 专为历史 AI 研发难题构建的 CoBench 测试为例,最新的 Opus 5.5 表现仅比上一代 Opus 5 高出 2.6 个百分点,几乎完全落在误差范围内。
另一方面,这类基准测试与真正的“前沿科研”之间存在着巨大的鸿沟。CoBench 考的仅仅是根据代码和日志“排查 Bug”这类修补工作,根本无法检验模型能否“发明新架构”。 排查 Bug 终究只是在既有框架内打补丁,而前沿研发需要的是“从无到有”的破局。
一旦进入未知的科研“无人区”,AI 就暴露出一个更难补齐的短板——AI 明显欠缺顶尖科学家才具备的“科研直觉与判断力(Taste)”。Anthropic 在 Opus 5.5 的系统卡中坦言,模型在开放式研究上极度偏爱保守假设,难以给出突破性假设。Naam 对此推测:在人类积累的海量训练数据中,渐进式工作的样本远多于突破性成果,被普通数据喂大的 AI,难以学会进行颠覆式的思维跃迁。
三条加速捷径,
全撞上收益递减
面对双重困境,业内寄希望于三条强行加速的捷径,但Naam 逐一检查后发现,三条路径都受收益递减(diminishing returns)的制约。
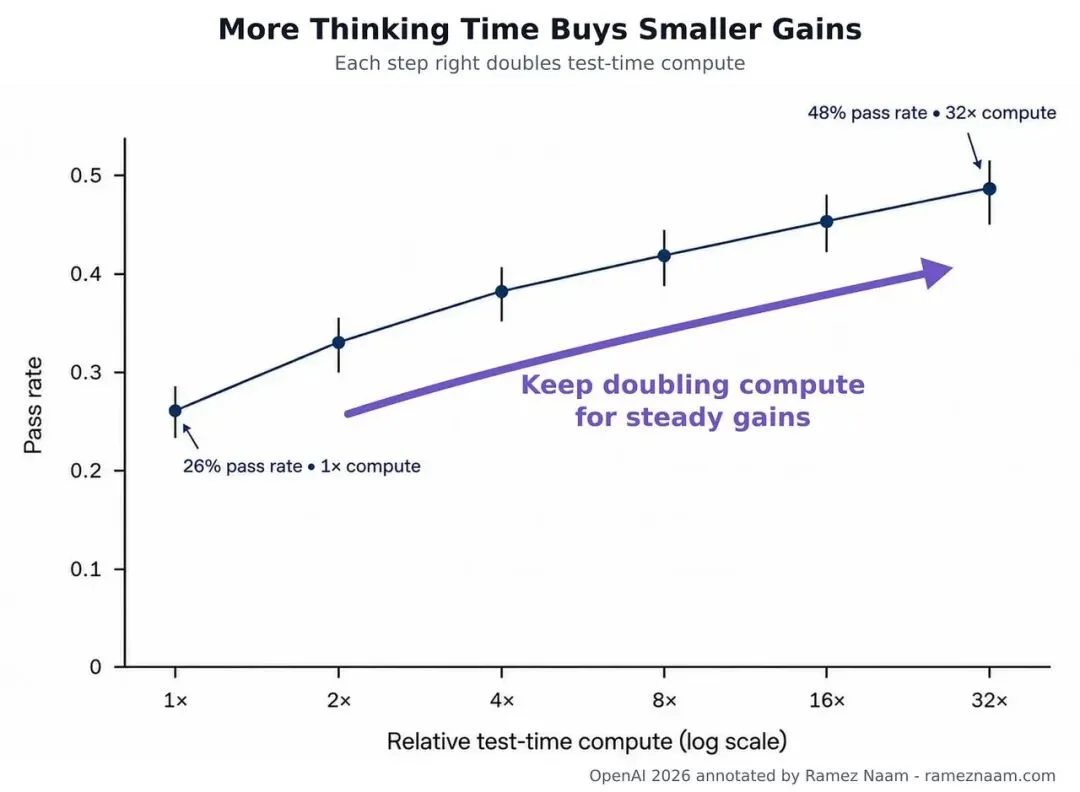
第一条路是挖掘推理阶段的潜力。既然模型直觉不够,那就让它在输出前多做推理。但 Naam 指出,测试时计算遵循的是对数增长曲线(Logarithmic Growth):算力每翻一倍,成本翻倍,解题成功率却只沿着曲线向上微微抬升一小格。用巨大的财务代价换取微弱的边际提升,性价比极低。
单个模型撑不久,业内便试图通过“人海战术”来实现:让成百上千个 AI 组成智能体集群(Agent Swarms)来分摊任务。
对此,牛津学者 Toby Ord 提出了一个著名的“平方根法则(Square Root Law)”:
更麻烦的是“想法雷同(Idea Redundancy)”困境。一项对比大模型与 467 名人类创造力的研究发现:前 10 个 AI 回答还能凑出不错的集体多样性(相当于 8 到 10 个人),此后再增加 AI 分身,其带来的新思路呈明显下降,甚至需要两个 AI 的输出才能抵得上一个人的增量。
但集群并非毫无用处,安全研究者 Lisan al-Gaib 指出,在大规模并行的漏洞挖掘或网络攻防中,只要能把搜索空间分给海量智能体,即便效率不高、Token 账单极高,也具有极强的战术价值。
但这种暴力搜索只适合在已知范围内“地毯式踩雷”,无法用来发明像 Transformer 般划时代的底层架构。连人称“OpenAI 推理教父”的 Noam Brown 都明确表示,多智能体方法在纳维–斯托克斯方程证明中的贡献甚至不到 10%。关键仍是底层模型足够强。
这是支持 RSI 最有力的论据:目前的 AI 不行,就用下一代更强的模型来做研究。OpenAI 破解千禧年数学题的杀手锏,正是在预训练上叠加了大规模强化学习(RL)。但在高度可验证领域威力惊人的同时,造更强的模型同样无法逃脱收益递减。随着稠密模型(Dense Models)越做越大,生成每个 Token 消耗的计算资源反而直线上升,投入越多、回报越少。
简而言之,无论选择哪一条加速捷径,都无法从根本上消除科研难度上升带来的收益递减。这些尝试终究无法触及智能爆炸的真正奇点。
终账:真实鸿沟约 5 到 10 倍
当把宏观、微观与战术阻力代入经济学模型,最终算出的结果撕开了智能爆炸的幻想。
那么,递归自我改进(RSI)要真正引发“智能爆炸”,数学上的起飞门槛究竟在哪里?
经济学者 Tom Cunningham 等人在论文《递归自我改进的经济学》中建立了一个量化模型,用一个核心指标衡量回路强度:AI 能力每提高 1 个 ECI 分,其研究效率能提高多少?
但 Naam 认为 9% 依然过于乐观,于是便改用了 OpenAI 基础设施上实际记录的底层实验数据(8 月份研究员人均每月实验次数约为 2025 年平均水平的 1.6 倍,同期前沿模型 ECI 提升约 16 分)重算发现:
如果真是每分 9%,16 分累积下来效率应接近 4 倍,而不是 1.6 倍;扣除 token 与算力堆砌的水分后,Naam 把纯模型能力带来的效率增益定在 2% 到 3%。
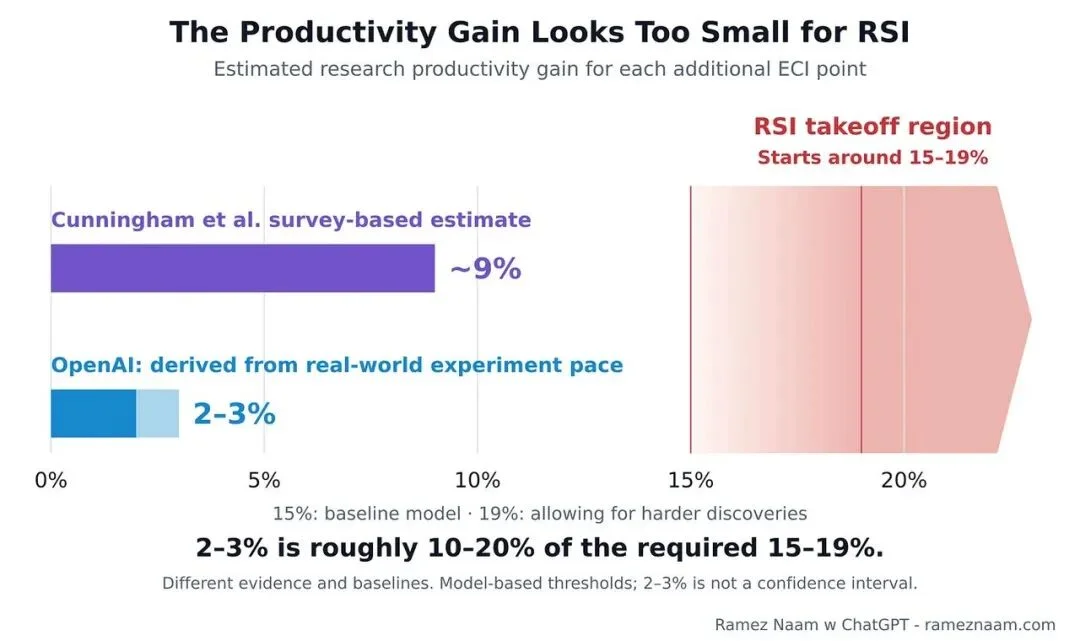
2% 到 3% 的现实,对比 15% 到 19% 的门槛,意味着回路强度只有门槛的五分之一到十分之一。
面对如此巨大的量化鸿沟,行业内并非没有试图寻找破局之道的宏观推演。例如,Tom Davidson 等人构建了一个多维复合模型,将软件、硬件和经济三条反馈回路编织在一起——AI 帮忙设计芯片,芯片支撑更强的 AI,经济增长再为两者输血。
Naam 虽称赞这是见过最有说服力的模型,但也指出了两大关键缺口:
正因如此,在补上这道鸿沟之前,“智能爆炸”仍只是一种理论可能。
尾声:闭环,不等于起飞
投入越来越难维持指数增长,加速捷径处处打折,连算法的自我迭代也困在收益递减里。在 Naam 看来,把人类从研发回路中拿掉,根本消除不了 AI 研发固有的收益递减,也不会让创新想法变得更容易找到。AI 或许终将自主造出下一代,但每往前一步,仍需指数级增长的资源。回路闭合不等于能够起飞。
要改写这笔账,大致有三条可能路径:
其实,Naam 并非唱衰者。他相信 AI 会以任何传统技术都难以企及的速度进步,并在数学、编程、网络安全等高度可验证领域远超人类,他怀疑的只是通往全面超级智能的“快速起飞”。他也坦言自己可能看错,但更看重证据:收益若回升,他想知道;若继续缩水,他也想知道。
刊发此文的 Noah Smith 则不置可否:奇点是否到来,只能拭目以待;但无论 AI 会不会在 2027 年“爆炸”成神,2040 年的 AI 看上去都会像神。
资料来源:
https://www.noahpinion.blog/p/wheres-the-intelligence-explosion
https://x.com/tanayj/status/2104004090007302287
https://www.alibabacloud.com/en/press-room/alibaba-unveils-roadmap-on-full-stack-ai-strategy
文章来自于微信公众号 “AI前线”,作者 “AI前线”


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
