
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
图片有“该内容由AI生成”的水印。从现在起,蛋白质也可以有了。
9月30日,Google DeepMind发布SynthID Bio,把水印技术第一次带进合成生物学,要给AI设计的蛋白质打上“由AI生成”的水印。
这个标记不在文件里,不在标签上,而是写进蛋白质的氨基酸序列和三维坐标中。
团队证明,生命分子能携带可追溯的“来源标记”,而且不影响原本的蛋白功能。
目的就是让AI设计的蛋白质拥“数字身份证”,为狂飙的AI生物学补上生物安全性和科学诚信这块拼图。
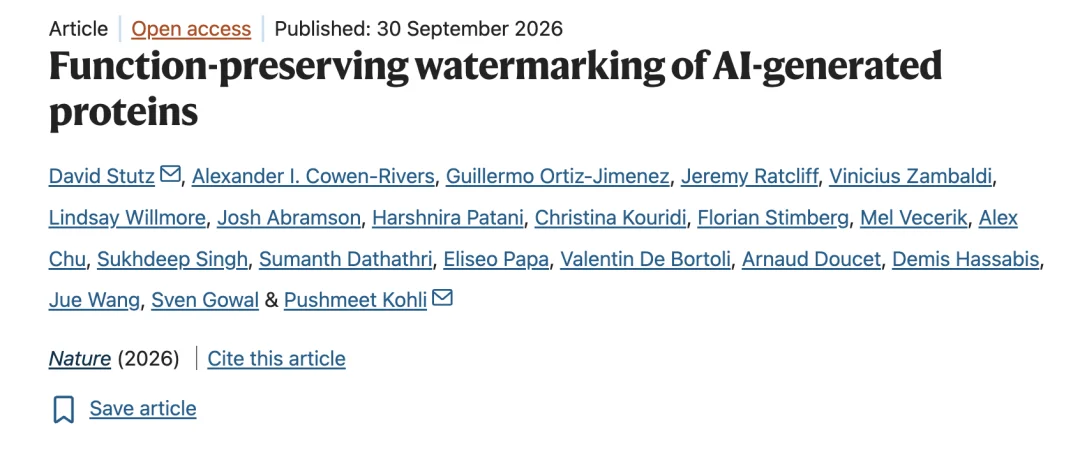
研究阵容亮眼,成员名单包括DeepMind研究副总裁、AlphaFold项目核心人物Pushmeet Kohli,以及DeepMind创始人、诺贝尔化学奖得主Demis Hassabis。
水印进入蛋白质,原本功能不受影响
蛋白质由一串氨基酸按特定顺序排列而成,再折叠形成复杂的三维结构。氨基酸序列决定蛋白质的三维结构,而三维结构决定蛋白质的功能。
为此,DeepMind设计了两种加水印的方法。
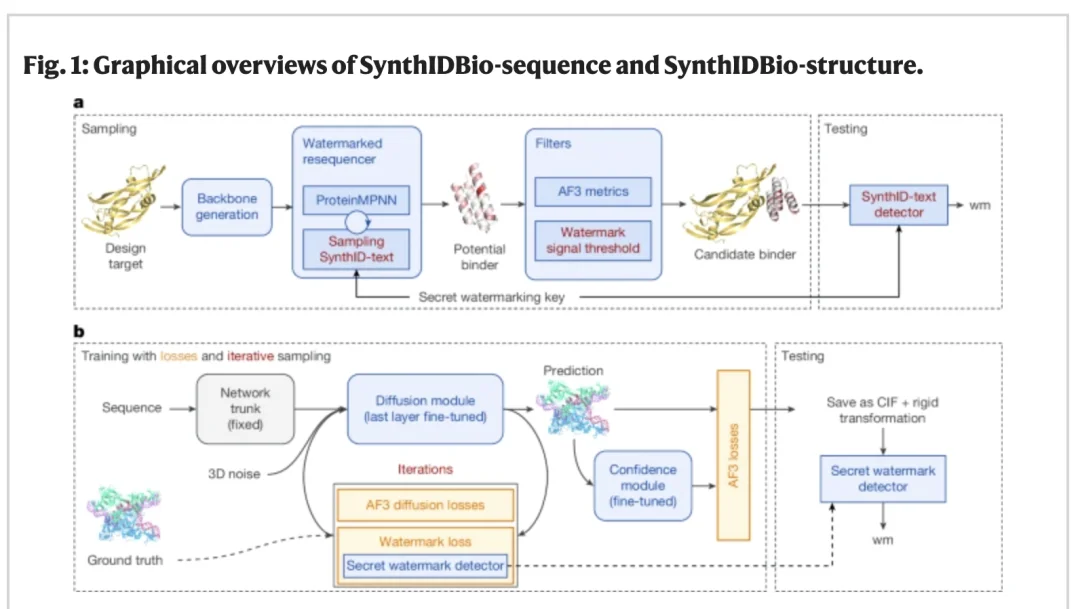
一:给蛋白质的氨基酸序列加水印(SynthIDBio-sequence)
原理相当朴素。蛋白质通常由20种标准氨基酸构成。在许多非关键位点上,将某种氨基酸替换成另一种化学性质相似的同类,蛋白质功能不会发生显著变化。
SynthID Bio的水印就藏在这些"换谁都行"的选择中。
在搭载SynthID Bio水印的ProteinMPNN模型中生成蛋白质序列时,SynthID Bio会有偏向地引导氨基酸的选择,将水印信号分散到整条序列中。检测端则用相应密钥,判定该条序列是不是用搭载了SynthID Bio的模型生成的。
二:调整三维原子坐标(SynthIDBio-structure)
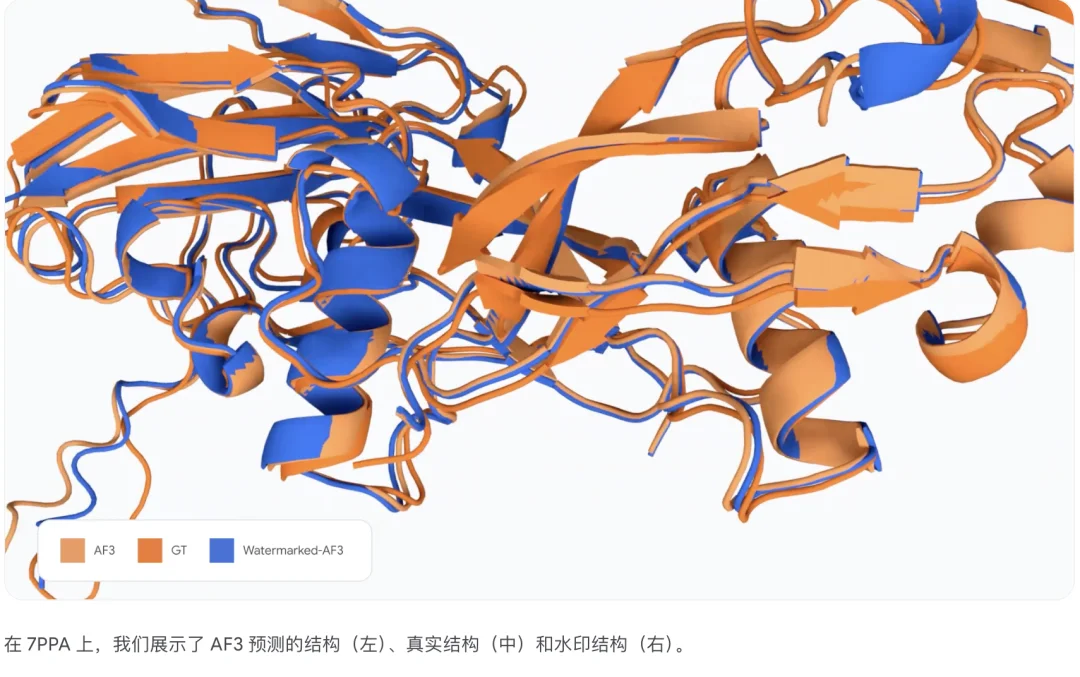
DeepMind团队对AlphaFold 3的一小部分扩散网络做了微调,将水印“焊”进模型权重。这样一来,无论谁运行这个模型,输出的三维原子坐标都会自动携带可检测的水印信号。
据报道,它在保持预测精度的同时,可检测性接近完美,还能抵御数字噪声和轻微的坐标扰动。
水印最怕的是“能验但废了”。
为了验证带有水印的蛋白质仍然可用,团队进行了湿实验。他们将AlphaProteo与搭配水印版的ProteinMPNN结合使用,针对VEGF-A、新冠病毒刺突蛋白RBD、PD-L1三个靶点设计结合剂。
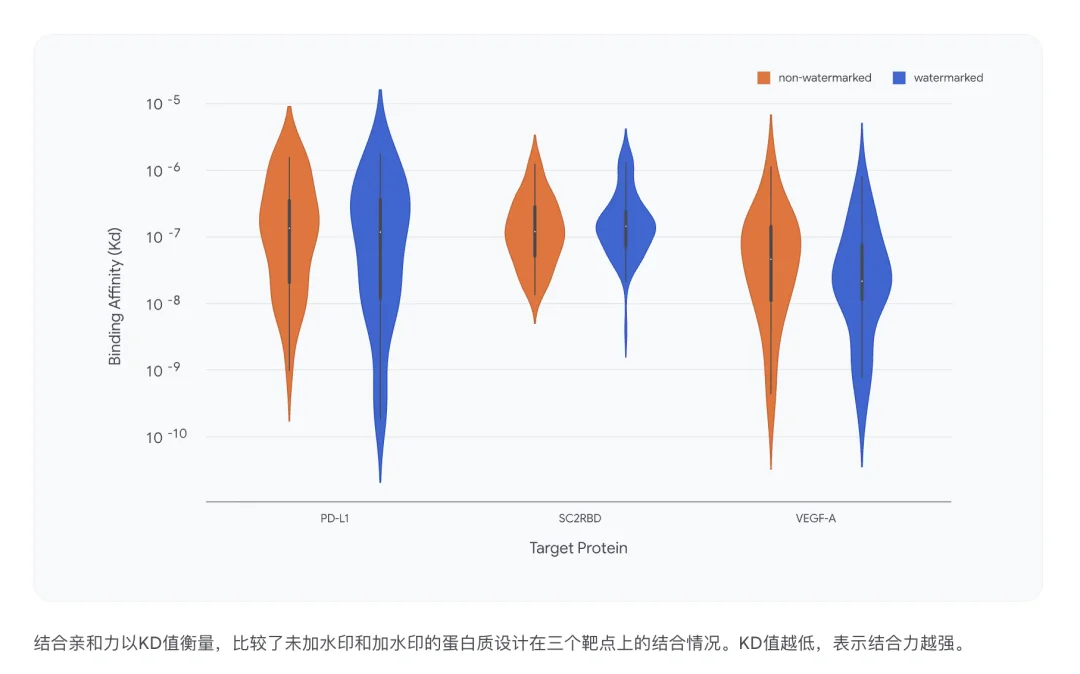
结果显示,水印版在命中率、结合亲和力和序列天然多样性三项指标上,与不加水印的对照组持平。
这也是首批既带水印、生物功能又完好的蛋白质结合剂。
再向前一步,DeepMind还与斯坦福Hie实验室、Arc Institute合作,把SynthID Bio整合进基因组模型Evo 2中,给AI设计的噬菌体基因组加水印。早期细菌培养实验表明,这些噬菌体功能正常。
加强生物安全
首先要说明的是,SynthID Bio不能直接验证某个蛋白质“安不安全”,它能做的是告诉研究者,这个设计来源于哪里。
先想象这样一个场景:
你是一家DNA合成公司的筛查员,收到一份蛋白质序列订单,查遍数据库都没有匹配得上的,跟任何已知危险序列也对不上号。
过去的逻辑可能是这样的:不认识?那就假设它是自然界尚未被记录的作品,然后放行。
但现在AI能设计出成千上万条跟自然界毫无亲缘关系的蛋白质序列。碰上不认识的,要么逐条复核,要么放行并承担风险。
而水印相当于为合规的AI设计发了一张来源证明。
DNA合成商收到带水印的订单,就可以确认它来自哪个模型,简化筛选流程,把审查资源集中到真正可疑的序列上。
合成巨头Twist Bioscience把DeepMind的水印技术称为“生物安全工具箱里极具前景的新增项”。
此外,蛋白质数据库(PDB)、UniProt 和GenBank 等公共数据库是直接向公众开放的。如果AI生成的内容匿名涌入,又被错误标注,污染的将是整个科研的地基。有了水印,数据库可以在提交环节自动标记或复核AI合成条目,从而溯到其生成模型和来源。
DeepMind同步发表了方法论文,在GitHub上以Apache-2.0协议开源代码,并公开体外数据和微调后的AlphaFold 3权重,呼吁生物安全、基因合成和政策等各方共建。
几点疑虑
这套水印方法多少有点“防君子,不防小人”的意味。
有心之人可能不会用带水印的模型。
更别提SynthID Bio生成的水印是能够被削弱甚至移除的;如何抵抗蓄意篡改,仍是论文里提到的大难题。
还有一个问题:为了做推广,DeepMind开源了代码、放出了权重,但是这是否意味着,针对水印的攻防研究也公开化了?
话说回来,没有任何单一技术能保障生物安全万无一失。合成生物学当前存在的治理困境在于,技术一路向前狂奔,监管却连尾灯都看不见。
SynthID Bio的出现,为生物安全治理提供了一种新思路:既然追不上能力,就把治理机制嵌入生物设计本身。
数字内容领域已经有C2PA,生命科学领域如今也有了自己的版本。
文章来自于微信公众号 “智药局”,作者 “智药局”


【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
