
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
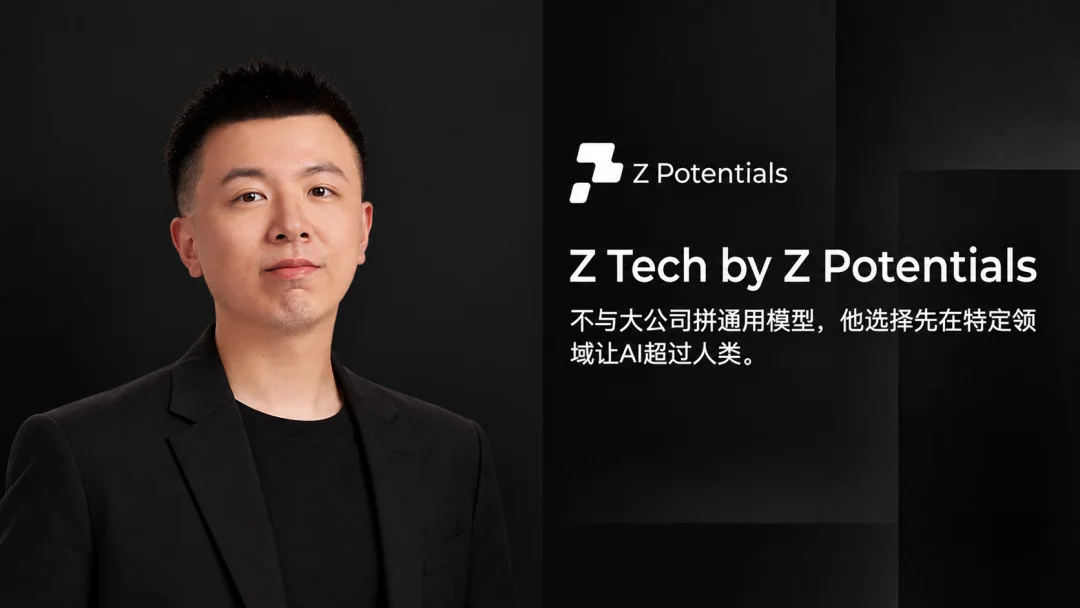
过去几年,大语言模型的发展,让AI研究越来越多地围绕同一个问题展开:一个通用模型,究竟还能变得多强?当越来越多的人沿着同一条Scaling路线向前走,留给学术界的问题也变得更加尖锐:如果不和大公司拼算力、拼模型规模,下一步还能做什么?
商静波给出的答案,是超级智能。他甚至提出了一个有些大胆的观点:如果把AGI理解为达到普通人水平的通用智能,那么某种意义上它已经实现了。真正尚未到来的,是能够在重要领域持续超越最优秀人类的智能。
但通往这一目标的路径,未必是继续训练一个无所不能的巨型模型。相反,他认为,在资源有限的情况下,与其追逐通用超级智能,不如先收缩边界,在一个足够重要、能够高效验证的领域里,让机器真正做到人类做不到的事情。
这样的思考,与商静波的人生经历有着某种奇妙的呼应。
小学五年级,他第一次接触Pascal编程,就发现相比奥数,计算机更让自己着迷,因为每一次尝试都能得到即时反馈。高中信息学竞赛,他以一名之差错过全国金牌;进入上海交通大学ACM班后,他又两次闯入ACM-ICPC世界总决赛,并最终拿到世界第二。从上海交大到UIUC,从师从数据挖掘领域代表性学者韩家炜,到2019年底进入UCSD建立自己的研究团队,商静波的学术道路走得相当快:约四年半拿到终身教职,34岁晋升正教授,并于今年入选《麻省理工科技评论》亚太区TR35。
有趣的是,他并不认为自己每一步都有明确的职业规划。选择UCSD,一部分原因是家人;选择留在高校,也不是没有收到工业界诱人的邀请,而是因为相比更高的薪酬,他更看重对时间和研究方向的控制权。
从早年的数据挖掘、弱监督学习,到今天探索AI自主发现算法、预测复杂决策,这条主线贯穿始终。他希望AI不再只是解题者,而能成为算法研究者:不只是给出某一道题的答案,而是自主提出假设、设计实验,最终发现一套人类可以理解、验证和复用的新算法。在模型参数不断膨胀的时代,他反而主张把一部分知识从模型权重里拿出来。“Logic的东西,就应该回归logic。”在他看来,可以被形式化的知识,应当尽可能变成可阅读、可修改、可积累的程序和规则,而不是永远封存在模型权重之中。
研究之外,商静波还写过计算机科普书和以信息学竞赛为背景的小说。把熟悉的知识讲给没有专业背景的人,让他重新体会到“讲清楚”有多难。而课堂里学生使用AI的方式,也让他反复思考:获得答案和真正学会之间,究竟差在哪里?这些经历最终都回到他对教育的一个朴素理解:让真正想学的人学到东西。
而对于身处其中的学术界,商静波也有自己的反思。“现在LLM正在converge,可能已经快到头了。”在他看来,当下的AI行业大量顶尖人才和算力沿着同一条路径集中投入,学术研究者更重要的任务,或许不是挤上这趟所谓的“最后一班车”,而是寻找下一条真正值得长期探索的道路。
本期Z Tech,我们与商静波从ACM竞赛聊到超级智能,从弱监督、算法发现聊到AI系统的下一种形态,也聊到他写科普书、教学生,以及为什么在大模型时代选择留在学术界。从一个不断解决难题的竞赛选手,到一个主动寻找难题的科学家,商静波的经历背后,或许藏着一个属于AI时代的启示:当所有人都在追逐更快的答案,真正重要的可能是判断什么问题值得花十年去解决。Enjoy~
ZP:您今年刚刚晋升UCSD正教授,年仅34周岁,最近又入选了MIT Technology Review亚太区TR35。回过头看,您是如何从信息学竞赛一路走上科研道路的?从上海交大、UIUC到UCSD,哪些经历塑造了您今天的研究方向?
商静波:我是通过高中信息学竞赛保送进入上海交大ACM班的,不过第一次接触编程其实是在小学五年级。当时绍兴市组织了第一届面向小学生的信息学竞赛,我们小学从奥数班里挑了几个人去学Pascal,我也被选中了。我很快发现编程比奥数更吸引我,因为它能给人很直接的反馈。那次比赛我刚好拿了全市第一,就觉得这件事很有成就感,也可能比较适合我。
初中时我继续参加了一些比赛,但当时完全不知道还有全国竞赛。到了高中以后,才知道还有省队、国家队和国际比赛,于是开始比较认真地参加竞赛。那时全国赛前20名拿金牌,我刚好第21名,只拿到了银牌,后来就去了上海交大ACM班。
进入交大以后,一方面是因为对信息学竞赛的热爱,另一方面也觉得自己此前比得不算太好,所以还想继续尝试。我参加了ACM-ICPC,大一和大三两次进入世界总决赛,大三那次拿到世界第二,也获得了一块金牌。
外界很多人觉得上海交大的ACM班和ACM竞赛是绑定的,但其实不是。俞勇老师创立ACM班的目标是培养计算机科学家,所以学生接触科研都比较早。我参加竞赛到大三暑假,之后去了微软亚洲研究院,跟郑宇老师做Urban Computing;本科期间也和陈天奇学长、李航老师合作做过研究。这些经历让我比较早接触到了research。后来我去了UIUC,师从韩家炜教授。
韩老师是Data Mining领域非常有影响力的学者,同时也是一位非常好的导师。我现在带学生的很多方式,其实也是跟韩老师学的,他一直是我的榜样。从竞赛进入科研,再到韩老师的组里接受系统的科研训练,对我后来怎么看问题、怎么选择research problem影响都很大。
读博士期间,我并没有特别明确地想过以后一定要做教授,所以也去过Google Engineering、Google Research和Two Sigma实习。有纯工程,也有research,还有金融。这些经历让我一直没有把academia当成唯一选择。
博士毕业时,因为two-body的问题,我太太已经在San Diego工作,而当地也没有特别适合我做文本研究的公司,所以我很希望能够去UCSD。所有人都告诉我UCSD很难进,韩老师也建议我多申请一些学校。但过程里有一些运气,刚好他们有position,最后我就去了UCSD。
2019年底到UCSD以后,我开始建立自己的研究团队,大概四年半拿到tenure,今年7月正式晋升为Full Professor。所以从career path来看,我算走得比较顺。不过回过头看,中间其实有很多随机性。我并不是带着很强的目的性去做每一个选择,很多时候只是觉得一件事情很有趣、值得试一试。
但从research的角度看,我做的事情反而一直比较一致。我最感兴趣的是:怎样让机器面对大规模数据,用越来越少的人类监督,去发现有用的、甚至人类原本不知道的知识。
核心其实有三个点:第一,数据足够大规模;第二,需要的人类监督越来越少,最好最终不需要;第三,机器不仅仅是在抽取和重新组合已有信息,而是真正能够发现新的东西。
ZP:信息学竞赛贯穿了您的求学经历,近年您也一直以教练身份参与其中。除了通常所说的算法和代码能力,竞赛经历对您的科研还产生了哪些影响?
商静波:我觉得竞赛是一个非常好的problem solving训练场,尤其能教人怎样formulate一个问题。竞赛题一般不会直接把数学模型告诉你,你要先自己思考、做一些observation,逐渐找到问题真正的结构,然后才知道应该怎样解决。
我相对更喜欢提交答案题,或者那些没有唯一正确答案、需要尽可能优化的题。比如以前Topcoder有一种比赛叫Marathon,里面经常是NP-hard或者类似组合优化问题的变种。你知道很难找到全局最优解,但还是要在有限时间里不断寻找更好的solution。这类问题我一直很喜欢。
真实的算法竞赛里,也经常会碰到一开始完全不会做的题。所以竞赛训练的不只是确定性的problem solving,更重要的是:面对一个很难、没有现成路径的问题,你不会因为它看起来很难,就认为它一定解决不了。
到了科研阶段,有一件事情发生了变化:竞赛更多是在解决别人已经定义好的问题,而科研首先要自己找到一个值得解决的问题。
但找到问题以后,仅仅知道它重要还不够,你最终还是得把它解决。所以竞赛对科研最大的帮助,并不只是算法或者代码能力,而是让我形成了一种面对难题的习惯:如果我认为这个问题真的重要,我不会首先担心它是不是太难,而是愿意花很长时间反复推敲,直到找到一个可以往前走的办法。
ZP:您刚才把自己的研究主线概括为:从大规模数据出发,用尽可能少的人类监督发现新的知识。强化学习减少了直接标注,但仍然需要reward和反馈。沿着您“减少人类监督”的研究主线,您怎么看RL?最关注的是什么?
商静波:作为韩家炜老师的弟子,我和很多同门看待问题都是从Data Mining的角度出发的。
会有人问我,data mining和machine learning有什么区别?我的一个理解是,machine learning往往更关注怎么学,而data mining更关注从什么数据里发现什么东西。所以对我来说,SFT、RL或者其他训练方法,本质上都是工具;我更关心这个系统最终能不能从大规模数据中发现新的知识。对于工具,我一直比较开放,只要能work就可以。
对我来说,比“用不用RL”更重要的问题,是Supervision从哪里来。这其实不只是RL的问题。以RL为例,它的feedback可以来自一个rule,可以来自人工标注,也可以来自模型自己。相比最后用SFT、RL还是其他方式训练,我更关心Supervision的来源,以及它能不能scale。
RL需要大量rollout和reward,所以另一个关键问题是:获得这些Supervision的成本有多高?这里既包括computing cost,也包括human annotation cost。如果高质量的feedback signal可以自动、大规模、低成本地产生,它就有可能支撑能力继续scale。
ZP:大语言模型正在改变很多传统data mining任务的解决方式。在这样的背景下,您怎么看LLM和data mining之间的关系?Data mining还有哪些不能被通用大模型取代的价值呢?
商静波:我觉得data mining并没有被LLM覆盖,因为两者看问题的视角不太一样。LLM追求的是一种general intelligence,希望一个通用模型能够解决尽可能多的问题;data mining则更愿意从一个具体的problem、一个vertical,甚至一个特定的数据分布出发。只要这个问题足够重要、数据足够大,它本身就值得研究。
从这个角度看,AlphaGo其实很符合data mining的思路:我们不要求它什么都会,而是先把范围限定在围棋,然后在这个范围里把能力做到非常强。
这也和我自己的long-term goal有关。对我来说,general intelligence不是最终目标,super-intelligence才是。我希望机器能够做到我做不到、甚至最优秀的人类也很难做到的事情。
这里有一个很重要的trade-off:general和super其实是两个不同的维度。一个模型覆盖的范围越广,同时又希望它在每个领域都做到superhuman,需要的资源就可能越大。
按照现在对AGI的讨论,我有一个可能比较有争议的说法:如果把AGI理解成Average General Intelligence,也就是一个系统在足够广泛的任务上达到普通人的水平,那么这个意义上的AGI其实已经实现了。但如果我们的目标是General Super-Intelligence,也就是在非常广泛的领域都达到superhuman水平,以现有资源可能还很难做到。
如果资源有限,但目标仍然是超级智能,一个很自然的选择就是先收束范围:不一开始追求通用的超级智能,而是在一个足够重要的领域里,先让机器真正超过人类。
实际上,这种特定领域的super intelligence已经存在了,比如下围棋、打游戏。接下来真正有意思的问题是:我们能不能找到一个比游戏更大、现实影响更强,同时又有可能实现super intelligence的领域?
围棋、游戏,包括一些数学和科学问题之所以特别适合做这件事,一个重要原因是它们的Supervision可以自动产生,而且相对便宜。赢就是赢,输就是输;一个程序对不对,可以运行;一个证明对不对,在有formal verifier的情况下可以验证。具体最后使用RL、SFT还是其他训练方法反而是第二位的。真正重要的是Supervision能不能自动、可靠而且低成本地scale。
一旦每一次学习都必须等一个人来标注、判断,或者等待物理世界里的一个过程完成,速度就很难随着compute一起scale。你可以把GPU增加一百倍,但人的时间、现实世界的时间不会因此缩短一百倍。所以如果目标是super intelligence,一个很重要的条件,是不能让人类提供Supervision的速度成为整个系统的bottleneck。学习、探索和验证的核心loop越能够在计算世界里自主运行,我们就越有机会通过scaling,把它推到人类能力之外。
ZP:围棋、数学等领域比较容易通过scaling取得进步,一个重要原因可能是它们有相对便宜、可以自动验证的反馈。但现实中的很多任务并没有这么干净的reward,甚至人类给出的反馈本身也可能是错的。在这些领域,模型应该怎样获得可靠的学习信号,并持续提升能力?
商静波:这正是我一直对weak supervision感兴趣的原因。打游戏时的reward很干净,甚至可以说是一种接近完美的Supervision。你的目标就是去overfit它:积分制游戏就把分数打到最高,对战游戏就想办法赢。什么是“对”、什么是“更好”都非常明确。在规则和目标固定的游戏里,我们不要求它generalize到另一个task,只需要把这个目标做到足够好。
但现实世界里的很多问题没有这么好的条件。尤其如果我们的目标是超级智能,一个很根本的问题是:即使Supervision由人来提供,也不意味着它一定是对的。如果一个模型最终要做到人做不到的事情,就会出现一个很有意思的矛盾:如果Supervision永远来自一个比模型更弱的人,那么随着模型越来越强,人类提供的Supervision本身就可能成为它继续进步的瓶颈。
所以我们必须研究,机器怎样从错误的、不完美的、单边的,甚至彼此矛盾的Supervision中学习。真正重要的不是让机器永远听从Supervision,而是让它能够利用不完美的Supervision,最终学到比Supervision本身更多的东西。
OpenAI在2023年的一项研究中提出了一个叫 weak-to-strong generalization 的方向,和我前面讲的思路非常接近。它问的是:能不能让一个能力较弱的language model去supervise一个更强的language model,同时让后者最终学得比前者更好?
人和超级智能之间其实也是同一个问题:如果我自己不是超级智能,我应该怎样指导一个超级智能?如果我的判断可能是错的,它为什么应该听我的?反过来,如果它不完全听我的,它又应该怎样从我的Supervision中提取真正有价值的信息?
我觉得这是走向超级智能必须解决的一个非常基础的问题:一个更弱的supervisor,怎样帮助一个更强的learner继续变强?
ZP:如果沿着在特定领域实现超级智能的思路继续往下走,您认为哪些领域既有足够大的现实价值,又具备训练、实验和验证的条件?您目前最看好的方向是什么?
商静波:我做research时,不太喜欢依赖太多自己无法控制的因素,所以会优先选择我熟悉、而且整个研究loop可以比较自主完成的问题。在计算机科学里,一个很直接的方向,就是那些我们知道问题定义、却不知道如何高效求解的NP-complete和NP-hard问题。这也是我们最近在FrontierCS这个工作中探索的方向。
但这里说的“解决NP-hard问题”,不是给AI一个input,让它直接给我一个output。我真正感兴趣的是:给AI一类问题,让它自己研究这类问题,最后发现一个可以复用的algorithm。换句话说,我不是只想让AI成为一个更好的solver,而是希望它能够成为一个algorithm researcher。
这里的“更好”不意味着一定要改变理论上的computational complexity。比如同样是一个NP-hard问题,如果AI能够发现新的algorithm,在我们真正关心的数据分布上大幅降低wall-clock time,或者在相同时间里得到明显更好的solution,本身就非常有价值。
所以一个比较现实的起点,是先限制problem distribution。现实世界里的问题本来也不是从arbitrary distribution中随机产生的。比如TSP,我们可以先限定某一类具有特定结构的数据,让AI在这个distribution上工作,再逐渐放宽constraint。
最终它可能不是一个单一模型,而是一套AI system,LLM只是其中一个组件。这个system可以自己probe数据分布、提出hypothesis、设计algorithm、执行实验、比较结果,再根据实验结果继续修改algorithm。最后,它交给我们的不是某一道题的答案,而是一套人可以拿走、复用,甚至进一步研究的新算法。
这个方向有一个很大的好处:提出方法、写代码、跑实验、比较结果、继续迭代,基本都可以在计算机世界里完成,而且结果相对容易验证。这就具备了我们刚才讨论的重要条件:Supervision和验证本身能够scale。
再往后,我们可以逐渐减少constraint。今天是让AI针对某一个distribution发现algorithm;未来也许可以给它更开放的问题,让它自己寻找结构、提出命题,甚至完成证明。
沿着这个思路,我觉得适合探索特定领域super intelligence的问题至少有三个特点:第一,结果有相对可靠的验证方式;第二,学习、探索和验证的核心loop能够高速运行;第三,问题本身足够重要,而且我们自己有能力判断它是不是真的做出了有价值的东西。
除此以外,我们最近还在探索另一类问题,就是预测未来和decision making。
比如,我们可以让一个AI system看一部电视剧、一部电影或者一本小说的前半部分,从中提取不同场景下角色做出的decision;到了后半部分,再给它新的场景,看它能不能预测这些角色接下来会怎么选择。
这和简单预测“下一句话是什么”不一样。随着故事发展,一个人的状态、关系和想法都在变化。系统需要从过去的行为中提炼出能够不断更新的decision logic,再把它用到新的场景里。我们先从电影、电视剧和小说这样的虚拟世界开始,是因为它们天然给了我们“未来”:前半部分提供context,后半部分提供后来真正发生的事情,也就天然提供了一种可以规模化获得的Supervision。
我们现在也开始往真实世界扩展,例如研究不同公司、不同团体在不同时期面对过什么问题、最后做出了什么decision。
Algorithm discovery和decision making表面上是两个很不一样的问题,但我选择它们的原因其实是一样的:我希望找一些足够重要、能够验证,而且人本身并不擅长的问题,让机器有机会真正做到比人更好。
如果AI能够自主发现人类没有找到的更好算法,或者在复杂决策问题上稳定做出超越人类的判断,我觉得至少在这些特定范围内,我们就可以开始讨论super intelligence。
ZP:您刚才提到预测未来和decision making。相比直接预测下一步会发生什么,您的重点是不是从历史行为中还原决策者的hidden states和决策逻辑?
商静波:我们的目标不是让LLM直接猜“下一步会发生什么”,而是希望从一个人或者组织过去的行为中,提炼出他做决策背后的logic和hidden states,然后用这套logic去预测新的decision。
我们最近有一篇ACL 2026 Oral工作,在这个方向提出了一种新的载体,叫codified decision tree。它看起来像一棵decision tree,但每个branch都可以包含类似代码的逻辑。比如系统先判断某个条件是否满足,再决定往哪个branch走;这个判断本身不一定是deterministic的,也可以交给LLM或者其他classifier完成。
这样最后得到的知识就不必全部隐藏在model weights里,而是一套人可以阅读、检查和修改的decision logic。它也可以不断积累,很像一个GitHub repository:发现新的decision pattern可以继续push,发现原来的logic有问题,也可以像提交pull request一样修改。
从这个角度看,我们其实是在把symbolic和neural结合起来。传统programming language更接近一个closed world,执行逻辑是deterministic的;我们在其中加入probabilistic的判断。if或者while里的condition可以由LLM、neural model或者classifier来判断。这样既保留了program的结构,又能够处理open-world里不确定的信息。
ZP:对一个长期运行、持续学习的AI系统来说,可能有两条演化路径,一条是不断更新外部的程序、规则和harness;另一条是根据feedback持续训练模型、更新权重。综合考虑,您会更倾向于哪种方式?两者应该怎样配合?
商静波:如果两种方式的正确率一样,我肯定会选择尽可能symbolic的方案。我有一个principle:在不影响正确率的情况下,能symbolic的东西就尽量symbolic。
原因很简单:它通常运行得更快;在相同条件下可以persistent和reproducible;人也可以直接介入、检查和修改。
如果知识全部存在model weights里,人很难直接看到模型到底学到了什么。即使它想错了,我们也很难准确告诉它:“你这里的哪一条logic错了,把这一条改掉。”很多时候只能继续调prompt、调harness或者重新训练。
如果一部分知识能够变成code或者其他symbolic representation,逻辑本身和判断能力就可以被解耦:logic如果是对的,就把它保留下来;中间某个classifier判断错了,我们就单独提升classifier,而不是把整套logic重新学一遍。
当然,我并不是说所有东西都应该symbolic。现实世界里大量问题是probabilistic的,这正是LLM和machine learning有价值的地方。我的原则是:确定性的东西尽量交给确定性的系统,不确定的东西再交给learning model。Logic的东西,就应该回归logic。
ZP:那是不是可以这样理解,LLM主要负责生成和调整任务流程,具体执行则尽量交给确定性的symbolic工具,让每一步都能够复现、解释和验证;同时,这套workflow也不是由人完全写死的,而是可以从training data中学习和演化出来?
商静波:对。Symbolic不等于human-written。这些步骤和logic本身也可以由LLM参与发现和生成,我们的codified decision logic也是从training data中学出来的。区别只是,一旦发现了可以被形式化、复用的知识,我们希望把它从model weights里“拿出来”,变成可以持续积累、检查和修改的东西。
ZP:对于长期运行的Agent,您更倾向于约束它的执行过程,还是允许它自由探索、只验证最终结果?
商静波:我觉得要看具体问题。并不是所有场景都有很好的symbolic structure。我们在decision making里使用tree或者finite-state machine,是因为这些结构已经比较成熟,也适合表达decision logic。
但如果一个问题本身还没有被well studied,我反而觉得可以让AI free to explore,不一定要规定它中间必须怎样思考。对我来说,比“过程是不是完全可控”更基础的问题,是最后的结果能不能可靠验证。
比如让AI生成数学证明,如果最后可以交给Lean这样的formal verifier检查,那么它中间用了什么方法找到这个证明,我可能没有那么在意。只要最终结果能够被严格验证,就可以给它很大的exploration space。
反过来,如果没有这样的verifier,只能让模型生成大量自然语言证明,再让人一篇一篇阅读和检查,整个系统很快就无法scale。所以探索本身可以很自由,但验证必须尽可能可靠而且便宜。
从现有成功经验来看,我越来越觉得,承载知识的形式和验证知识的机制,可能和模型本身一样重要。遗憾的是,现实世界里真正容易验证的问题还是太少。
ZP:您刚才反复提到形式化载体和验证机制。您觉得这种方法有可能成为一种更通用的AI system范式吗?
商静波:我希望有这个可能。
这也是我理解的data mining和纯粹model-centric research之间一个很有意思的区别。我们当然关心model,但data mining往往还会在model之上再搭一层system:数据怎么进来,知识怎样表示,什么时候调用model,什么地方应该用code,什么地方需要tool,最后怎样验证结果。
所以我更愿意把LLM看成整个system中的一个重要组件,而不是system本身。
我希望最终有一套data mining system,不同领域可以把自己的data和domain knowledge接进来。系统利用LLM理解open-world的信息,用symbolic representation保存可以形式化的知识,用tools执行确定性的操作,再通过verifier检查能够验证的结果。
不同领域需要不同的接口,但一旦这些知识、约束和验证方式能够被转化成system可以使用的组件,它们就可以不断积累和复用。
如果未来AI真的能够持续发现新的知识,我不希望这些知识全部消失在下一版model weights里。我更希望其中能够被形式化的部分,变成人类也可以阅读、验证、修改和继续使用的东西。
ZP:接下来聊一个技术之外的话题。您已经出版了两本书,最初是什么契机让您开始写作?
商静波:我们现在写了两本书,写书首先肯定是公益性质的,因为从投入产出比看,这件事一定不划算。但我不是特别计较投入产出比,一般自己真正想做的事情就会去做,而且会尽量把它做好。
第一本书是在COVID期间开始写的。那时我们的小孩刚出生,我开始关注应该怎样教小朋友。我发现美国有很多面向小朋友的英文科普读物,但中文相对少一些;计算机科学又是一个比较新的领域,所以我就想,能不能自己写一本中文的计算机科普书。
真正开始以后才发现特别耗时间,前后断断续续写了大概两年。这个过程里有一件事情让我印象很深:我写完以后,会先给我太太看。她是做法律工作的,没有计算机背景。我们经常会围绕一个问题争论:我觉得已经讲得非常清楚了,她为什么还是看不懂?
后来我慢慢意识到,很多时候不是这一句话没有讲清楚,而是我默认了太多东西。一个人在自己的领域做得越久,就越容易忘记哪些知识对别人来说并不是理所当然。对于书里的插画师也一样,她必须真正理解内容才能把它画出来,所以整个过程其实是在一轮一轮地发现:我到底偷偷假设了读者知道什么?
这让我觉得科普非常难。你首先要对自己的领域理解得足够深,然后还要有能力暂时忘掉自己的domain knowledge,站到一个没有这些prerequisite的人那里重新理解一遍。
写完这本书以后,我对怎样把一件事情articulate清楚也有了更深的认识:很多时候,真正困难的不是把答案说出来,而是知道对方缺少哪一段context。
第二本书是一部以信息学竞赛为背景的小说。我们以前一直有写小说的想法,最后还是选择了自己最熟悉的世界。总的来说,我把写书看作一种outreach。AI和大模型让越来越多的小朋友开始关注计算机,这是好事,但技术热点一定会不断变化。我更希望把一些能够长期沉淀下来的东西讲给更多人,让更多人真正理解并参与计算机科学。
ZP:AI让获得知识和答案越来越容易,但获得答案并不等于真正学会。您觉得AI时代,教育最核心的东西会发生变化吗?
商静波:教育是一个很大的命题。我觉得大家现在可能被AI搞得有点过于紧张了。很多人说AI现在什么都会了,所以很多课都不用上了,因为知识获取已经变得非常简单。但互联网出现以后,知识获取其实一直都在变得越来越容易。我们真正需要区分的是“获得一个答案”和“自己学会一件事情”,这本来就不是一回事。
以前作业不会做,大家会上网搜索。区别只是,过去像是把勺子放在碗里,你还得自己去挖;现在AI可以直接把东西送到嘴边。最大的问题是,你可能看都没看,也不知道答案对不对,就直接把它交上去了。
我们最近设计作业和take-home exam时,会故意放一些很简单、但如果把PDF直接丢给模型就容易答错的问题。有一次我们设计了一道多模态题,模型会凭空生成一个图里根本不存在的data point。一个200人的课,大概有20多个学生写出了同一个不存在的data point。
其实学生只要真正读一遍题目,再读一遍模型的答案,就不会犯这个错误。但有些人把自己变成了AI和作业系统之间的传话筒:把问题搬给AI,再把AI的答案搬回来,中间自己什么都没有做。
当然,AI以前也有类似的问题。AI只是让“完成任务”变得更容易了,但它并没有自动让人“学会”。
所以我觉得教育中最重要的一点,还是每个人都应该想清楚自己想要什么。你来上学、来学习,不能只是为了完成一个任务。学位本身并不代表什么,真正重要的是你在这个过程中学到了什么。
我从来不要求学生一定要来听课。只要你有自己的办法真正学到东西,我觉得都很好。有学生告诉我YouTube上某个视频讲得比我好,我觉得也很正常。
教育的本质,仍然是怎样让真正想学的人学到东西。到了AI时代,对学校和老师来说,一个更现实的问题是:对于一个真正想学的人,我们能不能让他在这里比单独和AI交互学得更快、更深、更完整?如果不能,我们就应该重新思考自己提供的价值到底是什么。
我觉得至少目前,人和人的交流还有一个很重要的优势:人是一种很厉害的“长上下文动物”。
一个学生来office和我讨论问题时,我看到的不只是他今天问的这一句话。我可能知道他以前学过什么、哪里容易卡住、喜欢怎样理解问题;看到他的style,也可能让我想起以前教过的某一类学生,于是尝试一种解释方式,如果发现不work,就马上换一种。
一个好的老师其实一直在维护一个关于学生的“长期context”:他已经知道什么、不知道什么,什么解释以前对他有效,他最近又发生了什么变化。真正好的教育不是每一次都从一个孤立的prompt开始。
当然,从long term看,我不认为这是人类永远独有的能力。AI未来也可能拥有很好的long-term memory,真正理解一个学生长期的学习状态,而且比人类老师更耐心、更个性化。如果有一天AI真的能做到这些,而且成本足够低,我觉得反而是一件好事,因为高质量的个性化教育就可能被带给更多人。
ZP:这一轮大模型浪潮中,不少高校研究者去了工业界。面对更高的package和更多算力,您为什么仍然选择留在学校?
商静波:确实有一些朋友邀请我加入他们的公司,package也都很好。但我觉得这件事最后还是要回到一个很简单的问题:你长期到底想要什么?
我个人比较看重时间上的自由。Faculty有一个很大的好处,就是只要把自己的事情做好,很多时间和研究方向可以自己安排。更大的package当然会让生活变得更容易,这是很现实的好处。但fundamentally,我觉得还是两个问题:你以后到底想干什么?你想做的事情,在现在这个position上能不能做?如果答案是能,我个人会觉得,对自己时间和研究方向的控制权,比package更有价值。
抛开package,另一个更值得讨论的问题是:如果一直留在学校,会不会逐渐和SOTA脱节?
这个问题我也认真想过。我再给一个可能比较激进的判断:我觉得现在LLM正在converge,可能已经快到头了。这里说的“到头”,不是说LLM不会再进步,更不是说AI没有问题可以做了,而是当前这条主流LLM路线正在逐渐成熟和收敛。
同时,我觉得我们在判断LLM到底有多强的时候,也要非常小心。很多时候,我们以为自己是在评价模型,其实是在用自己的能力作为尺子评价模型。
比如很多人会觉得,LLM的英文已经非常好了,但中文似乎还有不少问题。一个很自然的解释是训练数据分布不同,这在早期模型上当然可能很重要。但时至今日,还有一个很简单的可能:我们的中文比英文好。一段英文如果写得不够地道,我们未必看得出来;但中文稍微有一点奇怪,我们马上就能感觉到。所以我们感受到的“英文比中文强”,有一部分可能来自evaluator本身,而不完全来自model。
Vibe coding也是一样。对于一个原来不会写程序的人,一句话就能生成一个可以运行的东西,当然会非常震撼。但如果你本来就是一个很强的programmer,需要设计和维护复杂的software system,你看到的问题会完全不一样。能写出一段可以运行的code,和能够理解、设计、debug、长期维护一个复杂系统,不是同一件事情。
所以判断AI能力有一个很大的陷阱:当模型超过了你自己的能力以后,你反而可能越来越难判断它到底有多强;而在你比模型强的地方,你又会非常容易看到它的问题。
这也是为什么我不太愿意仅仅根据一些很惊艳的demo去判断一个技术是不是已经把问题解决了。最终还是要问:在真正困难、能够被可靠验证的问题上,它到底做到了什么?
这其实又回到了前面说的verification问题:如果我们自己都无法可靠判断一个结果到底好不好,就很难知道模型是不是真的进步了。
所以这个时候我更感兴趣的,不是在一条已经有大量资源投入的路线里继续追赶,而是:下一条真正重要的research direction到底在哪里?
我读PhD时,自动驾驶也经历过一个有点类似的阶段。当时Waymo非常火,很多人都有一种“这是最后一班车”的感觉,好像现在不上车,以后就没有机会了。
十年以后回头看,自动驾驶当然带来了很大的fundamental change,但它并没有让AI research结束。后来我们又有了LLM,未来当然也还会出现新的问题。
所以我不太相信所谓的“最后一班车”。如果你相信AI research还会继续,那么真正重要的不是赶上每一班车,而是判断哪一条路值得自己长期走下去。
今天的大模型公司当然要继续把LLM这条路线往极致推,这是它们应该做的事情。但从个人researcher的角度,如果一条路线已经有几百、甚至几千个非常优秀的人和巨大的compute在集中投入,我会问自己:我作为其中一个人继续往上加一点,和我去找一个还没有那么多人做、但可能同样重要的问题,哪一种更值得我花接下来的几年?
所以对我来说,最后还是两个条件:第一,你有没有足够的资源做自己真正想做的事情;第二,你是不是真的知道自己想做什么。
如果现在的position已经允许你做,或者沿着现在的方向继续走会让你更接近自己的长期目标,那就没有必要因为外面出现了一条更热的路线马上换方向。
很多时候,你其实已经快走到一个很重要的地方了,只是自己当时并不知道。如果每次看到一辆更快的车就换一辆,最后可能每一条路都只走了一半。
ZP:但工业界和学术界的资源差距越来越大。学术界应该怎样避免和大公司正面拼资源?
商静波:资源当然还是要想办法获得,我们组和工业界的合作也一直比较紧密。但另一方面,如果工业界正在集中几百人的团队和大量compute推进一条路线,学术界很难在完全相同的问题、用完全相同的方法上正面竞争。
高校里做一篇论文可能就是几个人的小team,而公司可以有几百人同时推进一个问题。所以学术界更应该发挥自己的优势,去做更前瞻、还没有被大规模资源集中覆盖的问题。
过去大公司的资源比较充裕,也愿意支持一些不需要马上落地的research,所以高校和工业界形成了很好的合作。但当资源开始更多集中到与公司未来一两年直接相关的方向时,学术界更需要想清楚自己的定位。
从这个角度说,我觉得学术界不应该只是用更少的资源去复制工业界正在做的事情,而应该去寻找那些暂时不需要巨大资源、但可能打开下一条路线的问题。比如training-free或者相对low-resource的方法,都可能更适合学术界做前沿探索。
ZP:很多年轻学生都会纠结要不要申请PhD。站在教授和招生者的角度,您觉得什么样的人真正适合读博?
商静波:我先给一个可能有点暴论的回答:如果一个人还在问“我到底要不要读PhD”,那也许可以先不要读。当然,我们可以反过来讨论,到底什么样的人适合PhD。
我申请PhD是在2014年前后,当时AI一点也不火,比较热门的是database、systems这些方向,computer vision才刚有一点复苏。我并不是因为某个方向火才去学它。
所以现在招PhD学生,我比较担心的一种情况是,学生说:“LLM很火,所以我要做LLM。”然后搜索一下哪些老师做这个方向,就去申请。我觉得如果目标只是进入当前最热门的产业,而你已经ready,其实可以直接去工业界,不一定需要读PhD。
PhD program最终希望培养的是independent researcher。Research也不等于发paper。Paper只是research过程中的一个checkpoint,就像跑完一个epoch以后save一个checkpoint,拿出来给别人看一下。
在这个过程中,我觉得最重要的是逐渐想明白两个问题:我是谁?我要做什么?
很多人在本科以前一直有一条比较清楚的路径:考试、升学、选专业,每一步都有相对明确的标准,也总有人告诉你下一步应该怎么走。但越往后,能够给你明确答案的人会越来越少。到某一个时刻,你一定会on your own。
所以如果申请PhD的时候还完全不知道自己想做什么,我觉得至少是一个需要认真思考的信号。当然,这并不意味着你一开始就必须有一个非常明确的答案。PhD本身也应该给人足够的空间去explore、试错,然后逐渐形成自己的判断。
我自己读PhD的前两年也尝试过很多方向,包括explainable machine learning、graph mining、DNA sequence、clinical data和text。到博二以后,韩家炜老师问我到底想做什么,我说我想做text,因为我觉得text data最多,做起来也最过瘾。
后来language model开始出现,我觉得这个东西很好,因为它可以减少对人工supervision和标注数据的依赖,于是就越来越坚定地沿着这个方向做下去。
当时KDD community的主流还是graph,我们做text反而有点像异类。有些文本论文投KDD,reviewer说应该去投NLP,那我们就去投NLP。这时候就能看出,一个人有没有自己的判断,是否真的相信自己正在做的事情。如果你相信,就应该继续做,而不是一个review说你不行,你就马上换到当时最热门的方向。
所以我希望学生经过前两年的探索以后,至少能够逐渐说出来:“我就是想做这个,我觉得这件事情是对的。”这个“东西”可以是一个领域,也可以只是一个比较大的research question。到了那个阶段,他才真正开始成为一个independent researcher。
ZP:除了兴趣,还有什么比较具体的判断标准?
商静波:我还有一个可能比较有争议的判断:博士应该留给真正学有余力的人。
博士教育和此前的初中、高中、本科教育很不一样。前面的教育很多时候是一种延续:上一阶段做得好,下一阶段通常也能继续做。但PhD不是简单把课程读得更深一点,它要求你在没有标准答案、甚至没有人告诉你问题是什么的情况下,自己不断找到值得做的事情。
所以我觉得一个比较自然的节奏是:课内内容能够比较轻松地完成以后,再去做科研和其他探索;而不是课内已经很吃力了,还要花双倍时间去卷课外项目。后者当然也可能卷出很好的履历,但那是不是你真正喜欢、也真正适合长期做的事情,并不一定。
一个很简单的判断标准是,你在本科或硕士阶段还有没有余力去explore?如果完成已有任务以后,你仍然有很强的好奇心,愿意主动找新的问题,而且面对一个没有标准答案的问题会觉得兴奋而不是痛苦,我觉得PhD可能会是一段很好的experience。
归根到底,PhD不是证明一个人有多聪明,也不是本科和硕士之后自然应该继续走的下一步。它更像是给你几年时间,学习怎样在没有人告诉你答案的情况下,找到一个自己真正相信的问题,然后独立地把它做下去。
本期访谈 Host Lu Lu,Z Potentials 主理人,硅谷大模型战略研究;飞行 Host 柴文浩,普林斯顿计算机科学博士生,谷歌DeepMind Student Researcher。
请注意,此次访谈内容已经过精心编辑,并得到了商静波的认可,仅代表受访人观点。我们也欢迎读者通过留言互动,分享您对本访谈的看法。
文章来自于微信公众号 “Z Potentials”,作者 “Z Potentials”

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
