
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
就在今天凌晨,Meta 正式发布了新一代旗舰模型家族 Muse Wonder,一次推出 Muse Wonder 和 Muse Wonder Full 两款模型。
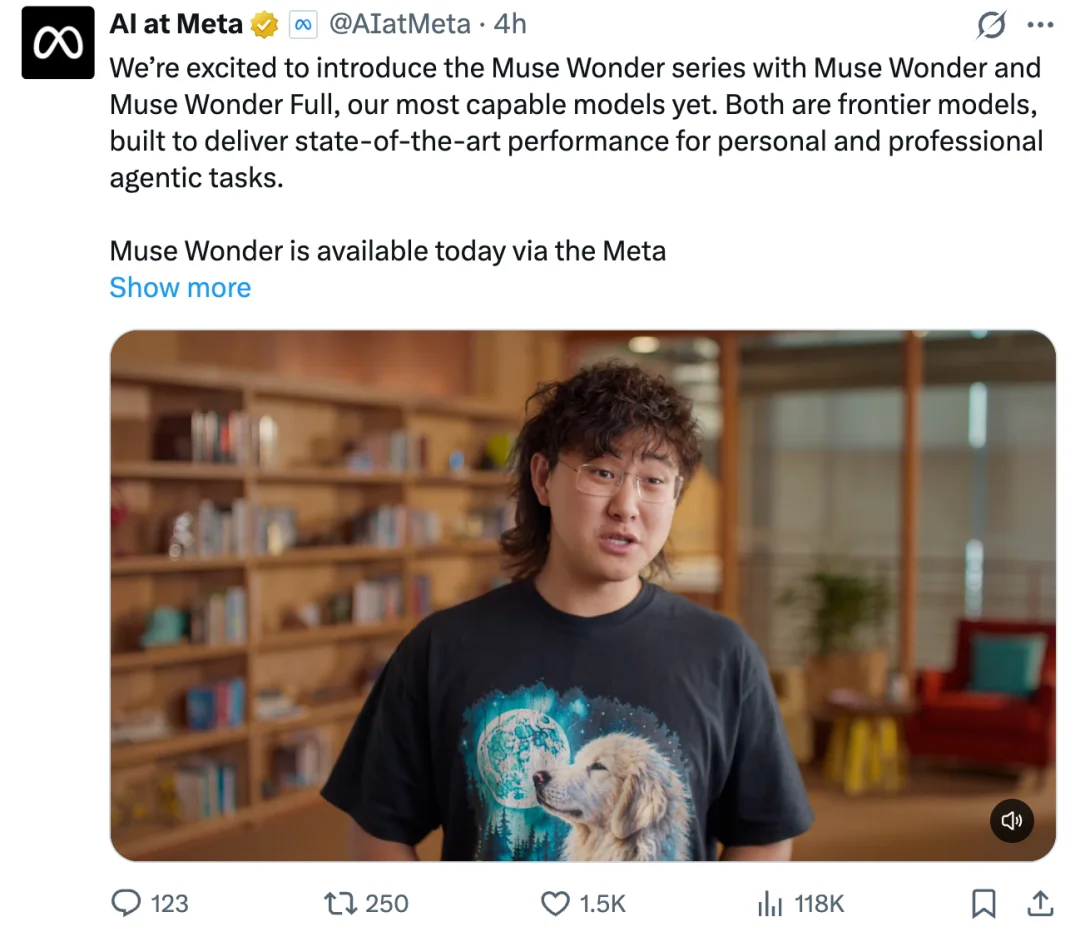
这一次,Meta 把目标直接对准了「个人超级智能」。
按照 Meta 官方的说法,这是该公司迄今能力最强的模型系列,在个人与专业级 Agent 任务、长期记忆和编程等关键评测中,取得了业界领先的成绩。
扎克伯格表示,「Meta 超级智能实验室成立刚刚一年多。从首个模型家族 Muse Spark,到如今规模更大、能力更强的 Muse Wonder,Meta 已经将模型能力推进至行业前沿。」
Meta 首席 AI 官 Alexandr Wang 声称,「这是 Meta 迄今规模最大、能力最强的模型,已经具备与业界顶级大模型正面竞争的实力。」
值得关注的是,Muse Wonder 引入了两项核心能力:Active Memory(主动记忆)和 Active Focus(主动专注)。前者让 AI 能够跨越不同对话,记住与你有关的重要信息,并在需要时主动找出来;后者则让 AI 能够持续推进复杂任务,遇到障碍时尝试其他办法,根据新信息调整行动。
简单来说,Meta 希望新模型既能记住用户的长期需求,也能围绕目标一直干活。
Meta 还特别强调了一项能力:泛化。在 Meta 的测试中,相比此前的 Muse Spark 1.3,Muse Wonder Full 在未被专门用于训练优化的陌生任务上表现更好。模型能力的提升,有望延伸到更多开发者没有提前设计过的真实场景。
目前,Muse Wonder 已经通过 Meta Model API 和 Muse Code 开放使用,Muse Wonder Full 则面向 Muse Code 订阅用户推出。未来,新模型还将逐步接入 Muse 个人 AI Agent 产品。
从重建 AI 体系
到冲击模型能力前沿
14 个月前,Meta 开始从底层全面改造 Meta 的人工智能研发体系。
一年多时间,Meta 从重建 AI 技术体系一路追赶,如今终于拿出了能够与全球顶级模型正面较量的旗舰产品。
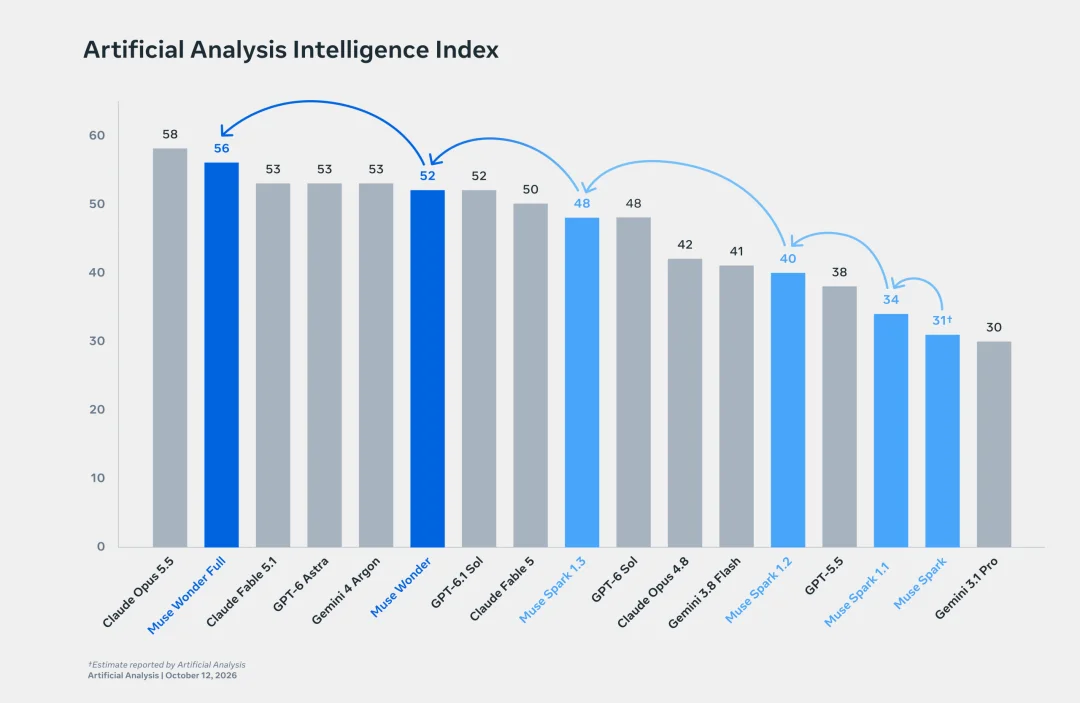
根据 Artificial Analysis 公布的智能指数,Muse Wonder Full 拿下 56 分,仅落后 Claude Opus 5.5 两分,位居图中第二,超过 GPT-6 Astra、Gemini 4 Argon 等一众旗舰模型。
主打快速响应的 Muse Wonder 同样达到 52 分,与 GPT-6.1 Sol 持平。更值得关注的是 Meta 自身的进步。Muse Spark 最初只有 31 分,后续的 Spark 1.1、1.2、1.3 分别提高到 34 分、40 分和 48 分。如今,Muse Wonder Full 将这一数字推高至 56 分。
此前发布 Muse Spark 时,Meta 介绍了如何通过可预测、严谨的规模化扩展方法,持续提升模型能力。今天发布的 Muse Wonder 延续了这条技术路线,在预训练和强化学习两个阶段进一步扩展,最终打造出了迄今能力最强的模型。
Muse Wonder 和 Muse Wonder Full 使用 Meta 千兆瓦级 Prometheus 数据中心进行训练,汇集了 Meta 多个团队的研究成果。
它们能够处理工作和日常生活中的复杂任务,展现前沿模型的能力,也让我们距离把个人超级智能带给数十亿 Meta 产品用户的目标更近了一步。
能力全面升级
Agent、记忆、编程取得领先成绩
Muse Wonder 系列在个人与专业级 Agent、记忆和编程等关键基准测试中取得了当前领先的成绩。
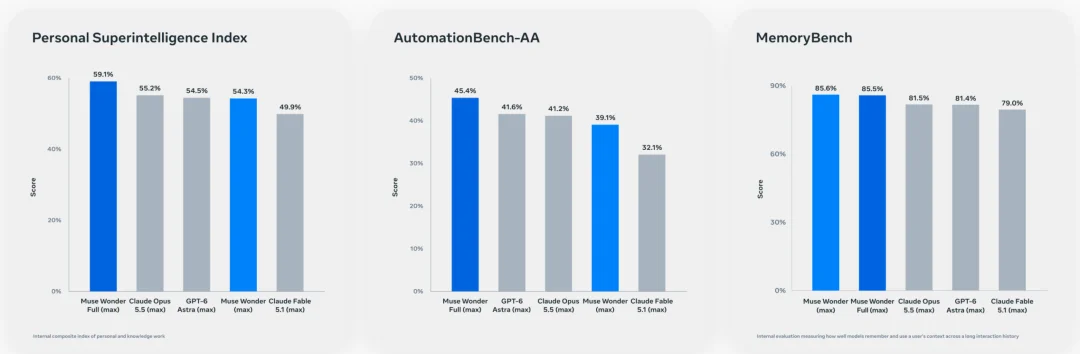
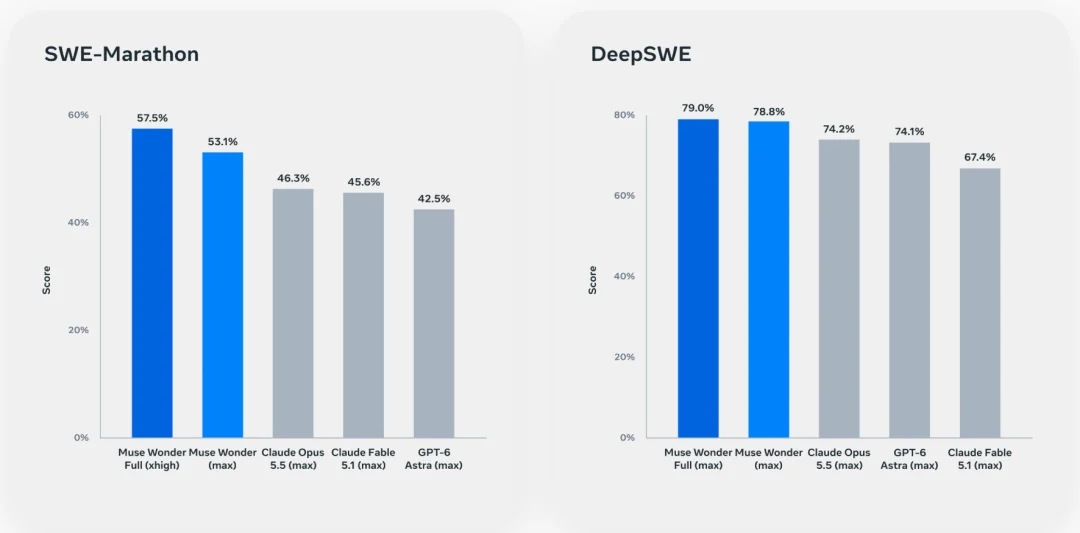
完整评测结果将 Muse Wonder 和 Muse Wonder Full 与其他前沿模型进行了广泛比较。
在 Meta 内部构建的 Personal Superintelligence Index 中,Muse Wonder Full 以 59.1 分位居五款参评模型第一,超过 Claude Opus 5.5 的 55.2 分和 GPT-6 Astra 的 54.5 分。
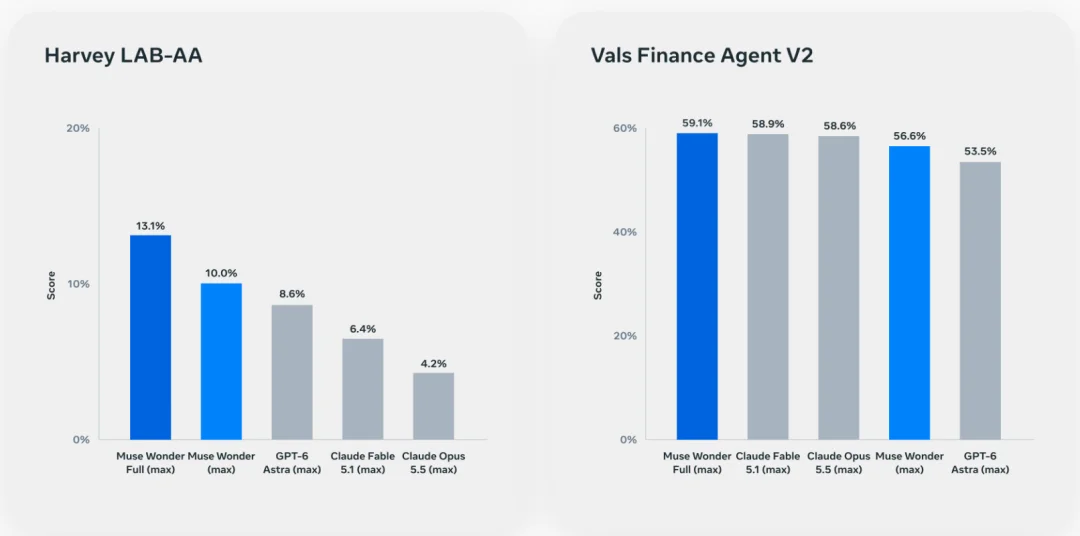
专业 Agent 方面,Muse Wonder Full 在 Harvey 法律 Agent 评测中拿到 13.1 分,超过 Claude Opus 5.5 的 4.2 分;在企业工作流自动化评测 AutomationBench-AA 中,也以 45.4 分领先。
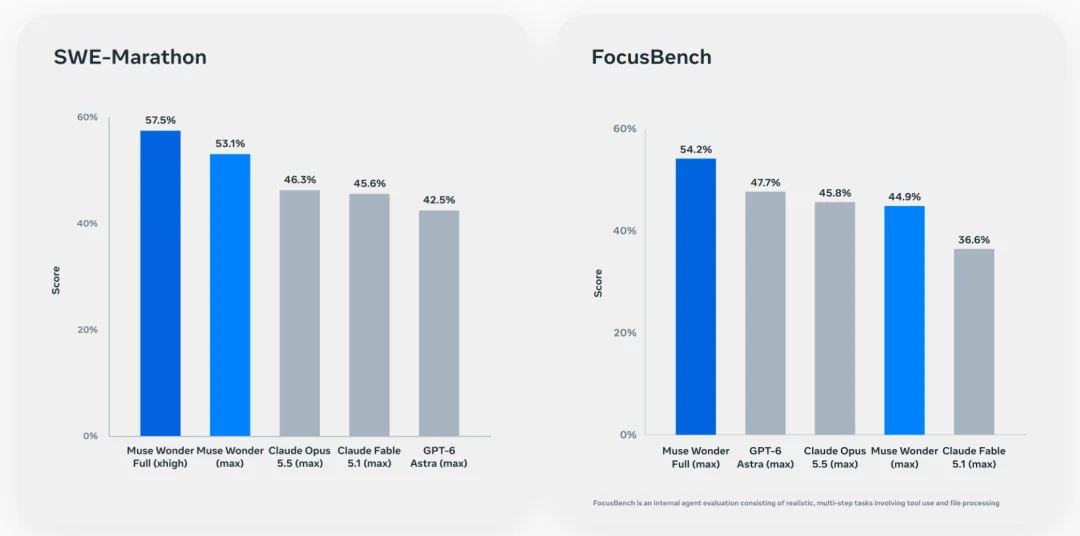
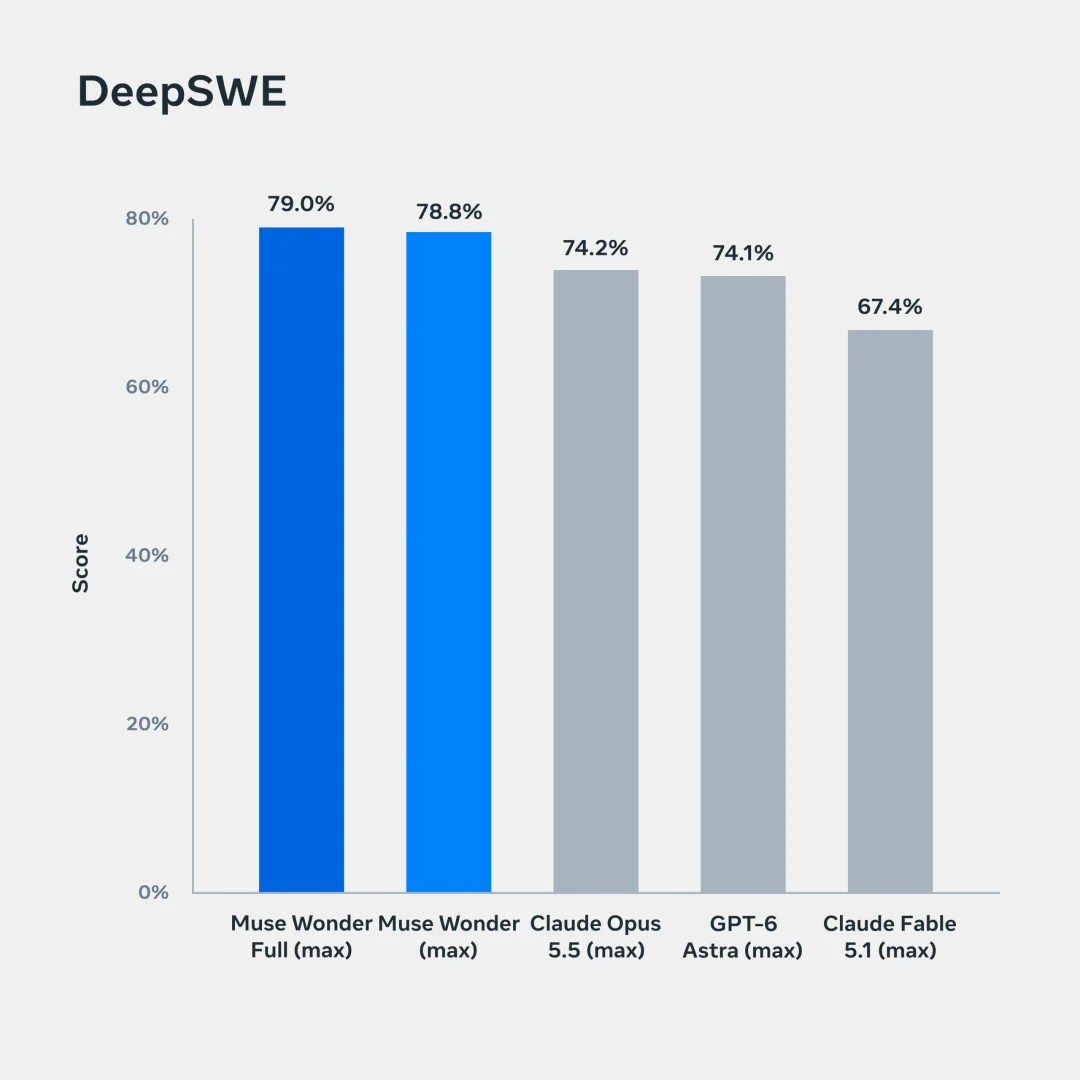
编程能力同样有亮点。尤其是在测试超长周期软件工程能力的 SWE-Marathon 中,Muse Wonder Full 获得 57.5 分,领先 Claude Opus 5.5 达 11.2 分。在 DeepSWE 1.1 中,它也以 79.0 分位居第一。
不过,Muse Wonder Full 尚未实现全面领先。Terminal-Bench 4.0-AA 和 ProgramBench 等编程评测中,Claude Opus 5.5 仍然占据优势;在 HealthBench Pro 健康领域测试中,Muse Wonder Full 也落后于 Claude Opus 5.5 和 GPT-6 Astra。
整体来看,Meta 此次的突破尤其体现在 Agent 执行能力和长周期任务上。相比单轮回答问题,Muse Wonder 系列开始展现出更强的持续工作能力,这也与 Meta 推动个人超级智能的方向相吻合。
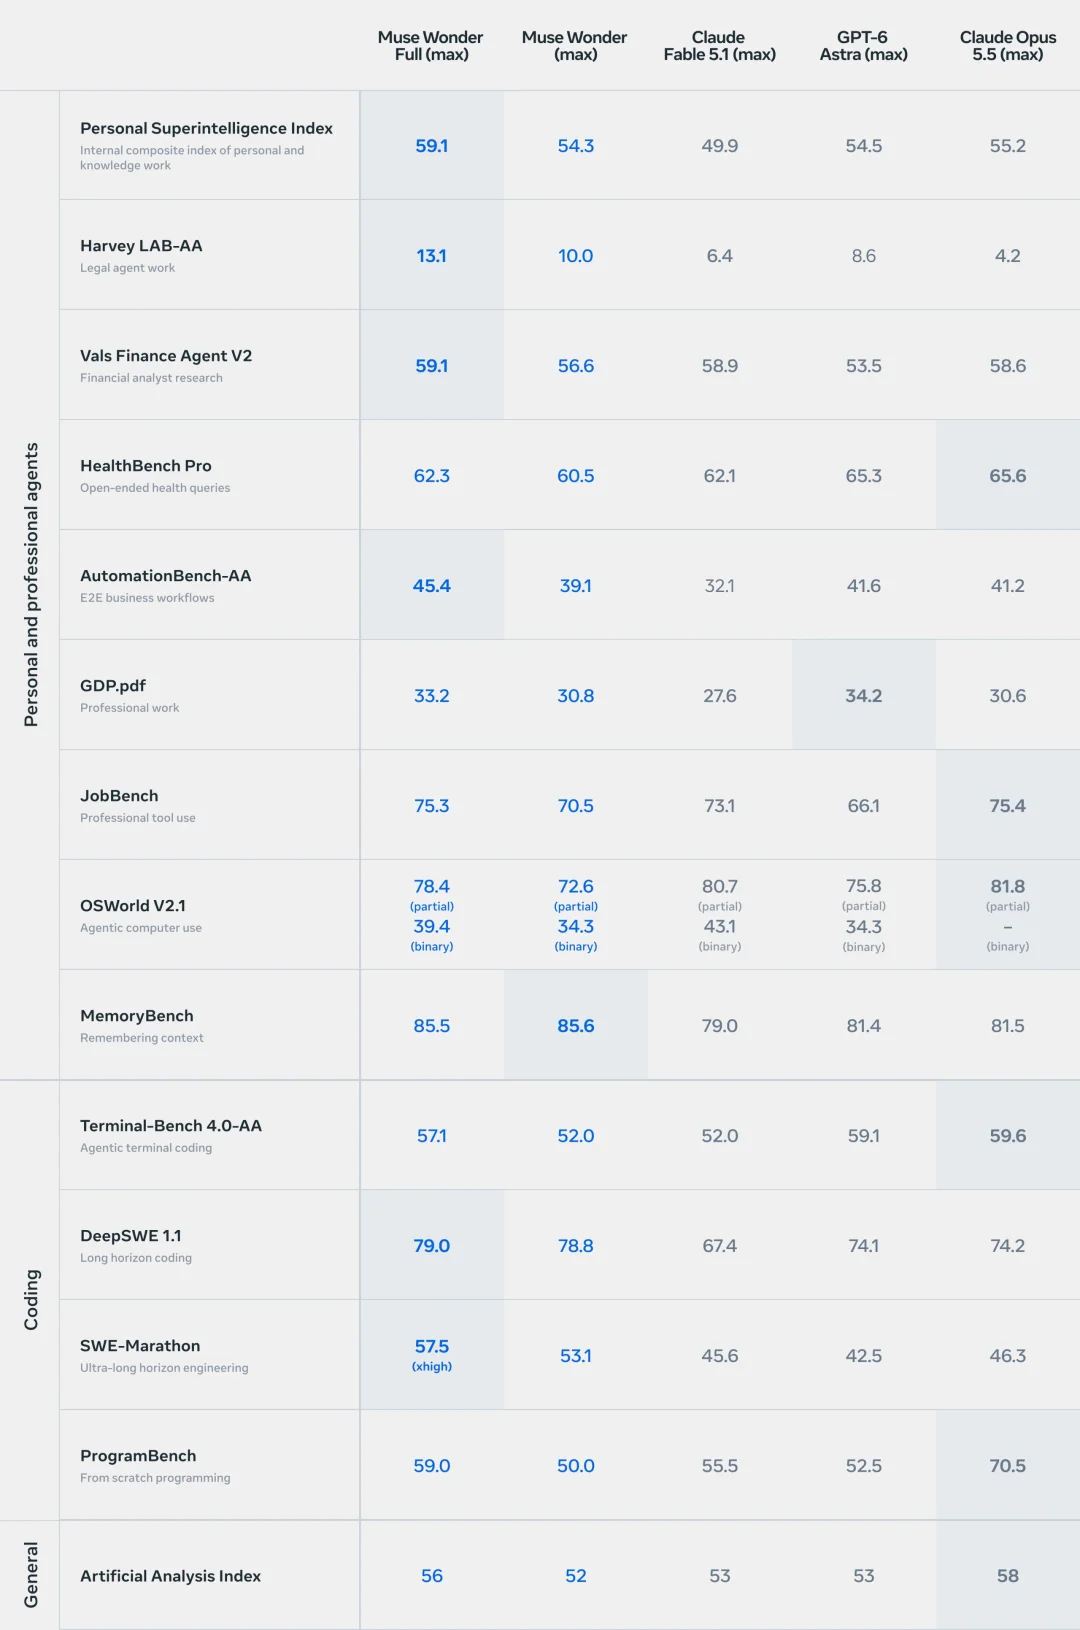
这些结果展示了新模型的整体能力。接下来,我们重点介绍四个与真实任务密切相关的方向:专业领域知识、主动记忆、主动专注和前沿编程能力。
专业领域:处理法律、金融和健康任务
Muse Wonder 和 Muse Wonder Full 能够把专业知识应用到人们在工作和日常生活中遇到的实际问题。例如,理解租赁合同中的条款,分析财务信息,或者帮助用户看懂健康相关资料。
为了评估这些能力,Meta 设置了涵盖法律、金融和健康领域的测试任务。其中,Harvey 的法律 Agent 基准测试(Legal Agent Benchmark,LAB)要求模型阅读原始文件,遵循详细指令,最终完成实际法律工作所需的文档。这类评测关注模型能否理解专业材料,并按照具体要求交付成果。
Active Memory:跨越不同对话,主动找回重要信息
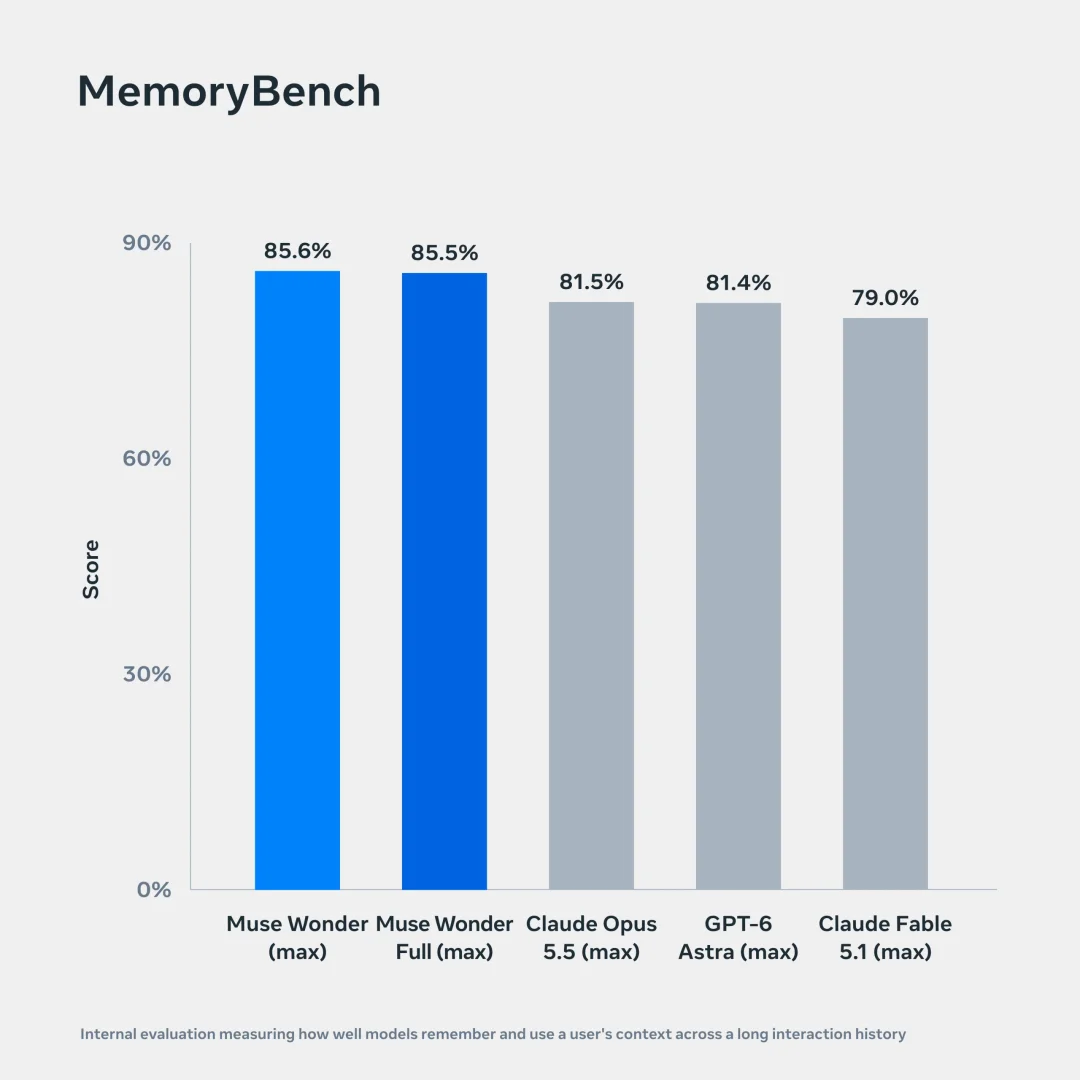
想让个人和专业级 Agent 真正发挥作用,可靠的记忆能力至关重要。模型需要记住重要信息,还要知道过去的哪些信息会在当前任务中派上用场。Meta 把这种能力称为 Active Memory(主动记忆)。
它能够跨越不同对话,持续保留与用户有关的重要上下文,并在执行任务时,主动检索当前需要的具体信息。例如,用户之前已经告诉 AI 自己的偏好、目标或者某项工作的背景,那么在后续相关任务中,AI 就可以重新调取这些信息,避免用户反复交代。
Active Focus:遇到困难继续尝试,持续推进任务
有了相关上下文,Agent 还需要有能力持续完成任务。
Active Focus(主动专注)描述的正是 Muse Wonder 围绕复杂目标持续工作的能力。遇到困难时,模型可以尝试不同的方法;碰到障碍时,会寻找解决路径;获取新信息后,也会相应调整自己的行动。在必要时,它还会主动向用户提出问题,澄清不确定的要求,并在执行重要操作前征求确认。
Meta 通过 FocusBench 评估模型的专注能力,并利用 SWE-Marathon 测试其持续执行任务的表现。其中,SWE-Marathon 主要考察模型能否处理运行时间较长的软件开发项目。
前沿编程:从小型应用到复杂软件开发
编程任务能够同时考验模型的多项能力。开发一款软件,需要持续跟踪需求,在代码库的不同位置进行修改,并经历多轮测试与修复。
Muse Wonder 和 Muse Wonder Full 在编程方面达到了前沿水平,能够支持从小型应用到复杂软件项目的开发。为了提升模型在这类任务中的表现,Meta 使用了各种不同类型、执行周期较长的任务进行训练,让它们能够在反复测试、修改和验证的过程中持续推进工作。
比跑分更重要的能力
面对陌生任务,模型能否举一反三?
两个模型即使在基准测试中拿到了相近的分数,实际使用起来也可能有明显差别。其中一个模型可能只能完成比较熟悉的任务,另一个却能应对更多从未遇到过的问题。
这也是为什么有人批评一些模型过度追求跑分(Benchmaxxing),同时也有人用「大模型味儿」(Big Model Smell)来形容某些模型表现出的综合能力。这些说法背后,其实涉及同一个问题:主流基准测试通常只覆盖少数领域,很难完整衡量模型在各种陌生任务中的能力。
为了研究这一差距,Meta 分析了随着测试时计算量增加,模型在训练后优化阶段重点针对的任务,以及未被重点优化的陌生任务中,性能表现之间的关系。
下图对比了 Muse Spark 1.3 和 Muse Wonder Full。图中每个点代表模型在一种特定推理强度下的表现。横轴表示模型在训练后优化阶段重点关注的任务中的综合得分,即分布内(In-distribution)表现。纵轴则表示模型在训练后优化阶段未被专门针对的任务上的平均得分,即分布外(Out-of-distribution)表现。
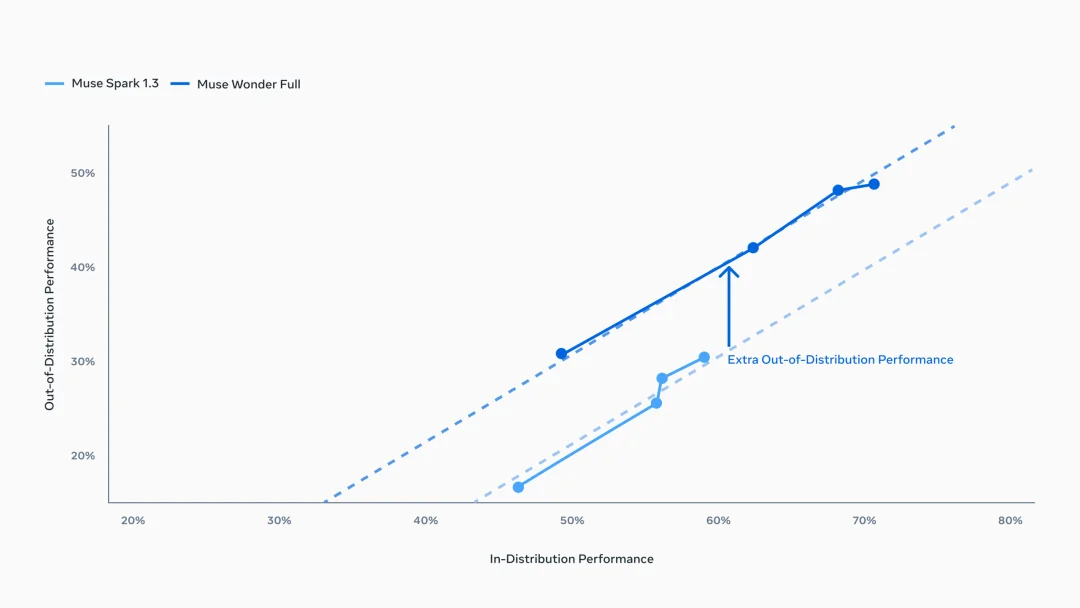
实验发现,随着测试时计算量增加,两个模型在分布外任务上的表现都会提升,而且提升趋势相近。但有一个重要区别。在分布内任务表现相当的情况下,Muse Wonder Full 在陌生任务上的成绩,明显超过了根据 Muse Spark 1.3 原有趋势所能预测的水平。Muse Wonder Full 在熟悉任务上取得一定成绩时,往往也能在陌生任务上表现得更好。
Meta 认为,这种整体提升来自 Muse Wonder 系列更大、更强的基础模型。基础模型越强,训练后优化带来的能力提升,就越容易迁移到没有专门训练过的任务中。
这种泛化能力对个人 Agent 尤其重要。因为真实用户的目标、工具和限制条件有太多种组合,我们不可能在训练阶段提前预想到所有情况。如果 Agent 只能处理训练时见过的任务,那么它在现实生活中的作用就会受到很大限制。因此,让模型具备应对陌生任务的能力,是打造实用个人 Agent 的重要一步。
安全与对齐
当 Agent 开始替用户执行任务
要让每个人都能使用个人超级智能,我们必须持续投入模型对齐和安全研究。个人 Agent 会代表用户采取行动,也可能接触到消息、日历、私人文档等敏感信息。模型需要谨慎处理用户隐私,同时具备抵御恶意使用的能力。
在训练 Muse Wonder 系列时,Meta 重点提升了这两个方面的表现,包括增强模型抵御对抗性指令的能力,以及让模型更加谨慎地处理私人信息。
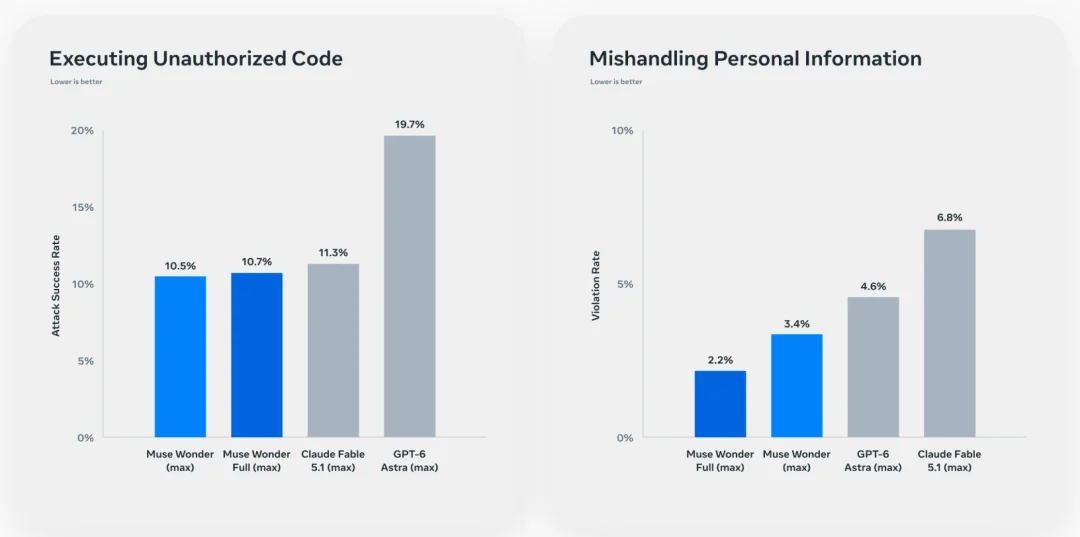
随着模型能力越来越强,Meta 希望帮助用户安全、负责任地使用这些能力。根据 Meta 的《Meta 超级智能扩展框架》,Muse Wonder 配备了 Meta 迄今最强的安全防护措施,以应对 CBRN(化学、生物、放射性和核)相关风险,以及网络安全领域的恶意使用风险。
与此同时,Meta 仍然希望研究者能够利用前沿网络安全能力开展防御性工作。
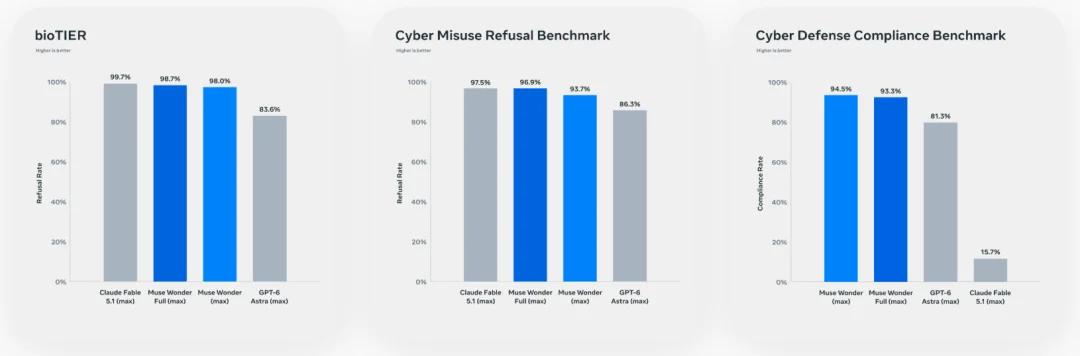
Muse Wonder 是我们迄今对齐程度最高的模型。模型对齐始终是构建个人超级智能的重要组成部分。我们还将在近期公布一份完整报告,提供更多安全评估结果。
Meta 希望 Muse Wonder 和 Muse Wonder Full 能够帮助更多人实现自己的目标,创造自己想要的世界。
博客地址:https://research.meta.ai/blog/muse-wonder
文章来自于微信公众号 “机器之心”,作者 “机器之心”


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
