
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
一道科学问题,AI 可以给出解释,列出步骤,甚至写出分析代码。
但如果再往前走一步呢?
让 AI 打开科研软件,自己完成任务所需的操作,再给科学家一个可以信赖的大结果,它能做到吗?
从核磁共振分析到病理图像处理,从统计计算到物理仿真,这些任务每天都在科研工作中出现。完成它们需要相关科研领域的专业知识,也需要具备在软件里逐步规划和执行正确的能力。
当 AI 真正接手这些工作,会发生什么?
由清华大学研究团队牵头,多所海内外知名高校与研究机构的科研人员共同推出了 OSWorld-Science:一个面向真实科研场景的计算机使用智能体评测基准及配套基础设施。
该 benchmark 包含了 146 项专家设计的任务,涵盖 7 大科学领域、14 种科研软件配置,并被交给 12 个视觉语言模型 测评。
在当前评测中,12 个模型的平均任务得分仅为 34.3%。
这里的得分衡量任务完成程度,并不等同于成功率。但它已经让一个问题浮出水面:
当 AI 被融入真实科研流程,从理解问题到自主实现科研流程、交付可靠结果,还需要完成哪些工作?
假设一位研究者要分析一张病理图像,并知道应该使用什么分析方法,这对于得到结果而言并不足够。接下来,他还需要打开软件、导入图像、配置参数、运行分析,再保存和导出结果。每一步都可能影响最终产出:软件中的某个选项没有设置好,文件没有正确保存,或者处理结果没有达到要求,都可能让前面的工作无法被后续使用。
科研人员需要的,是一条能够稳定走完、结果能够核验的工作流程。
OSWorld-Science 将这样的需求写进了任务设计。在 Mnova 中完成核磁共振分析,在 SAS 中开展统计计算,在 QuPath 中处理病理图像,在 ANSYS 中进行物理仿真。领域专家把真实研究流程转化为任务,也为这些任务设定了验证标准。智能体需要在虚拟机中,通过键鼠或终端操作软件。每次行动之后,再根据新的界面状态决定下一步。最终,评测依据的是任务结束后的文件产物与应用状态。换句话说,模型描述自己完成了什么,还需要由实际结果来证明。
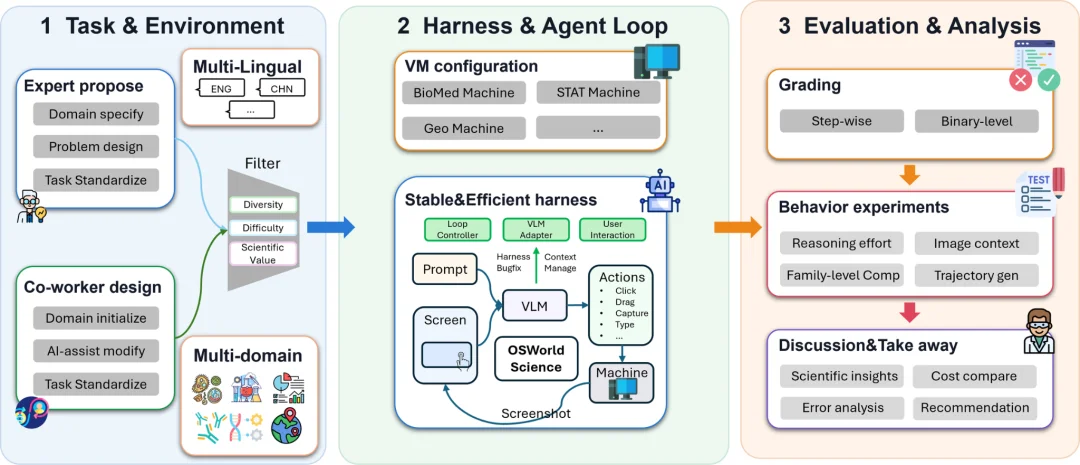
图 1|OSWorld-Science 设计流程框架。来源:论文原图。
为了让不同模型的结果可以比较,团队基于 OSWorld 的多模态 PromptAgent 进行了科学软件适配,提供统一的提示与交互流程,并采用一致的任务步数预算和基础回复长度限制。
请求、响应、令牌消耗与执行日志也会被记录下来。
这样,研究者既能看到模型最终交付了什么,也能回到过程中,查看它是如何完成、又是在哪里遇到困难的。
在 146 项任务上,Claude Fable 5.1 以 73.7% 的平均任务得分领先。
Claude Opus 5、GPT-6 Astra 和 GPT-5.6 sol 的得分分别为 57.9%、57.4% 和 50.1%。
但如果把总榜拆开,按学科来看呢?
在统计任务中,各模型都表现较好。但是到了化学任务,只有少数模型,如 Claude Fable 5.1 和 Claude Opus 5 的得分能够超过 20%。GPT-6 Astra 在医学影像任务中达到 69% 的得分率,却在化学任务中的表现不佳。
由此可见,同一个模型,进入不同科研领域,可能呈现出不同的能力边界。
这也让科研场景中的模型选择变得更加具体:总榜可以提供参考,但真正需要比较的,是模型能否完成相应科研领域的实际工作。
除得分率外,成本同样是评估模型科研执行能力时不可忽视的重要维度。本次评测显示,得分最高的模型并非成本最高的模型,表明模型性能与调用成本之间并不是简单的线性关系。同时,低成本的模型虽然能够完成部分科研任务,但在任务完成度、执行稳定性和最终结果质量上,与高性能模型相比仍存在明显的差距。
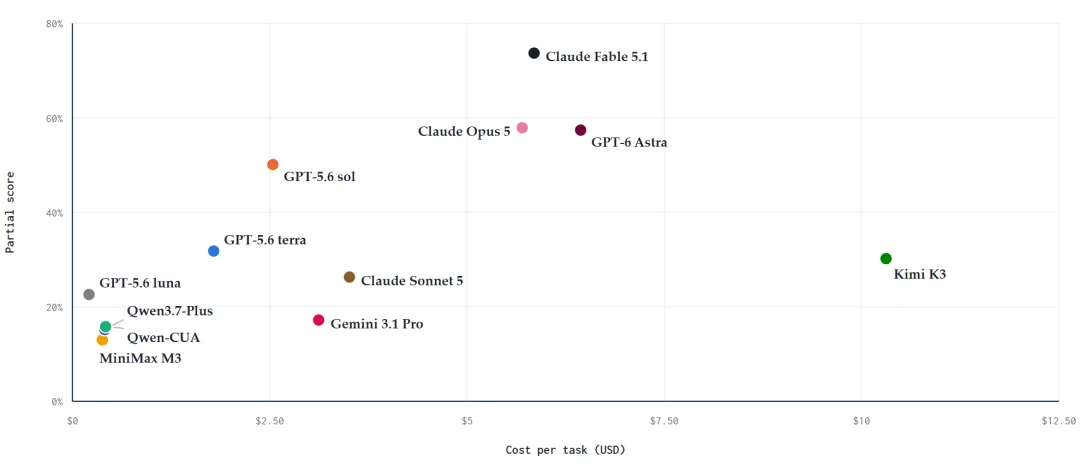
图 2|成本与表现对比。横轴为每项任务的平均 API 成本,单位为美元;纵轴为平均任务得分。
另一个有意思的结果,来自模型之间的输出量差异。
Claude Fable 5.1 平均每项任务输出约 2.1 万 tokens,得分为 73.7%;Gemini 3.1 Pro 平均输出约 15.7 万 tokens,得分为 17.2%。
这里的输出量包含推理 tokens,也不能单独代表费用。输入 token 量、模型定价和反复交互都会影响最终成本。
但这组对比仍然提示了一个值得追问的问题:
更多的输出,究竟有没有让任务被更高质量地完成?
有些困难,只有回到实际操作过程,才能看清楚。
在生物学领域软件 Mnova 的一次运行中,模型需要处理 Bruker 一维 H 谱,把 6 - 溴吲哚的每个氢归属到谱峰。Claude Sonnet 5 模型因坐标映射偏差,在同一个错误位置重复点击了 39 次,最终耗尽预算而任务失败。
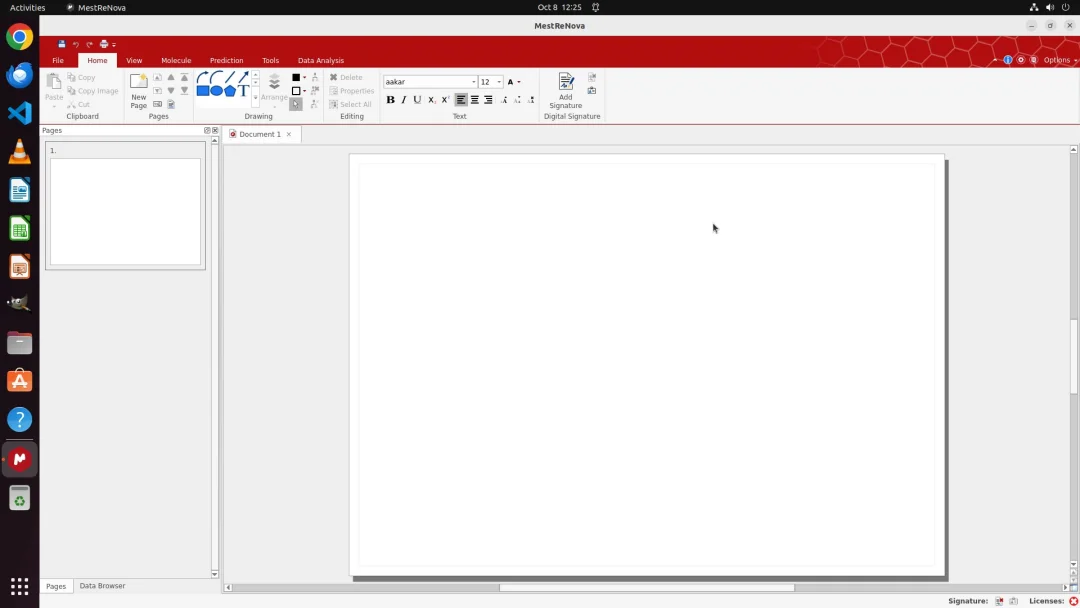
图 3|科研软件范例 Mnova,界面和 PowerPoint 非常相似,也是模型理解软件操作的障碍之一。
第一次点错,可能只是定位偏差。
但连续点错之后,智能体需要识别错误模式与反思改变行为,如:判断界面有没有发生预期变化,当前操作是否可能无效,接下来需不需要换一种方法。
如果没有这一步,在失败操作之后的行为就可能变成更多的失败重复。
在对已公开轨迹的分析中,团队发现,61% 的失败运行没有留下可评分产物,同时耗尽了步骤或时间预算。这也让 “完成任务” 的含义变得更加清楚:即使已经做过部分分析,如果没有及时保存、导出和核验,工作仍可能停留在无法交付的状态。长流程科研需要智能体持续判断当前进度,识别错误操作,并及时调整策略来交付正确的科研结果。因此,智能体要在理解专业问题、找到正确的界面入口、处理环境中的异常等能力协同配合的条件下,才能高效准确地完成复杂、长程的真实科研任务。
软件成功运行,也不意味着科学任务已经结束。
在 ANSYS Fluent 的圆柱绕流伴随任务中,Kimi K3 发现阻力读数为零。
这个异常让它重新检查设置,随后修正了漏选壁面的问题,最终获得满分。
在这个过程中,结果并非只是被读取出来直接交付,它也成为了模型检查前面自我操作正确性和合理性的依据。
不过检查本身也有可能出错。
一个化学任务的案例显示,智能体进行了多次格式转换和内部一致性检查,却仍然重复同一个立体化学错误。
为什么多检查几遍,还是没有发现问题?
因为如果检查始终围绕同一个错误表示展开,一致的结果,也可能只是同一个错误被保留了下来。
科学验证需要独立的证据,并允许这些证据推翻原先的判断。
原始数据、物理约束和精度要求,都可能成为这样的依据。智能体需要做的,是把结果重新放回这些任务要求和相关科学规律中检验结果的准确性和合理性。
这也让科研执行中的 “可靠” 有了更具体的含义:能够独立完成操作,发现结果中的异常,并据此修正自己的工作。
把不同学科的任务放在一起看,OSWorld-Science 关注的是一项贯穿始终的能力:让 AI 将专业知识落实到科研软件操作中,来将具体科研任务自动化处理为可验证的科研产出。
界面定位决定操作能否落在正确位置,环境适配决定流程能否继续,进度检查帮助智能体跳出无效循环,科学验证则决定最终结果能否被信任,这些环节共同决定着任务能否顺利完成。
因此,改进科研智能体需要回到完整的工作流程中。我们需要观察它在哪里停住,哪些错误反复出现,以及如何改进或者提供反馈来帮助它继续推进。
OSWorld-Science 提供的,正是一组可以持续评估和比较这些能力的任务与运行记录,来更好的帮助研究者评估智能体的科研执行能力。
这项研究汇聚了来自清华大学、加州大学洛杉矶分校、耶鲁大学、卡内基梅隆大学、加州大学伯克利分校、斯坦福大学、浙江大学、香港大学、东京大学等机构的研究者,并获得 Kimi、Z.ai、Alibaba 等公司基础模型部门的支持。
跨学科合作,也让领域专家的实际经验能够进入智能体研究。
同时,研究团队欢迎更多研究者加入到任务共建中:
一方面,我们计划补充更多科研领域中的真实问题,包括并不限于无机化学、生命科学、力学、材料学、地球科学、社会科学等方向。我们希望任务具有实际的科研价值和能够明确验证的结果。
另一方面,是设计更全面的跨软件 AI 工作流。例如,在一个蛋白质结构分析任务中,智能体需要先在 PyMOL 中打开蛋白质结构、定位目标结合口袋并完成关键残基测量;随后将结构导入 AutoDock Vina 进行小分子对接;再将对接结果重新导回 PyMOL,可视化配体结合构象及关键相互作用;最后使用 Python 对不同候选分子的 docking score、关键距离和相互作用数量进行汇总,并核验排名靠前的候选是否满足预设结构约束。这类综合各类软件操作能力解决实际问题的工作流,也是我们关注的焦点。
如果你的研究中,也有一项 “希望 AI 能接手并能够明确验证结果” 的工作,欢迎把它带进 OSWorld-Science。
146 项任务只是一个起点。当 AI 开始进入科研软件,值得持续检验的问题也变得更加具体:它能否把每一步操作,最终变成一份可信、可用的结果?我们想一起探索问题的答案。
核心作者:
团队指导:
文章来自于"机器之心",作者 "机器之心"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
