
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
就在今天深夜,Meta自豪宣布:自家的王炸大模型——Muse Wonder和Muse Wonder Full发布!
Muse Wonder 用于快速前沿性能,Muse Wonder Full 则是该模型的完整版本。
小扎声称,创立Meta超级智能实验室一年多,Muse Spark 是MSL的第一个模型系列,而Muse Wonder 则是一个更大、更先进的模型,达到了前沿水平。
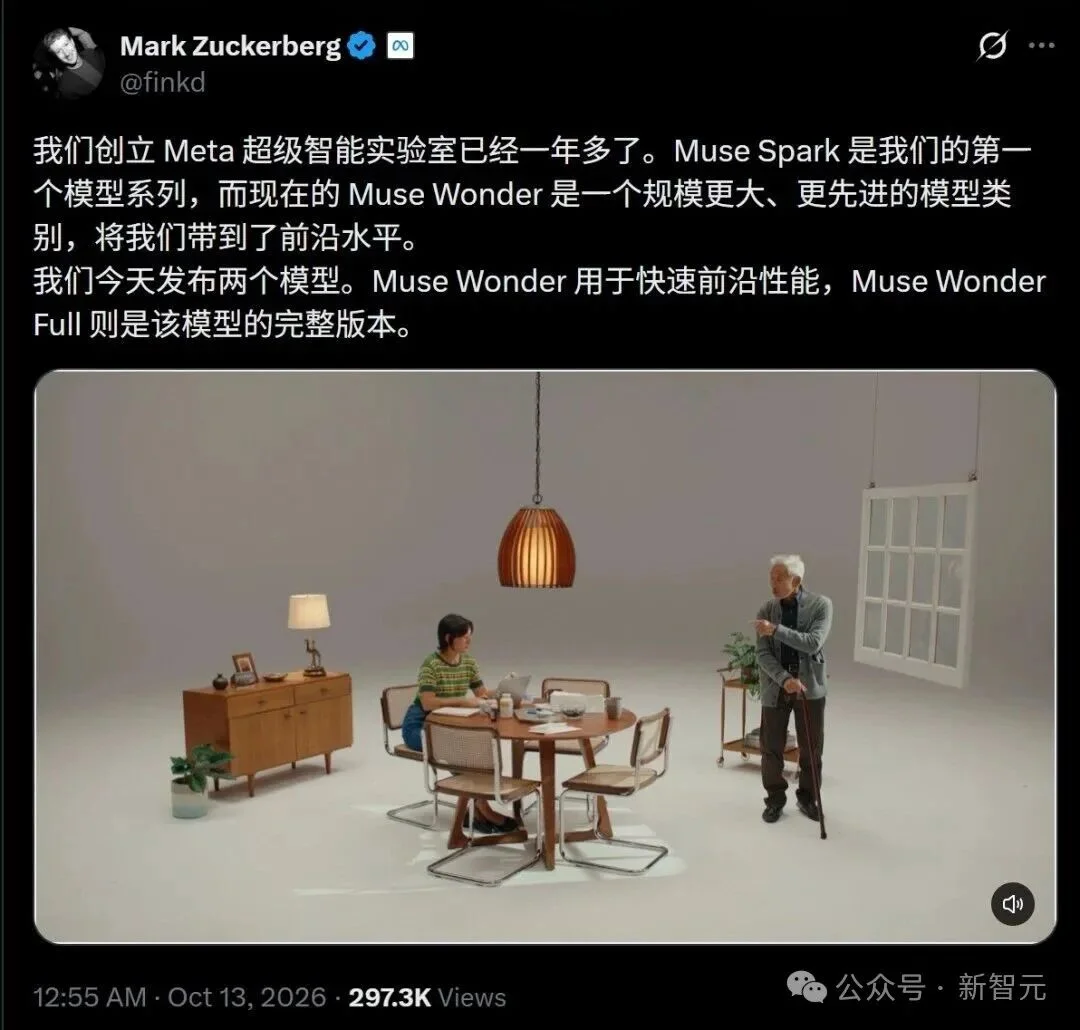
这个基准测试图,可是相当惊艳。在多个榜单中,Muse Wonder的评分直接超越 Astra 和 Fable 5.1,甚至领先Opus 5.5!
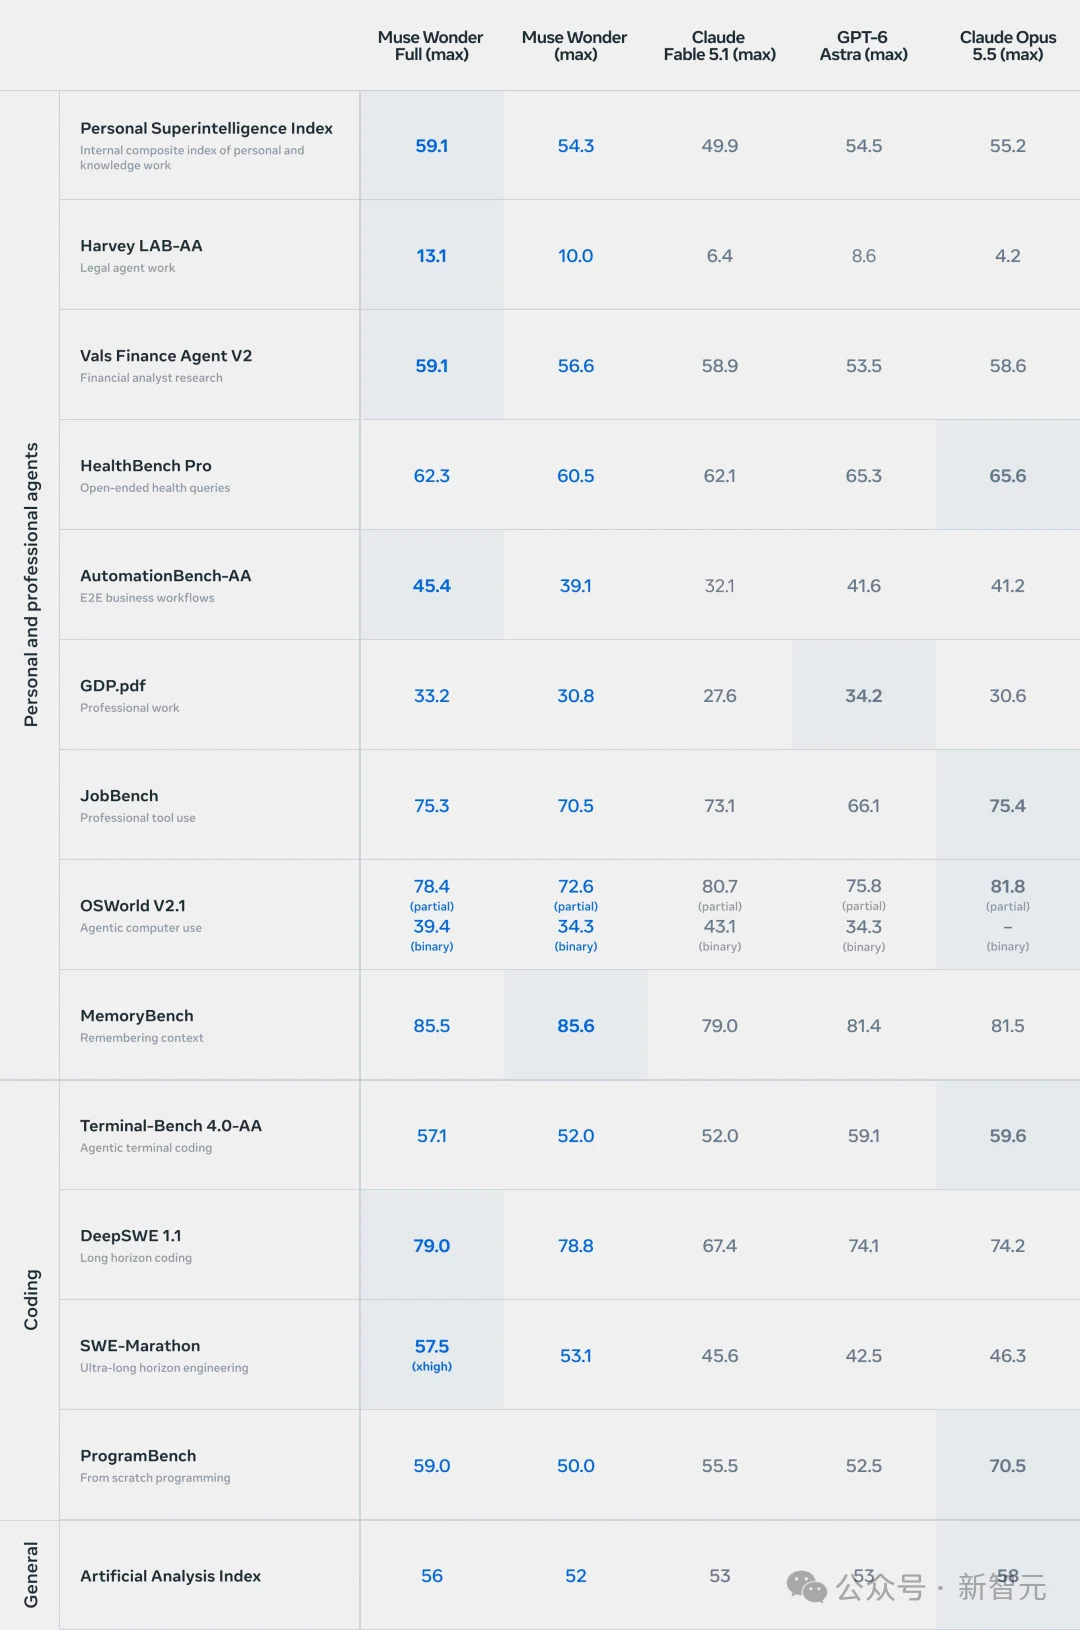
看到跑分后,全网直呼:Meta发布了一款Fable/Astra 级别的模型!Muse Wonder的表现,已经和Fable 5.1相当。
根据跑分,Meta在长周期软件工程上正式超越OpenAI,护城河已彻底蒸发。
Artificial Analysis的测试结果显示,Muse Wonder Full(Max)在多项测试挤入前 3。
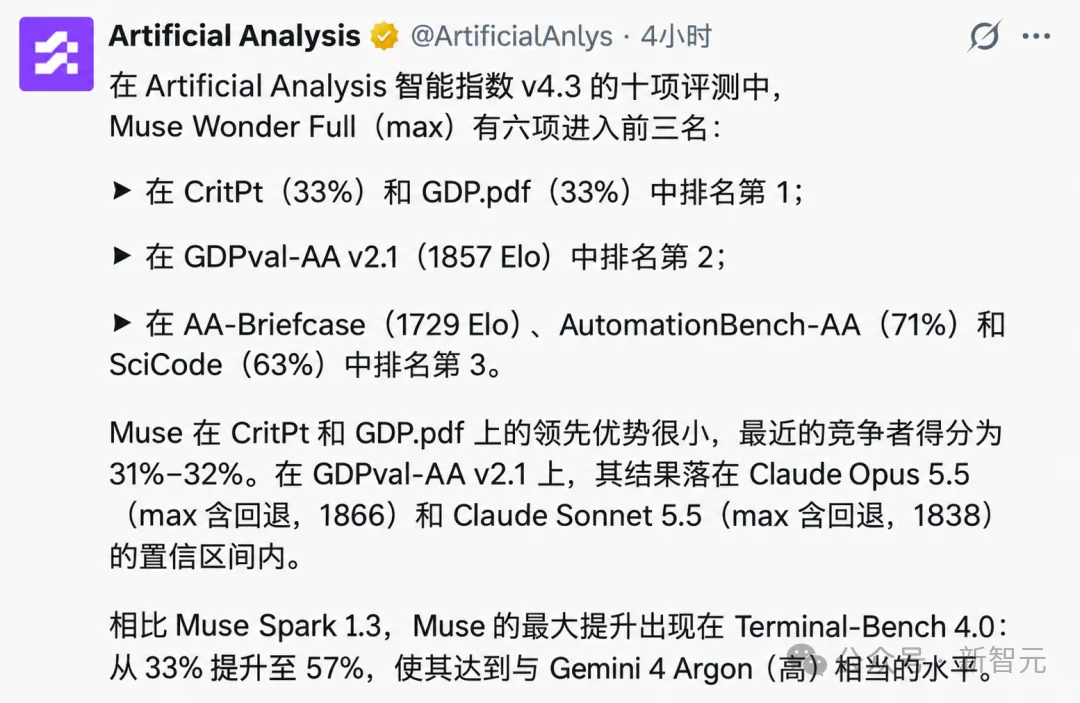
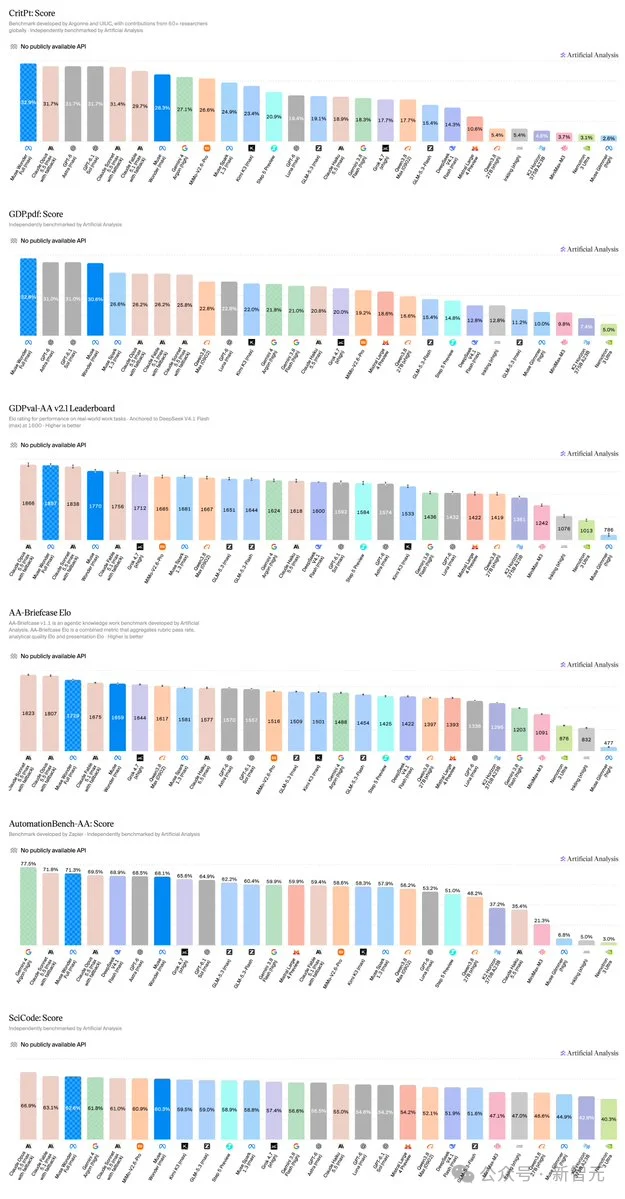
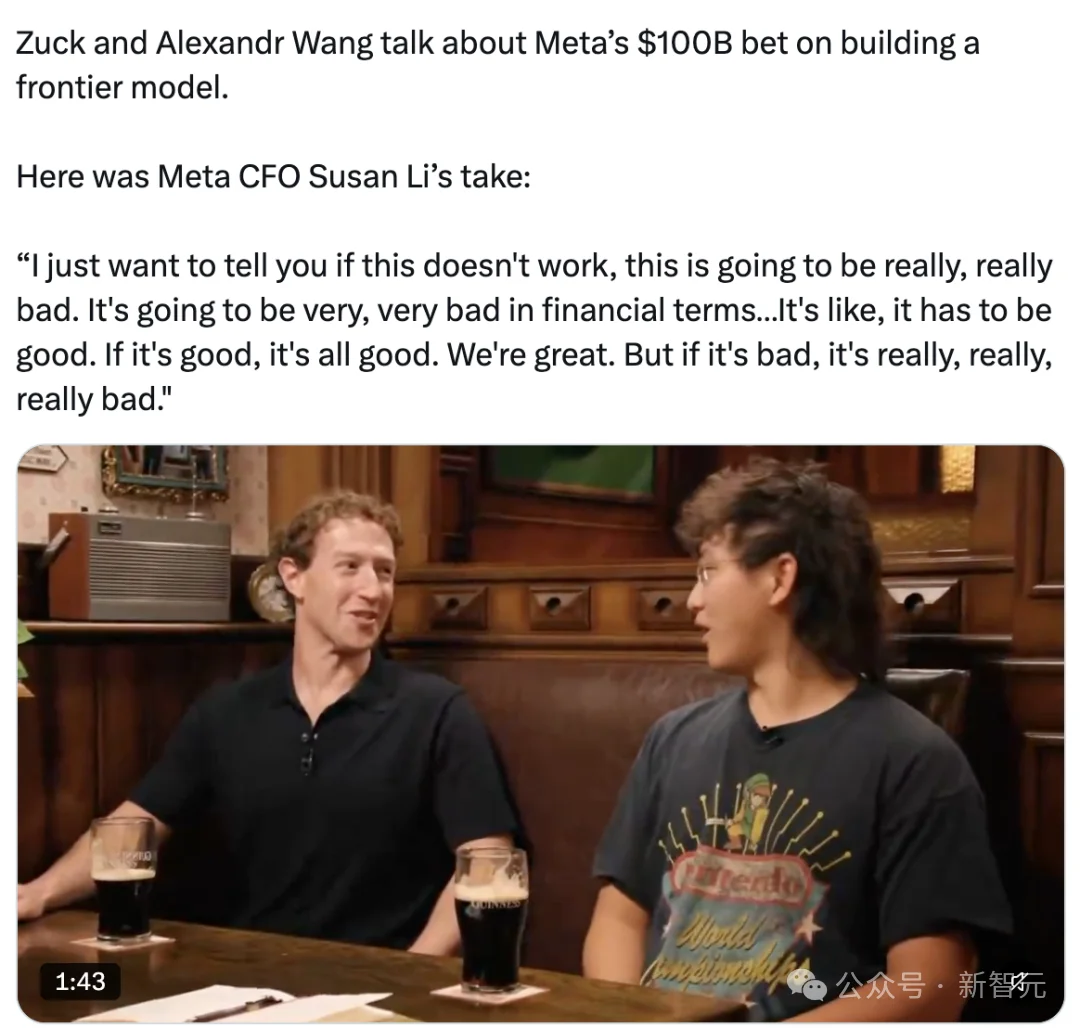
更夸张的是,小扎和Meta首席AI官Alexandr Wang在播客里透露,为了这个模型,Meta砸下了超过1000亿美元的基础设施豪赌!
然而,实测的开发者们,很快发现不对了。
很多人晒出实测demo,说Muse Wonder就是一坨。
有人直言:这是连Gemini看了都要甘拜下风的极致刷分作弊!
砸了千亿美金的Muse Wonder,难道只是纯靠刷榜的产物?
实测翻车:连3D游戏都搞不定
赶超Astra和Fable的模型,居然被Meta做出来了?
Muse Wonder刚刚开放API调用,立刻涌入了一大批开发者。
结果,Muse Wonder翻车了。
有人说,这个模型就是一坨,是个刷分到极致的产物。
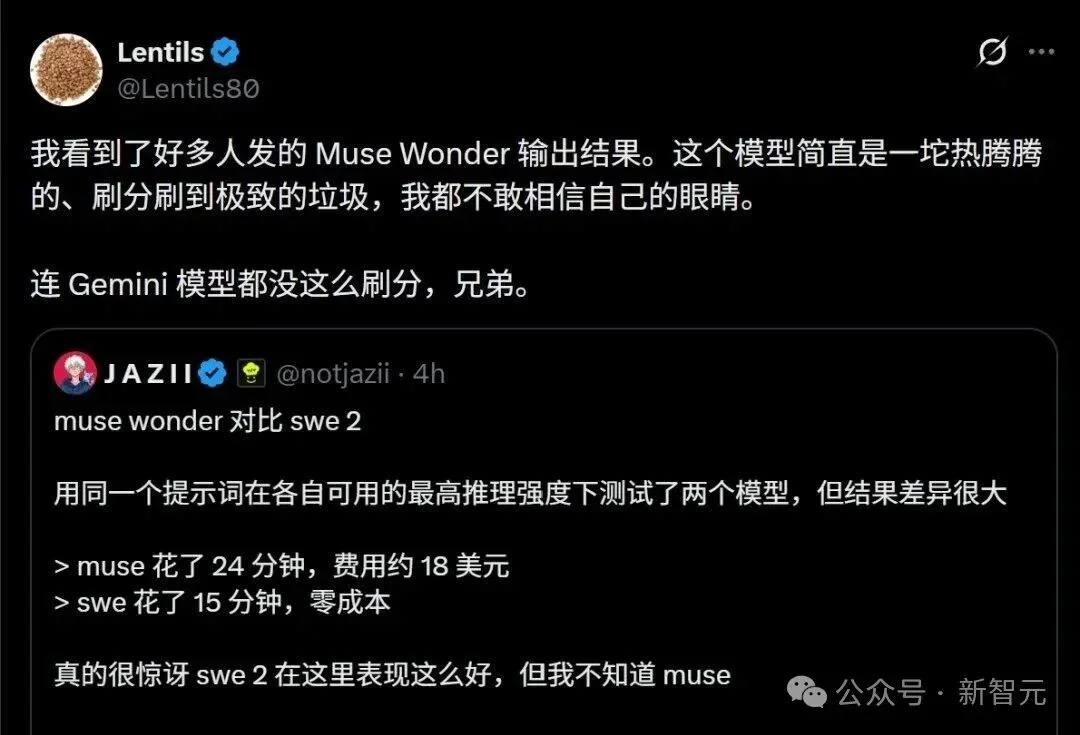
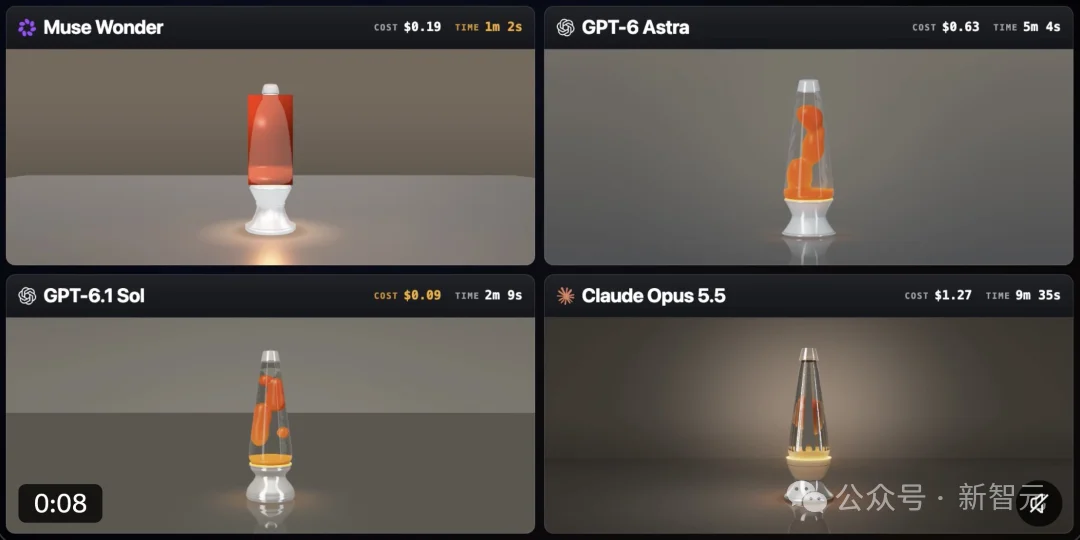
同一个提示词下,它在最高推理档位和其他模型差异极大。
显然,这个模型在评分上高于 astra 和 fable 5.1,但在测试中表现比两者都差得多。

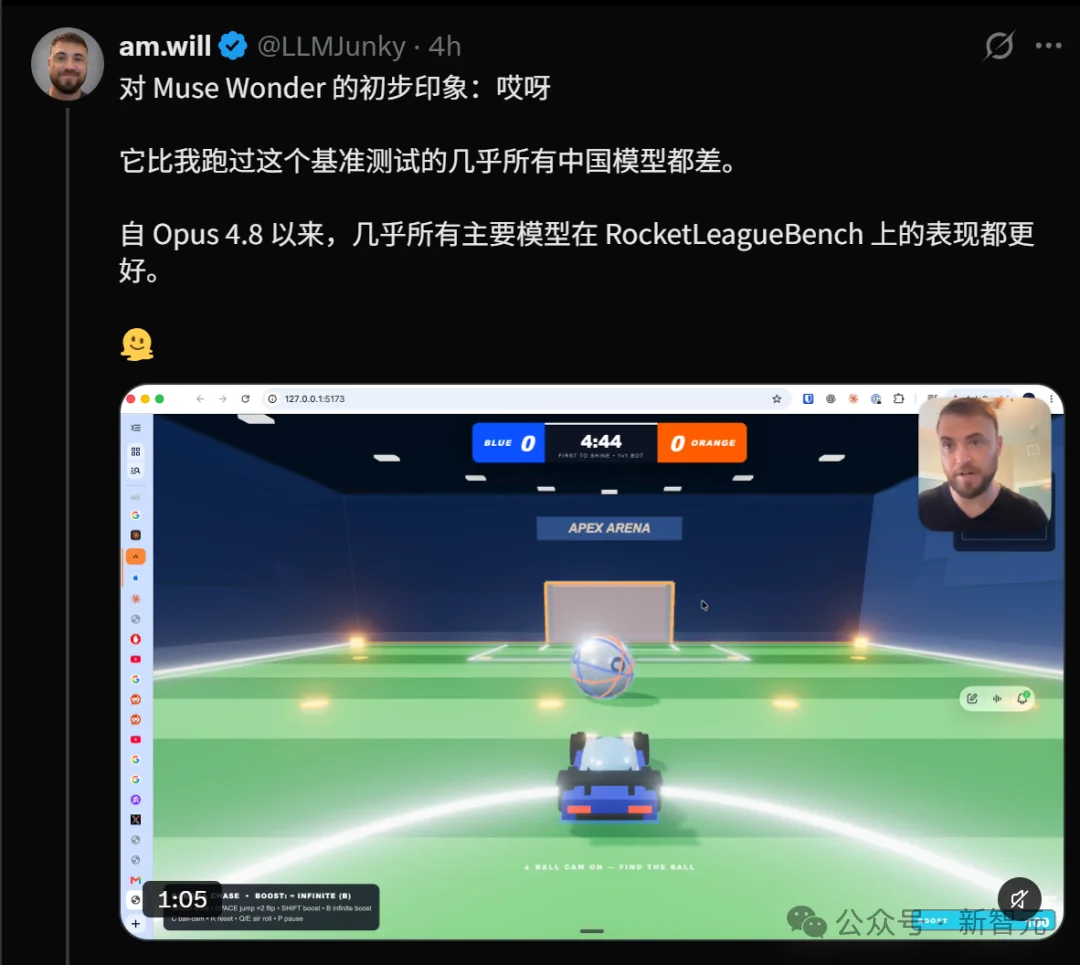
在一个RocketLeagueBench的测试中,它的测试结果惨不忍睹。
开发者说,Muse Wonder给他的初印象极差。自Opus 4.8以来,几乎所有主要模型在这个榜单上的表现都比它好。

面对质疑,Meta首席AI官Alexandr Wang回应说:「整个团队现在觉得自己很蠢,但这是事实,我们确实没有明确地在3D演示游戏上训练我们的模型……但不后悔,请大家在实际的编码工作中试试它!」
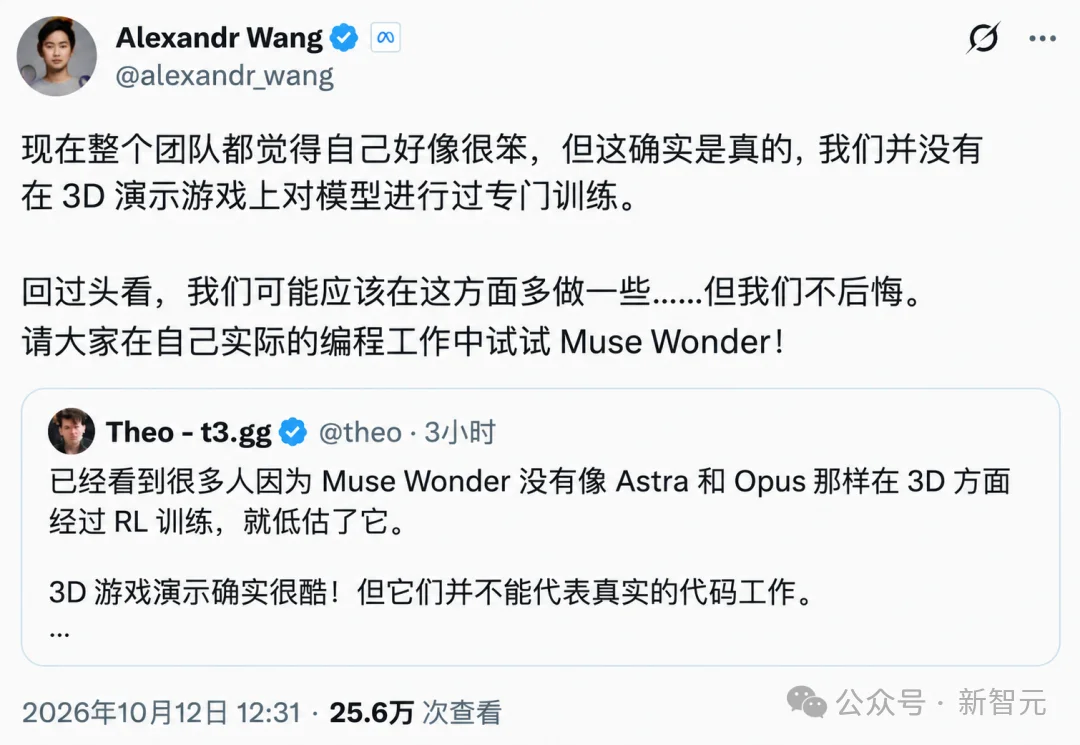
不过,事情的真相真的只是「没练过3D游戏」这么简单吗?
有人维护Meta说:「3D游戏演示很酷,但它们完全不能代表真实的代码工作!Wonder是一个令人难以置信的代码模型,别忽视它。」
但也有人指出:首先,这意味着这个模型的泛化能力绝对糟糕。其次,视频游戏演示也是通过代码做出来的。
这次没,小扎是真有备而来。
在官方博文中,Meta毫不避讳地直接把枪口对准了当前大模型界的两座大山:OpenAI 的 GPT-6 Astra 和 Anthropic的Claude Opus 5.5。
Meta骄傲地宣布,历经14个月从底层技术栈的彻底重构,Muse Wonder的诞生,标志着Meta正式踏入了「前沿」梯队。
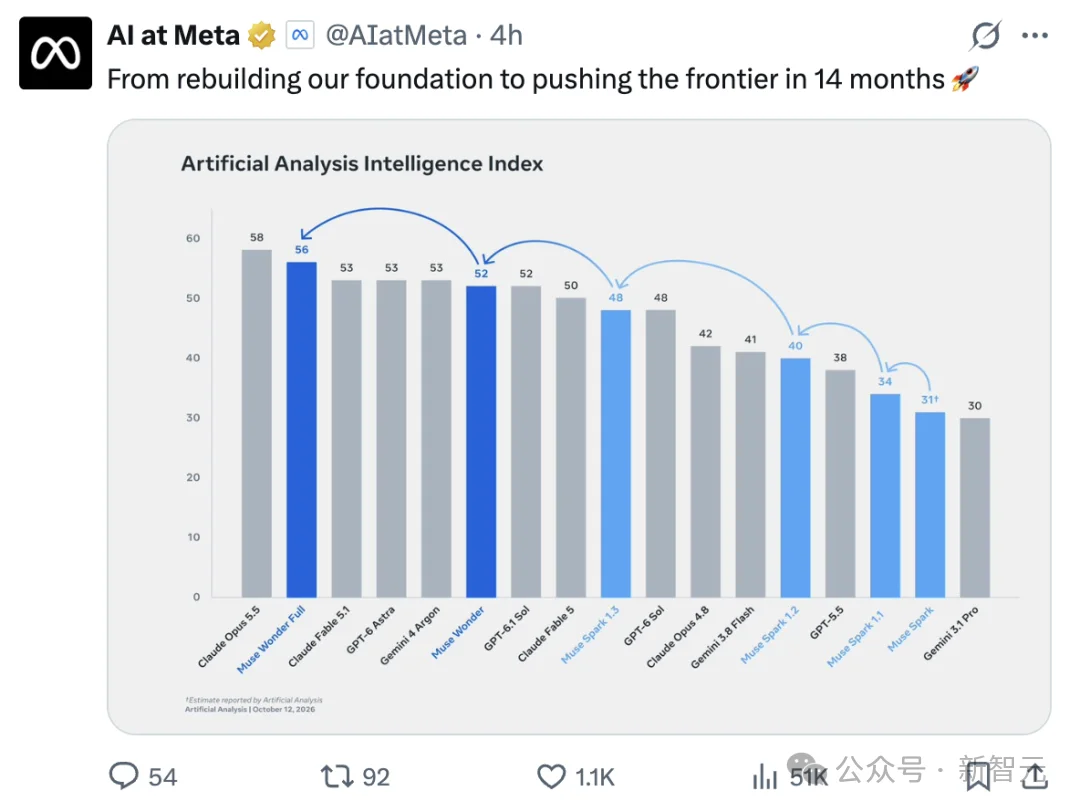
在多个核心领域,它不仅追平,甚至超越了Astra和Opus 5.5!
官方博客中,Meta详细列出了Muse Wonder的几大「碾压级」杀手锏:
替人办事的「智能体(Agent)」能力:超越双王
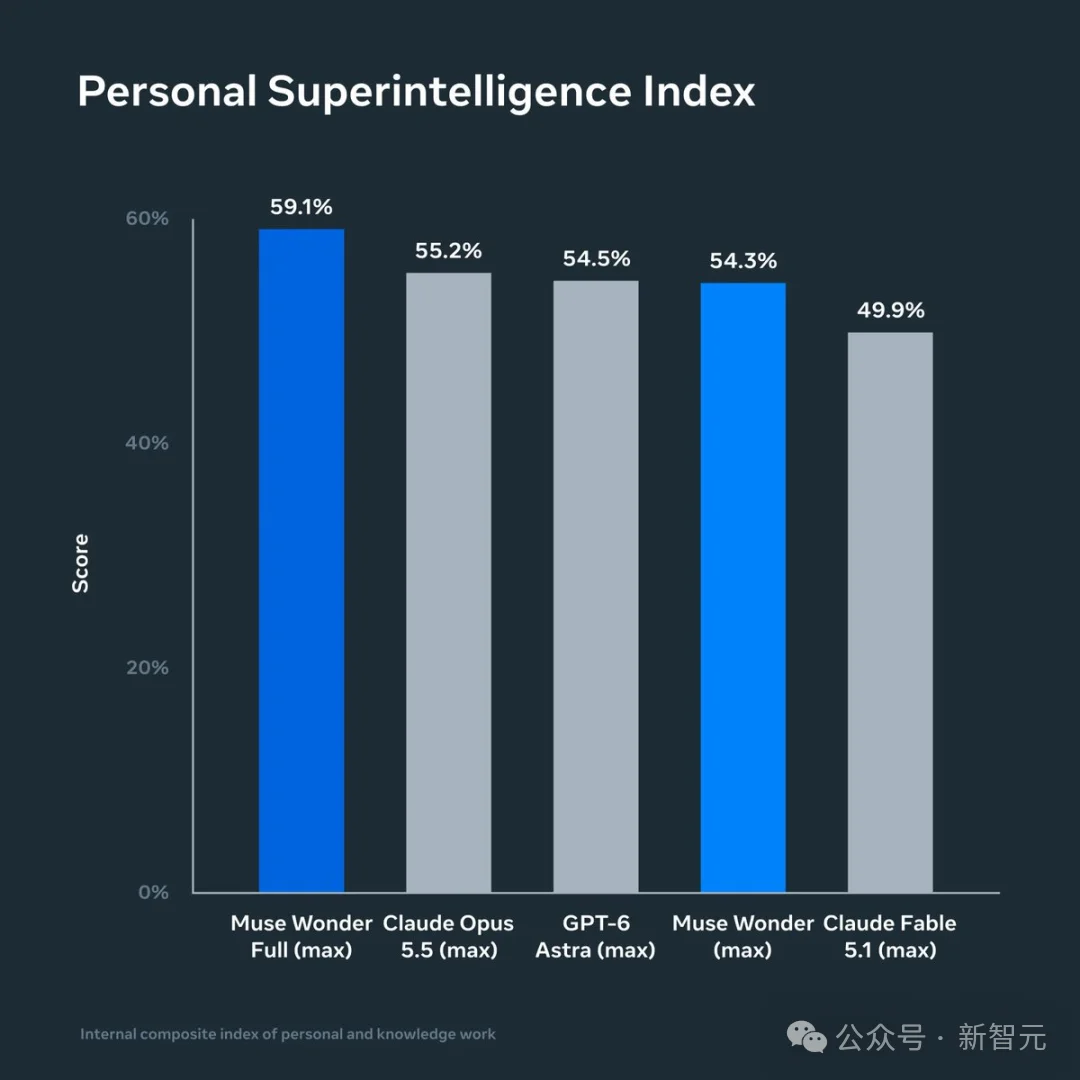
Meta的终极目标是「个人超级智能」。在Meta自建的**个人超级智能指数(Personal Superintelligence Index)**中,Muse Wonder Full 拿下了 59.1分 的高分,直接将 Claude Opus 5.5(55.2分)和 GPT-6 Astra(54.5分)斩于马下。
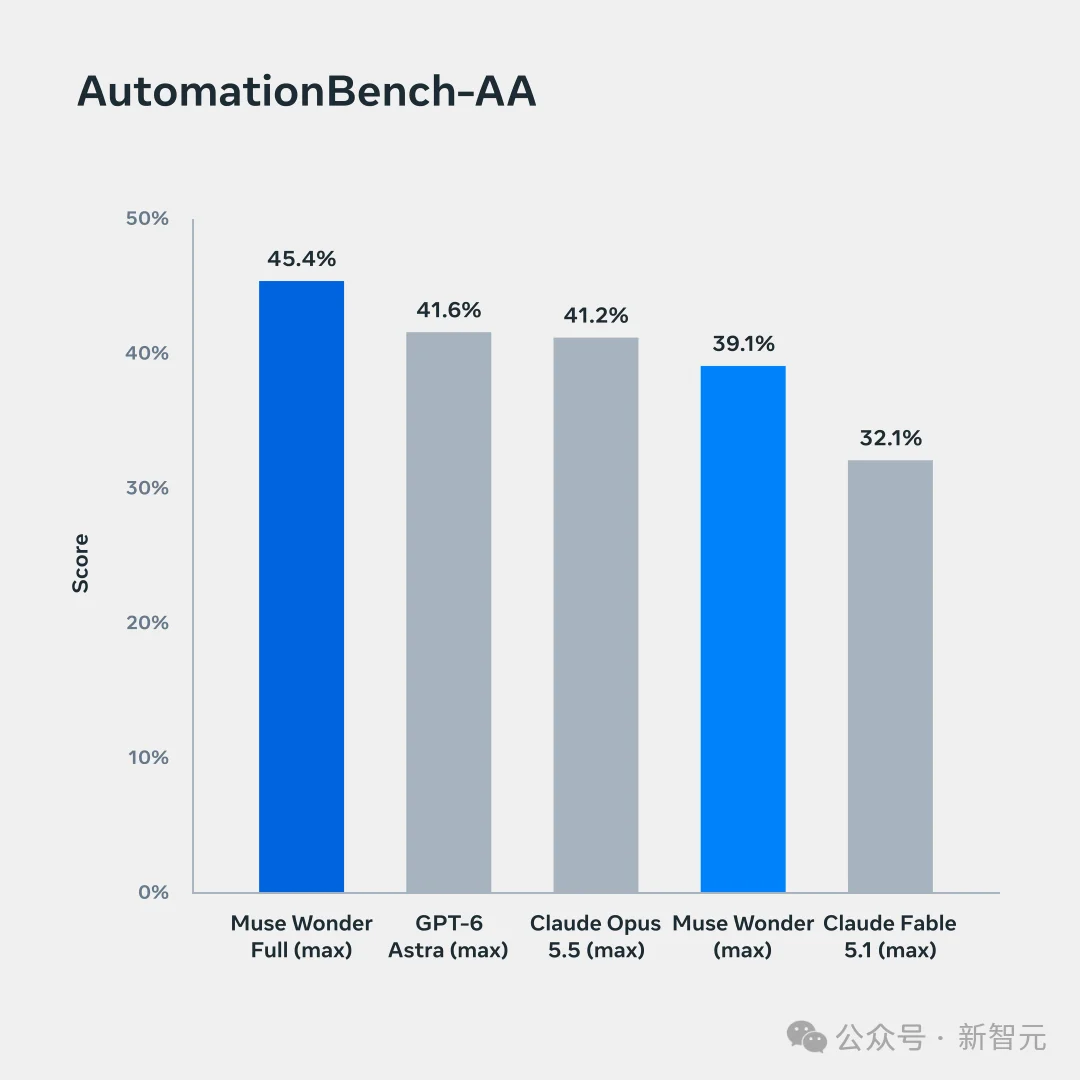
在跑完整业务流程的 AutomationBench 测试中,Muse Wonder Full 以 45.4分 同样力压所有最高分仅为41.6的竞争对手。这意味着,当你把一整个复杂的现实任务丢给AI时,Muse Wonder是目前世界上最靠谱的执行者。
独家绝技:Active Memory(主动记忆)与 Active Focus(主动专注)
这是本次发布的绝对核心卖点,也是Muse Wonder能够干翻对手的底气所在。
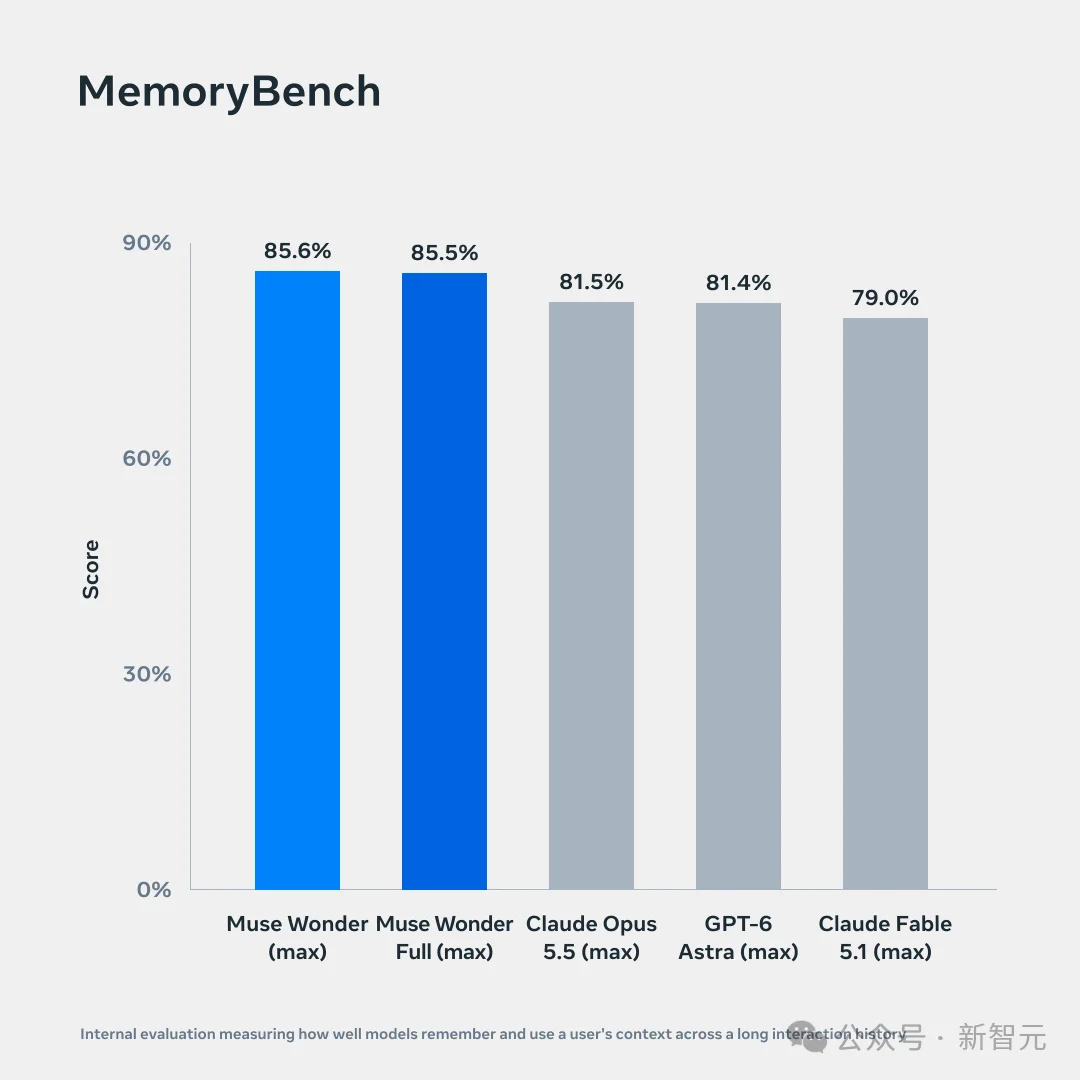
现有的模型聊久了就容易「失忆」。但有了「主动记忆 」,Muse Wonder能在跨度极大的对话中记住你的偏好。
在掺杂了大量干扰和矛盾信息的 MemoryBench 测试中,Muse Wonder Full 拿到了 85.5分,稳压 Claude Opus 5.5 的 81.5分。它甚至能自己判断以前的哪些旧信息对当前的新任务有用,并主动调取。
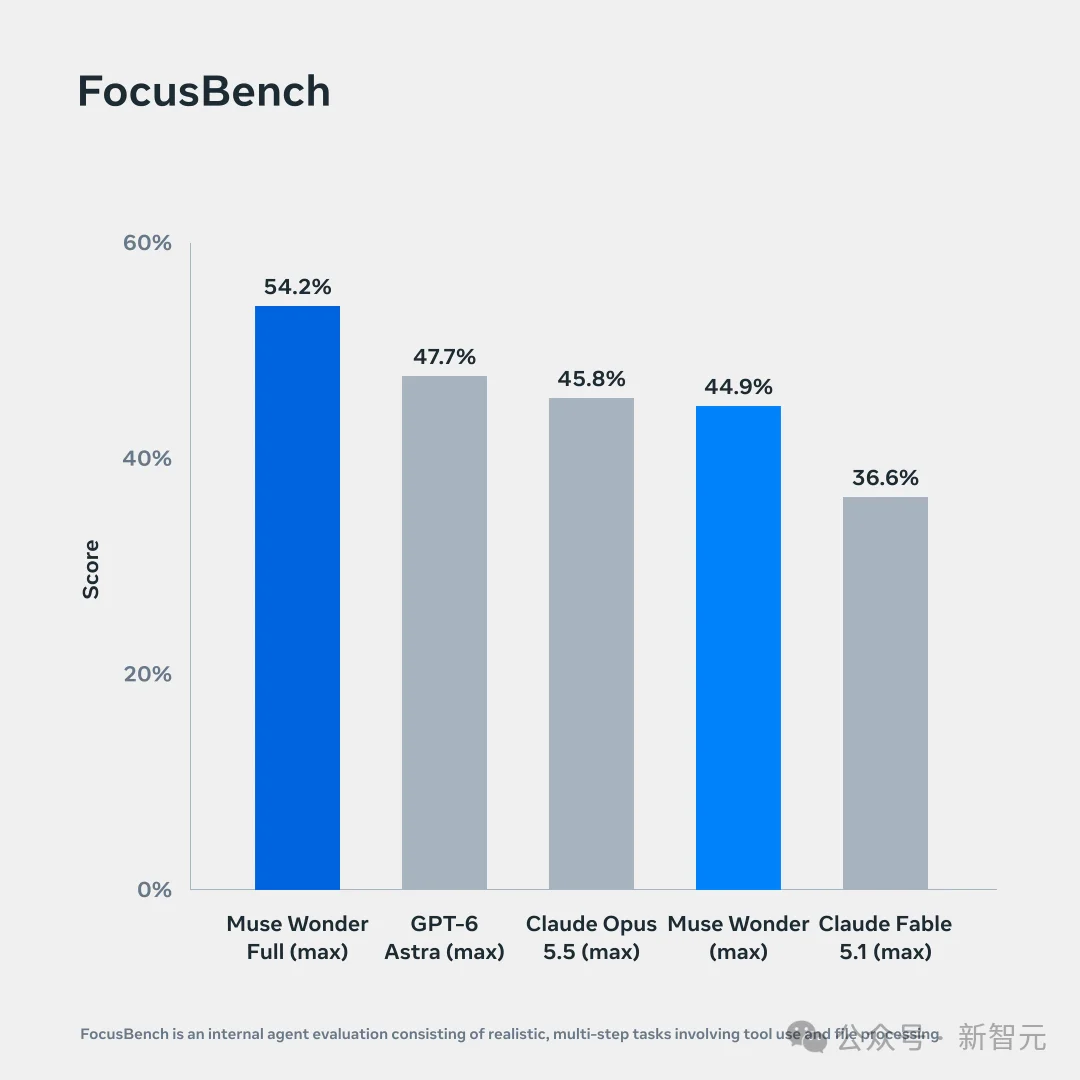
主动专注(Active Focus),则指AI「死磕到底」的能力。一条路走不通就换一条,遇到卡点自己想办法。
在测试模型多轮交互克服现实障碍的 FocusBench 中,Muse Wonder表现出了极强的韧性。
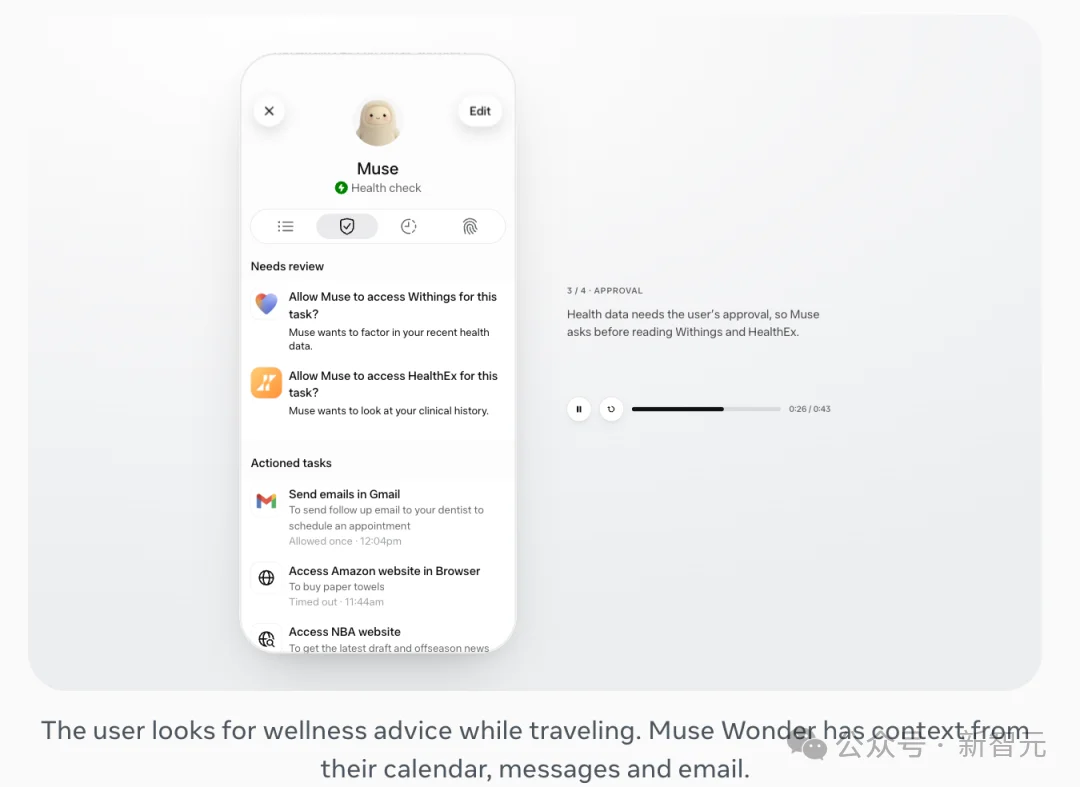
官方演示中,它甚至能直接在浏览器和多个App之间自己操作,结合用户的现实情况排出一份完美的周末跑步计划。
长周期代码之王:OpenAI的护城河干涸了
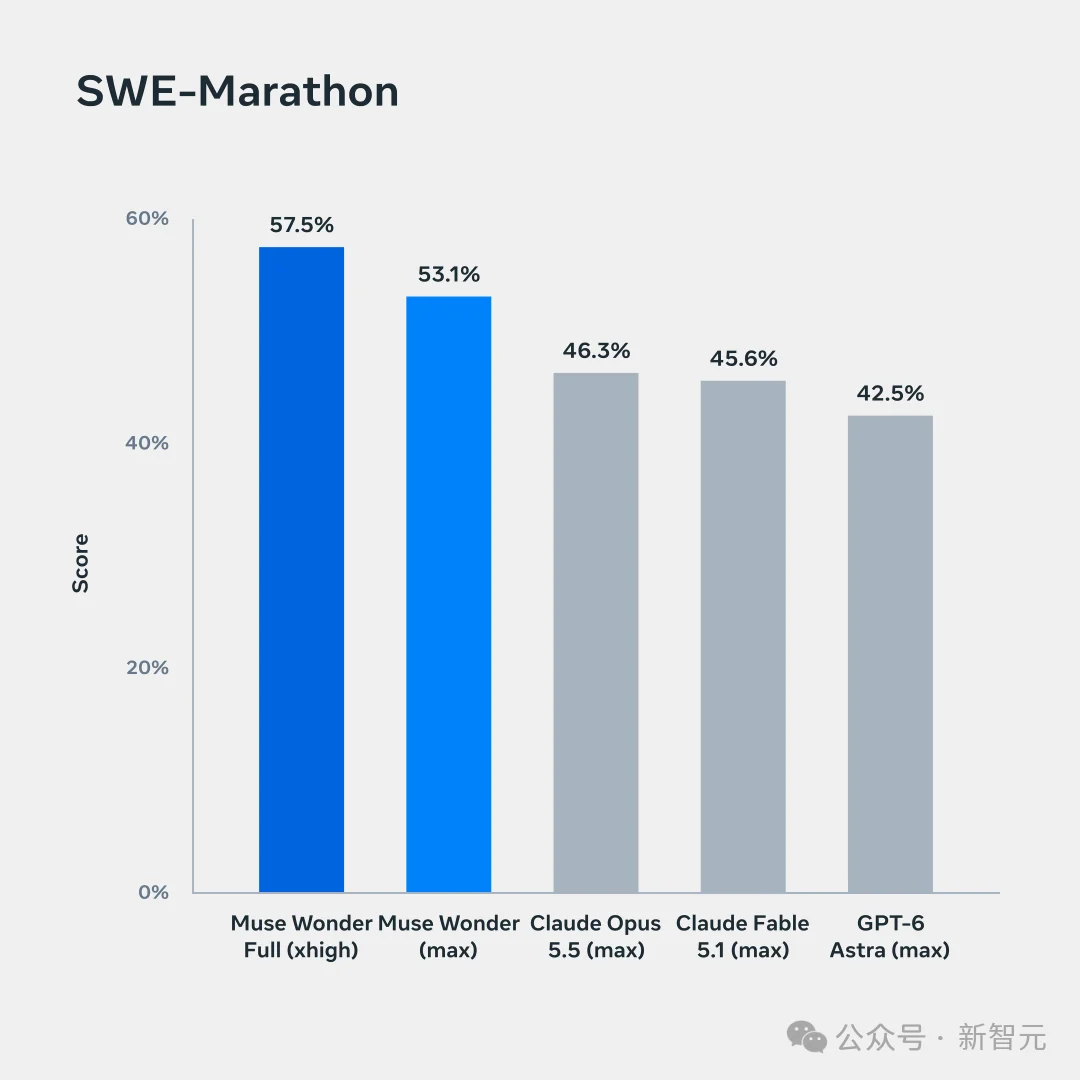
说到写代码,大家可能觉得GPT和Claude很强。但Meta指出,写几行脚本和「构建大型软件」是两码事。
在测试AI处理长时间、长周期软件项目的 SWE-Marathon 中,Muse Wonder Full 拿下了惊人的 57.5分,而它最强的对手(Opus/Astra)最高也才 46.3分!
在 DeepSWE 中,它同样以 79.0分 对 74.2分 领先。
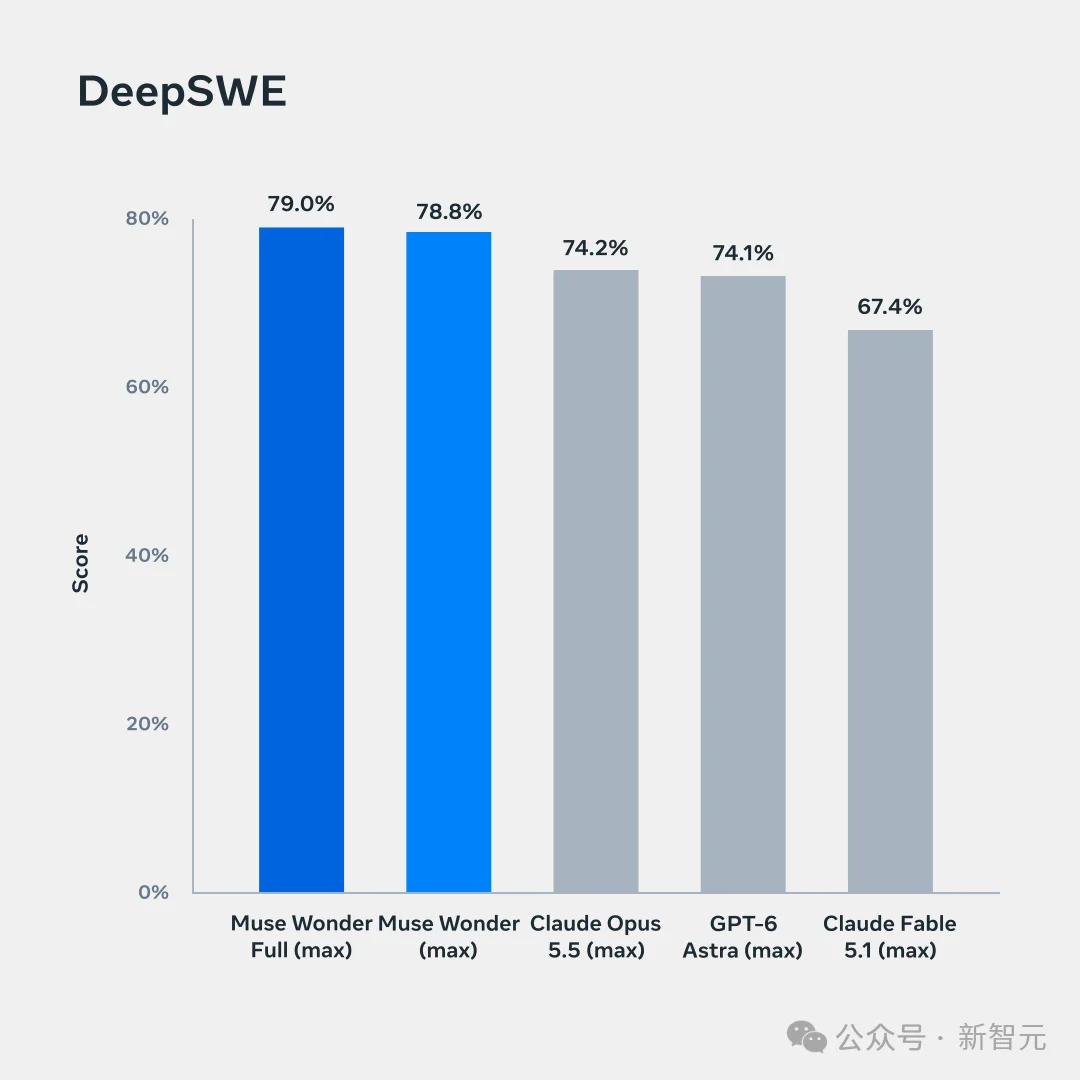
如果你要让AI花几天时间,去维护一个极其庞大、枯燥、复杂的企业级代码仓库,Muse Wonder是目前的无冕之王。
垂直领域的专家(如法律)
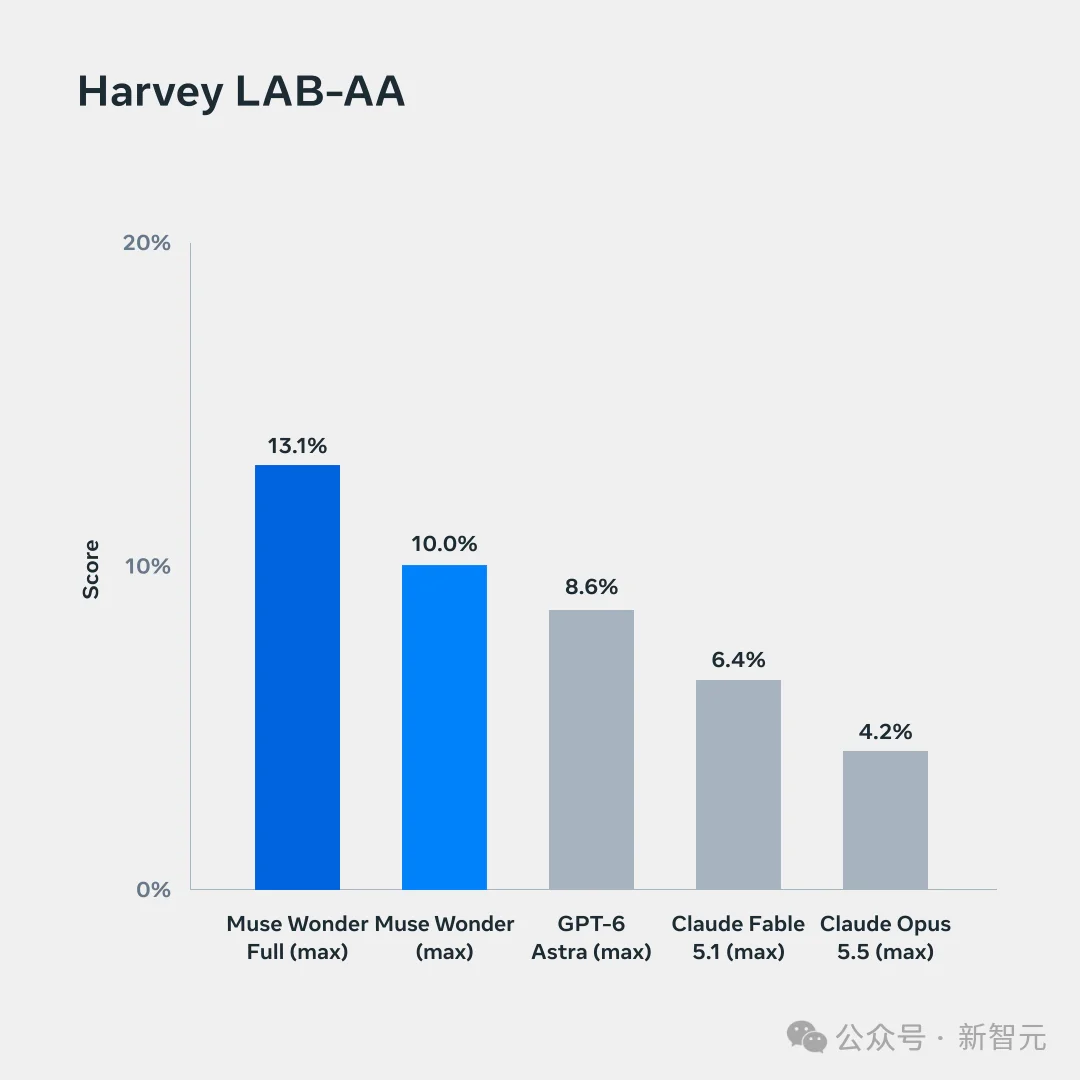
在极度苛刻、要求交付物每一项都达标的Harvey法律智能体测试(LAB)中,所有模型都叫苦连天,但Muse Wonder依然以 13.1分 大幅领先对手最高的 8.6分。
官方回应「刷榜」质疑:我们有「大模型味儿(Big Model Smell)」
针对网友吐槽的「Benchmaxxing(只针对跑分优化/刷榜)」,官方博客直接甩出了一张「测试时计算扩展(Test-time compute scaling)」图表。
数据证明,随着测试时计算量的增加,相比上一代Muse Spark,Muse Wonder在那些「没有专门针对性训练过的陌生任务(Out-of-distribution)」 上,表现出了惊人的向上跃升。
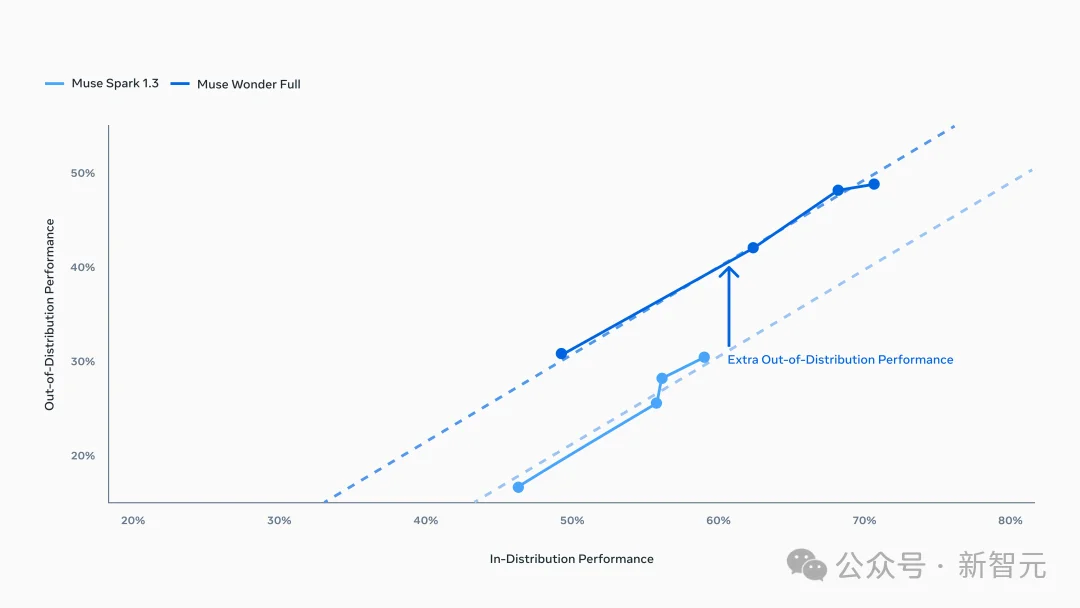
官方表示,这得益于其极其强大的基础模型底座(Base Model),赋予了它极强的泛化能力。它不是应试机器,它是真的变聪明了!
光鲜背后的阴影,它真的完美吗?
当然,尽管官方博客战绩辉煌,但Meta也很诚实地在对比表中放出了自己「输掉」的项目。仔细一看,Muse Wonder依然有一些难以掩饰的短板:
第一,在部分极客任务和知识储备上,依然被Claude和GPT压制。
在终端编程(Terminal-Bench)上,它以 57.1 输给了 Claude Opus 5.5 的 59.6;在从零写一个完整程序(ProgramBench)上,59.0 惨败给 Opus 的 70.5;操作电脑(OSWorld)78.4 对 81.8。在专业文档任务 GDP.pdf 上,也以 33.2 输给了 GPT-6 Astra 的 34.2。
这说明在综合知识和某些特定编码场景下,双王依然能打。
第二,最强版本「藏在付费墙后」,有「割韭菜」嫌疑。
注意,那个在官方博客里拳打Astra、脚踢Opus,各项指标吊炸天的,是完整版 Muse Wonder Full。但是!完整版目前只开放给Muse Code的付费订阅用户!
而开发者今天通过API能调用的,只是主打速度的基础版 Muse Wonder。
第三方机构Artificial Analysis评测显示,基础版综合评分仅52分,实际上还略低于GPT-6 Astra和Gemini 4 Argon。
第三,API贵得令人肉疼。
虽然它有着高达100万Token的上下文窗口,但基础版API定价高达每百万输入4美元、输出20美元!
第三方估算,它完成一项测试任务的成本高达4.52美元,比GPT-6 Astra(3.26美元)和Gemini都要贵得多。
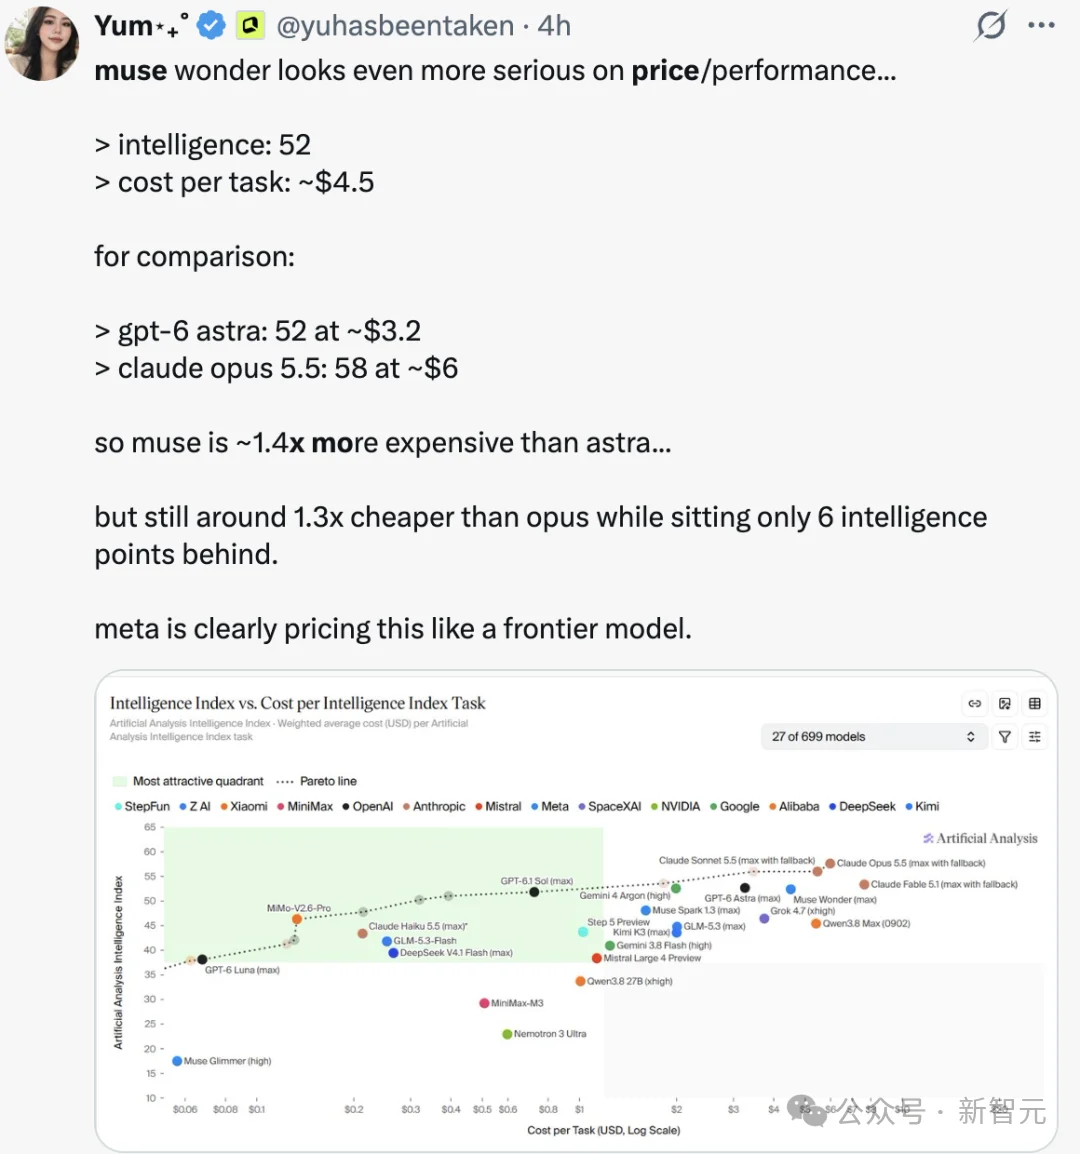
最让普通用户心梗的是:普通人还要等,而且不再开源!
普通用户用的AI助手Muse,还要等官方「逐步」接入。
曾经那个把Llama模型开源造福全人类的小扎,这次在模型卡里明确写着「采取安全计划保护模型权重」,对开源只字未提。
大V Andrew Curran说:现在节奏控制已经没戏了,所有大厂都在加速。而Meta拥有惊人的算力,从未停止过基础设施的建设。
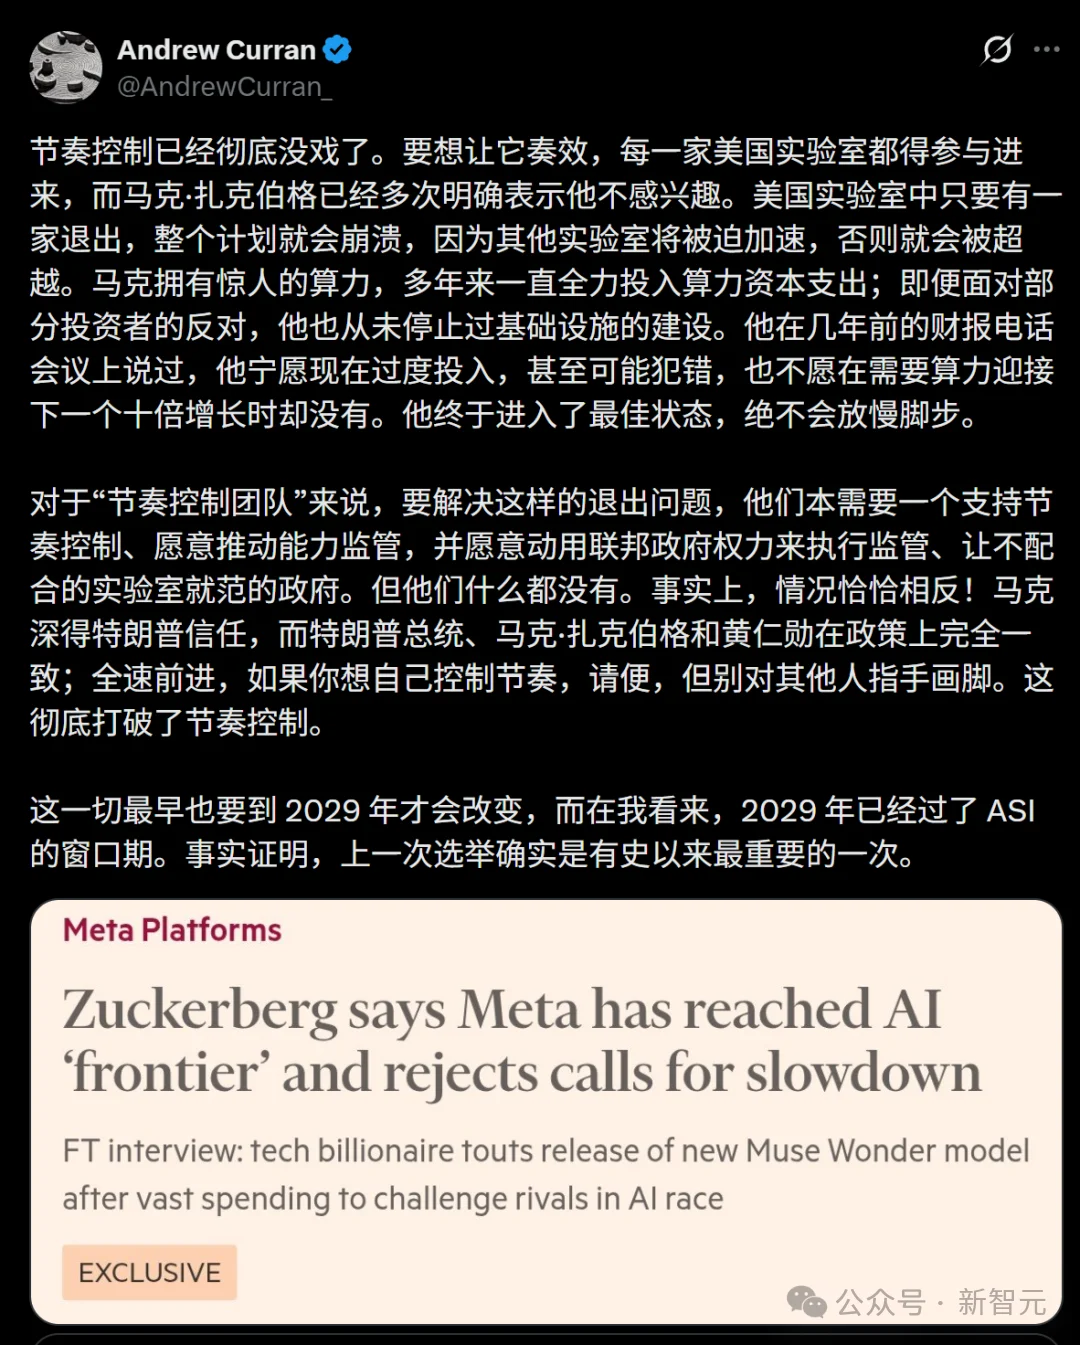
播客自爆千亿豪赌,小扎野心勃勃
显然,小扎对Muse Wonder寄予了多大的厚望。
在知名播客《Cheeky Pint》中,小扎和Alexandr Wang畅谈了Meta组建超级智能实验室一年多来的心血。
在这场对谈中,小扎输出了几个极具颠覆性的观点。
1.豪赌1000亿美金:不成功,便成仁
你以为做大模型是「精益创业」、小步快跑?错!
小扎直言,前沿AI模型完全是反直觉的。「你必须在知道模型到底能不能用之前,就砸下1000亿到2000亿美元!」
这种近乎疯狂的赌徒心理,造就了Muse Wonder背后吉瓦级的Prometheus数据中心。
2.交互界面的死亡:「模型即产品」
过去的软件靠华丽的UI吸引人。但王指出,未来的软件界面将无限变薄。真正区分产品的,是AI模型的行为、个性、可靠性、记忆力和使用工具的能力。模型本身,就是产品。
3.终极形态:AI代理的B2B时代
小扎描绘了一个可怕又迷人的场景:以后你买东西,不再是你去刷淘宝亚马逊。你的个人AI代理,会直接去和商家的AI代理谈判、下单。
小扎自己以前一年用两次买菜软件,现在一周用两次,因为AI代理让购买变得毫不费力。
这意味着,AI不仅在提高转化率,它甚至在凭空创造出新的电商需求!
带着这样宏大的「Agent」愿景,Muse Wonder诞生了。
跑分上超越Astra和Fable 5.1,听起来确实惊艳。
但接下来,我们还需等待更多用户的实测,才知道Muse Wonder究竟实力几何。
参考资料:
https://x.com/alexandr_wang/status/2109728684802523156
https://research.meta.ai/blog/muse-wonder
文章来自于"新智元",作者 "Aeneas 大卫"。


【开源免费】OWL是一个完全开源免费的通用智能体项目。它可以远程开Ubuntu容器、自动挂载数据、做规划、执行任务,堪称「云端超级打工人」而且做到了开源界GAIA性能天花板,达到了57.7%,超越Huggingface 提出的Open Deep Research 55.15%的表现。
项目地址:GitHub:https://github.com/camel-ai/owl
【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
