
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
随着一次次修补,Harness越来越复杂,Prompt越来越长,模块也越堆越多。但这些新增的功能,真的让Agent变强了吗?
来自加州大学圣塔芭芭拉分校(UCSB)、MIT-IBM Watson AI Lab和Adobe Research的研究者,提出了基于显著性的Harness剪枝方法SHARP(Saliency-based Harness Pruning)。
他们对四套知名Harness进行了系统测试,在统一使用Qwen3.5-122B-A10B模型的五个评测场景中,四套Harness都能通过剪枝,在保持相近任务表现的同时减少至少10%的Token开销。其中,OpenHands在GAIA基准上剪掉27个模块中的24个后,成功率反而从29.44%提升到35.00%,Token消耗还下降了27.4%。
但比这些数字更值得关注的是,SHARP到底怎么知道哪些模块该删,哪些必须留下?如果你自己维护着一个装有几十个Skills、Tools和复杂提示词的Agent,能不能用同样的方法找出那些白白消耗Token的模块?又怎么在不测试所有模块组合的情况下,找到更省钱、甚至表现更好的Harness? 到底哪些模块该留、哪些该删,现在可以通过实际测试来判断了。
在实际工程中,修改Harness(下文统称脚手架)远比重新训练模型方便。Agent搜索失败了,就加一条提示词;工具调用出错了,就补一套检查规则;任务完成得不好,就再接入一个Skill。新功能不断加入,旧模块却很少被删除,脚手架也就越堆越复杂。
问题是,这些新增的模块真的有用吗? 有些可能提高了任务成功率,有些只是增加了 Token消耗,甚至会干扰Agent原本正确的执行流程。
神经网络领域早已有成熟的剪枝方法(Neural Network Pruning):通过权重大小、梯度等指标判断哪些参数不重要,再将它们移除,以减少模型冗余。
但同样的方法放到Agent Harness上,会遇到两个麻烦。
例如,一个Agent原本有专门判断任务是否完成的工具,完成任务后就会停止运行。如果把这个工具删掉,Agent可能已经找到了正确答案,却仍然不断搜索、调用工具,白白浪费Token。
历史摘要模块也是如此。它虽然本身需要消耗Token,但能缩短后续对话的上下文。如果把它删掉,Agent每次调用模型都可能需要重新读取大量历史记录,最后反而花费更多Token。
因此,Harness剪枝不能只看删掉模块后成功率有没有下降,还必须看 Token 消耗有没有增加。
假设一个Harness有20个模块,每个模块都有保留和删除两种选择,那么总共就有超过100万种组合。
如果想找出最好的组合,最直接的办法就是把它们逐一测试。但每测试一种组合,都得让Agent真正执行一批任务,期间还会不断调用大模型、使用工具。即使每次只测试几十道任务,累计下来的Token消耗和等待时间也会非常惊人。
所以,Harness剪枝真正需要解决的就是两个问题:怎样判断一个模块值不值得保留?怎样用尽可能少的测试,找出值得删除的模块?
这正是SHARP要解决的问题。
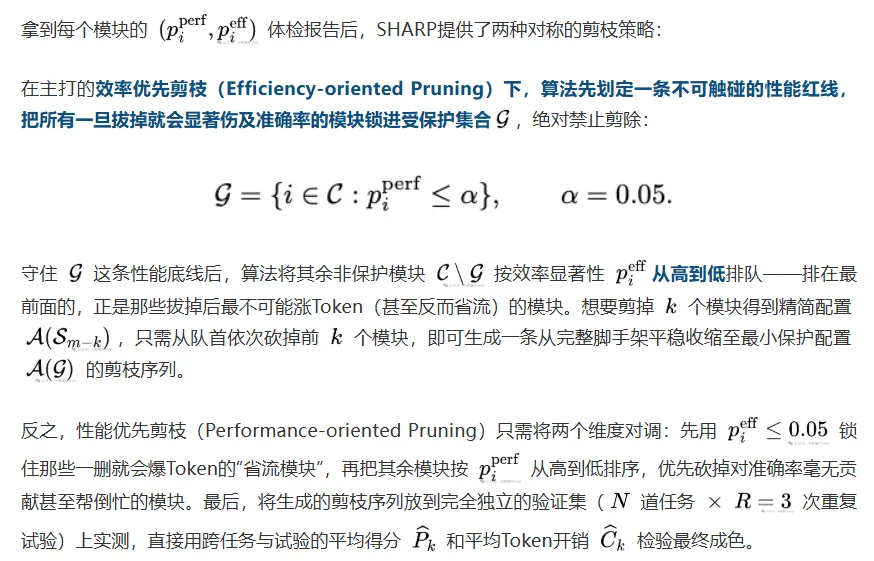
想给臃肿的脚手架做减法,最笨的办法是排列组合测试所有模块子集,但这样做算力上根本跑不通。SHARP的思路非常干脆:先在开发集上做一轮极低成本的“单模块消融(Single-module Ablation)”——每次只拔掉一个模块,测出它在任务性能和Token效率两个维度上的“不可替代性(显著性)”,再据此排出剪枝优先级,一步步把冗余模块砍掉。整个流程分为四步。
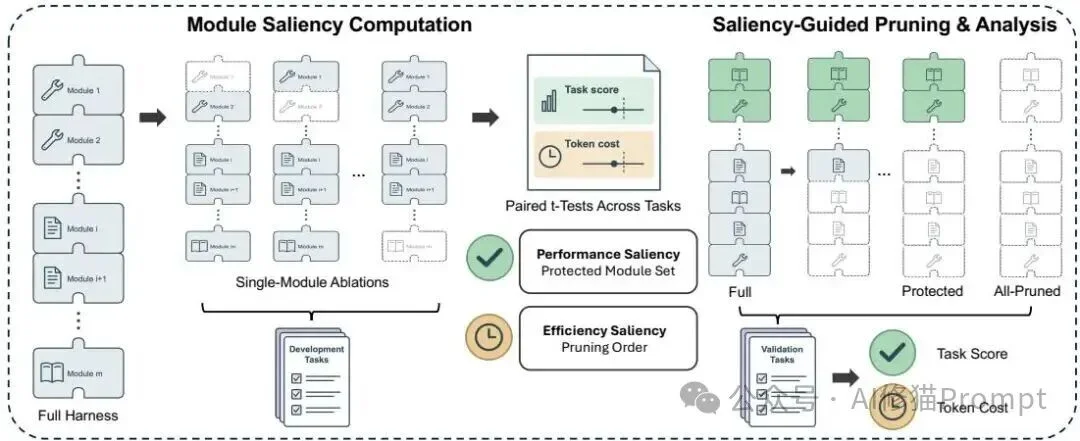
图:SHARP效率优先剪枝流程总览(对应原论文Figure 1):先在开发集上通过单模块消融与跨任务配对t检验估算各模块的性能显著性与效率显著性,据此划定受保护模块集合(绿色)并确定非保护模块的剪枝顺序,最后在验证集上评估各剪枝配置与全剪枝基线的任务得分和Token开销

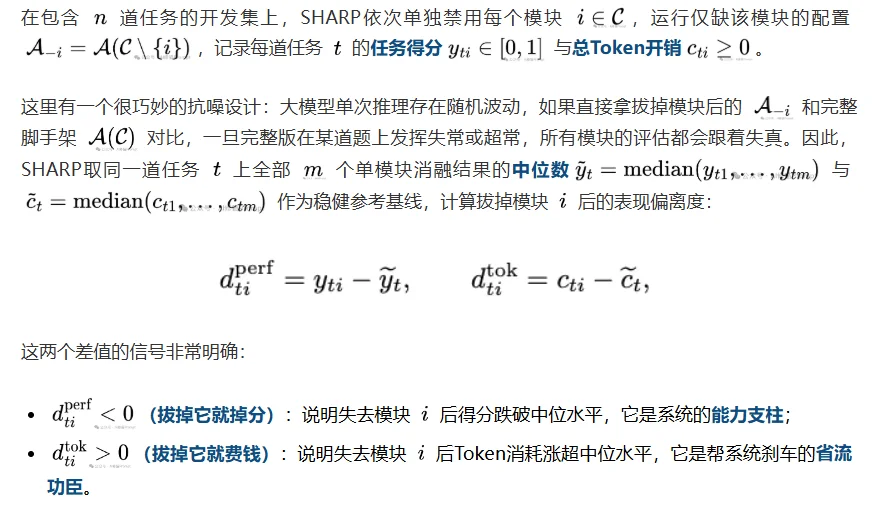
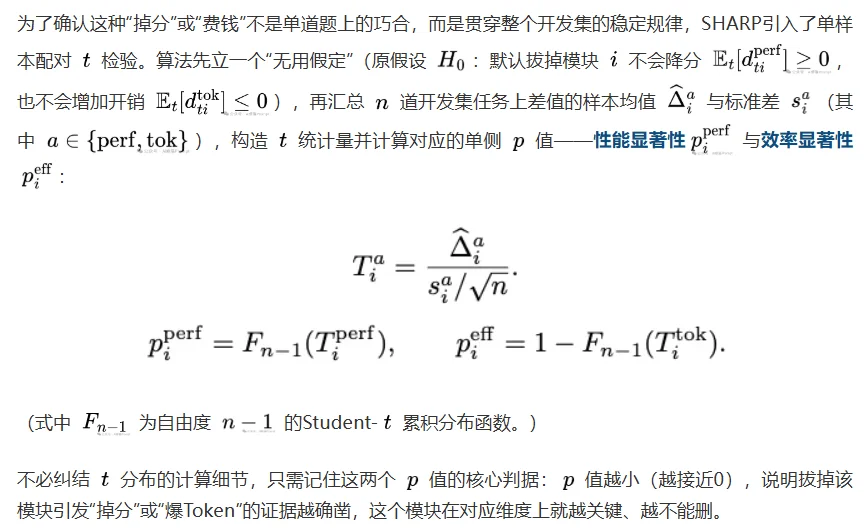
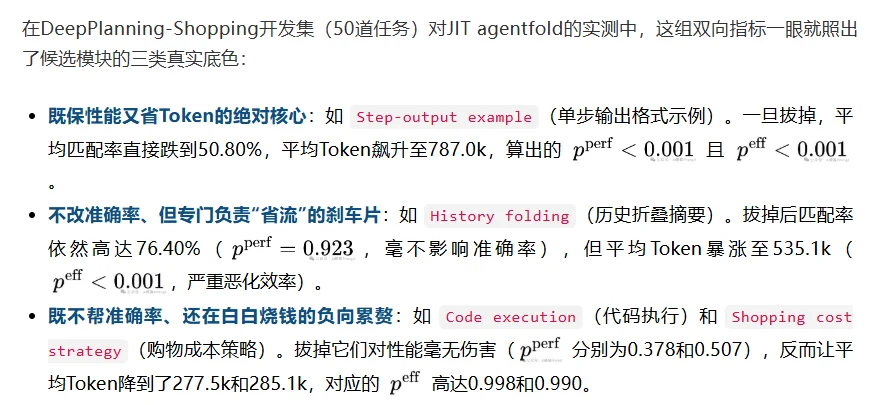
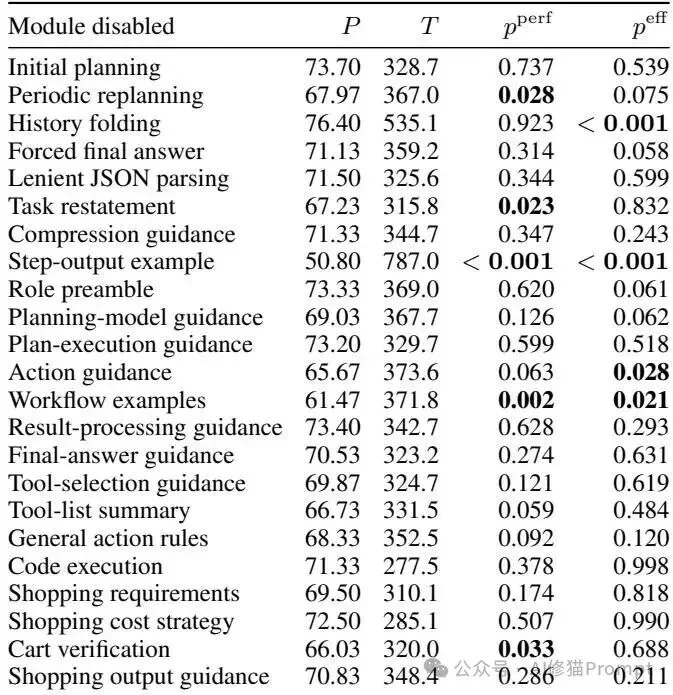
图:JIT agentfold在DeepPlanning-Shopping开发集(50道任务)上的单模块消融结果(对应原论文Table 10):列出逐一禁用23个候选模块后的平均匹配率P、平均Token开销T以及单侧配对t检验显著性p^perf与p^eff(加粗表示p小于等于0.05)
SHARP到底能删掉多少模块?删完之后,Agent真的会更快、更省Token,甚至表现更好吗?
研究者选择了四套开源Harness,分别测试通用任务、论文问答、客服和购物规划,共计五个场景。所有实验统一使用 Qwen3.5-122B-A10B 作为底层模型,并关闭思考模式,确保性能变化主要来自Harness本身。
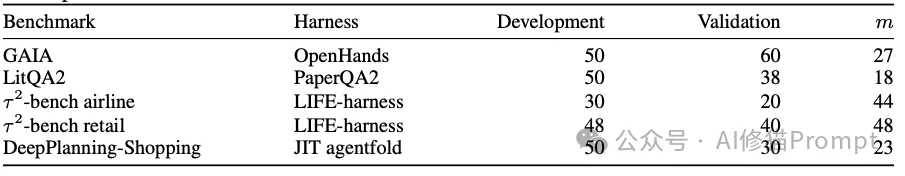
参与测试的分别是:拥有27个候选模块的OpenHands、23个模块的JIT agentfold、18个模块的PaperQA2,以及在航空和零售场景中分别拥有44、48个模块的LIFE-harness。
研究者先通过开发集确定剪枝顺序,再到独立验证集上测试。主实验采用效率优先策略,通常每剪掉3个模块测试一次,每道验证任务重复运行3次,观察成功率与Token开销如何变化。
结果相当出人意料。
OpenHands是一套通用Agent Harness,包含终端、浏览器、搜索、文件编辑、子Agent委派等工具,以及大量提示词和辅助机制。
在GAIA基准测试中,完整的OpenHands拥有27个候选模块,任务成功率只有29.44%,平均每道任务消耗约80万Token。
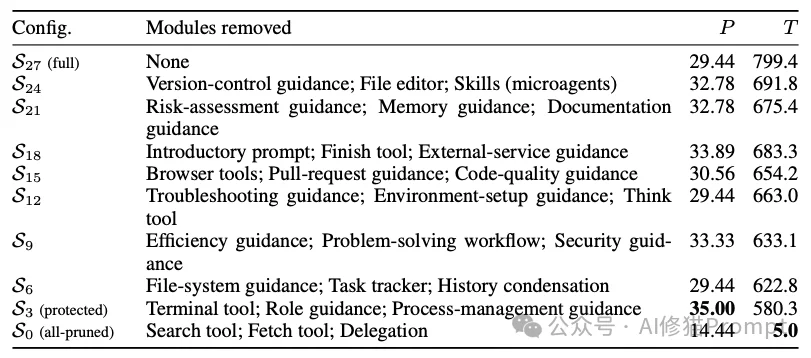
SHARP首先移除了Git版本控制指南、文件编辑器和微智能体技能库三个模块。
仅仅删掉这三个模块,成功率就从 29.44% 提升到32.78%,Token开销也降到了约69万。
研究者继续剪枝,陆续移除更多提示词、辅助工具和执行机制。直到27个模块只剩下最后3个时,出现了整个实验中最好的结果:
最后保留下来的三个模块分别是 Search tool(网页搜索)、Fetch tool(网页抓取)和 Delegation(子任务委派)。
这意味着,在GAIA这组任务上,OpenHands移除了绝大多数候选模块,反而取得了更高的成功率,同时花费更少的Token。
但这三个模块还能继续删吗?
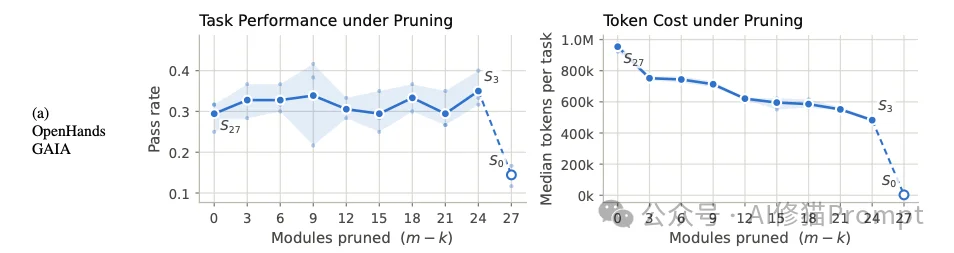
研究者专门测试了将它们全部移除的版本。结果成功率立刻从 35.00% 跌到14.44%。虽然Token消耗降到了每题约5000,但大量任务也无法正常完成。
这个结果说明,Harness确实可能存在大量冗余,但真正重要的模块不能随便删。 对这组GAIA任务而言,搜索、抓取和委派是OpenHands能够完成任务的重要能力,而其余许多辅助模块并没有带来相应的收益。
LIFE-harness的测试更大胆。研究者在航空和零售两个客服场景中,尝试移除全部候选模块,看看Agent最后还能剩下多少能力。
先看航空场景。
完整版Harness包含44个候选模块,任务成功率为 83.33%,平均消耗约13.87万Token。
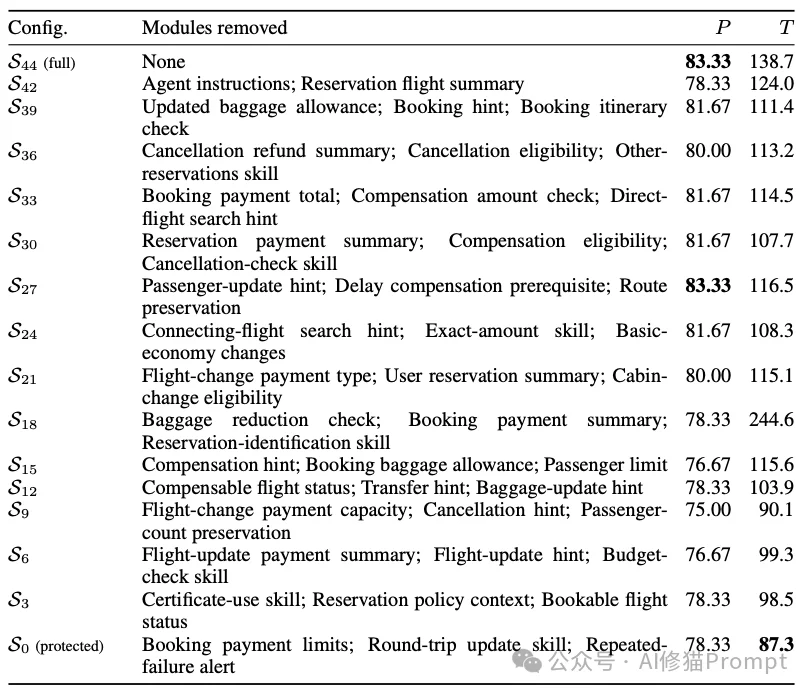
当SHARP剪掉其中17个模块后,成功率依然是 83.33%,但Token消耗已经减少了16%。
研究者继续往下删,直到44个候选模块全部移除,Agent仍然拿到了 78.33% 的成功率,而Token消耗下降了 37.1%。
为什么删光了还能正常执行?
因为这里删除的是Harness额外添加的检查规则、工具提示和Skills,原本用于办理航班业务的基础工具和业务规则仍然保留。所以全剪枝并不等于让Agent失去所有工具。
零售场景的结果更加有意思。
完整版有48个模块,成功率为 75.00%。研究者只删除了5个涉及订单地址、退货、库存和重复失败提醒的辅助模块,成功率就提高到了 82.50%,同时Token消耗也有所下降。
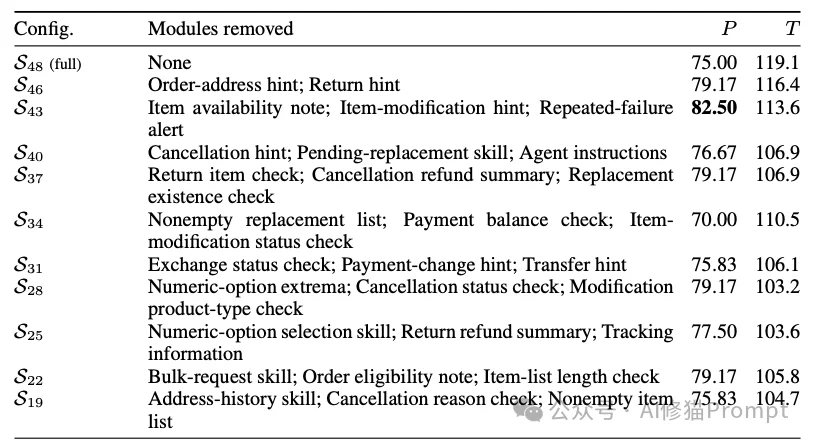
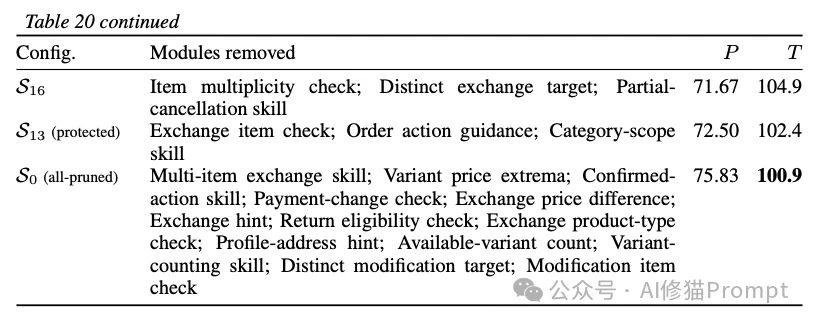
即使最后把48个候选模块全部移除,Agent仍然拿到了 75.83% 的成功率,甚至略高于完整版,而Token消耗减少了 15.3%。
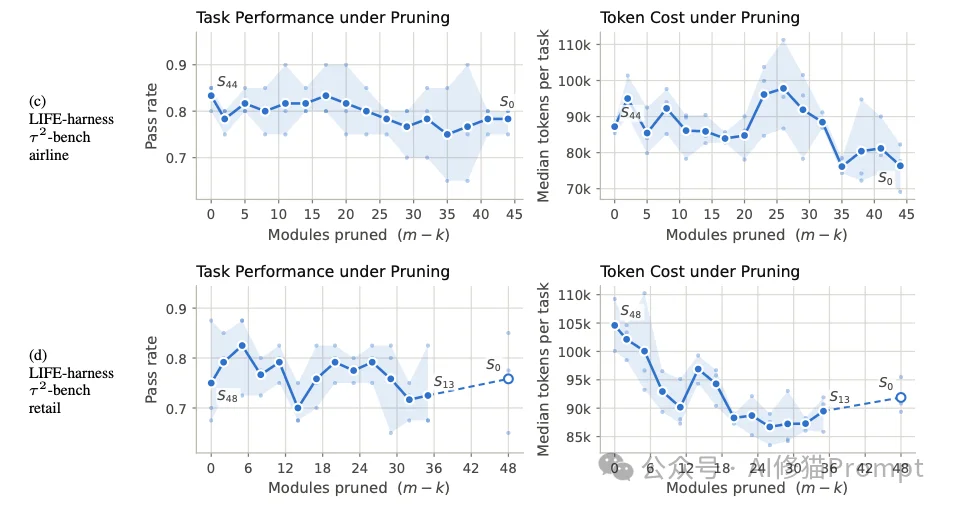
这两组实验说明:一个Harness里堆了多少提示词、检查规则和Skills,并不能直接代表它有多强。 有些功能虽然是后来为了防止出错才加入的,但在实际任务中可能没有带来多少帮助。
前面的实验主要采用效率优先剪枝,也就是尽量减少Token消耗,同时保护那些对任务成功率很重要的模块。
但SHARP还有另一种用法:性能优先剪枝。如果更在意Agent能否把任务做好,就可以换一套剪枝顺序,优先移除那些对任务表现帮助不大的模块。
研究者在JIT agentfold上比较了这两种策略。
JIT agentfold主要负责多步骤规划和工具执行。在DeepPlanning-Shopping测试中,Agent需要根据用户要求挑选商品、搭配优惠券并完成购物任务。评测使用匹配率(Match Rate),衡量最终购物结果与目标要求的匹配程度。
先看重复三次的效率优先主实验。
完整版拥有23个模块,平均匹配率为 76.10%,每道任务消耗约 32.9万Token。
SHARP剪掉购物需求指南、购物成本策略和代码执行三个模块后,Token开销就降到了约 20.4万,匹配率仍有 74.31%。
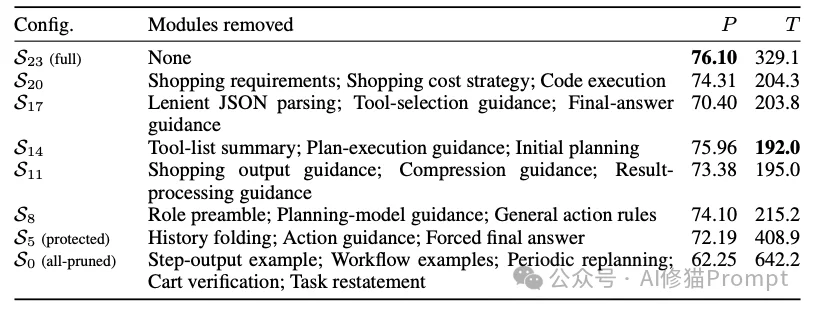
继续剪掉总共9个模块后,匹配率回到 75.96%,与完整版的76.10% 几乎相同,但Token开销只剩下约 19.2万。
相当于几乎没有损失任务表现,就节省了41.7% 的Token。
那么,如果把目标换成提高任务表现呢?
研究者又在同一个验证集上进行了两种剪枝策略的对照实验。这次每道任务只运行一次,因此下面的数字与前面的三次平均结果属于不同实验口径。
完整版的匹配率为 75.8%,平均消耗约32.4万Token。
性能优先策略删除的模块包括初始规划、计划执行指南、角色前言和结果处理指南。这些原本用于指导Agent完成任务的提示词,在这组测试中被移除后,Agent反而取得了更高的匹配率。
这也体现了SHARP两种策略的区别:同一个Agent,如果目标是省Token,就优先找能降低开销的配置;如果目标是提高成功率,就换一套剪枝顺序。
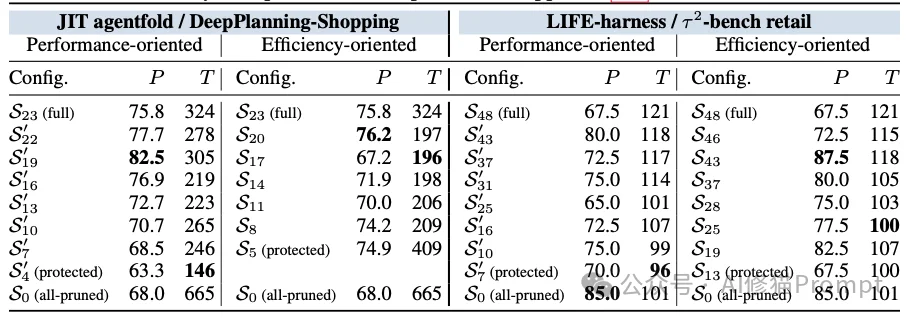
不过,性能优先不保证成功率一定更高,效率优先也不保证Token一定更少。实际结果还要看具体任务和模块之间的关系。
并非所有Harness都是模块越少越好。
在论文问答工具PaperQA2上,完整版保留18个候选模块,任务成功率为 61.40%,是所测试剪枝配置中表现最好的版本。
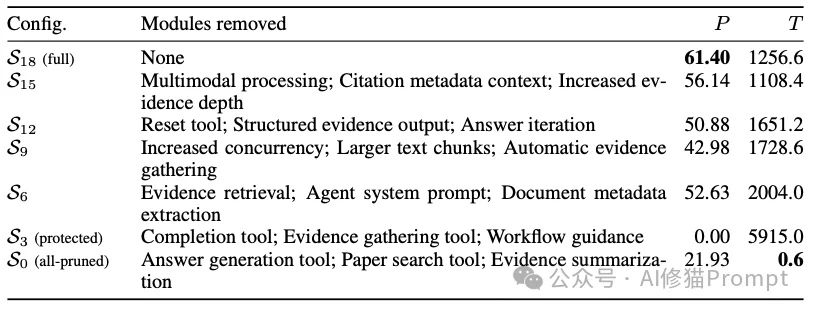
研究者先剪掉3个模块,Token消耗确实下降了,但成功率也随之降至 56.14%。
继续剪掉更多模块,情况反而变糟。尤其是当只剩下3个受保护模块时,成功率跌到了 0%,平均Token开销却涨到了约 592万,远高于完整版的约126万。
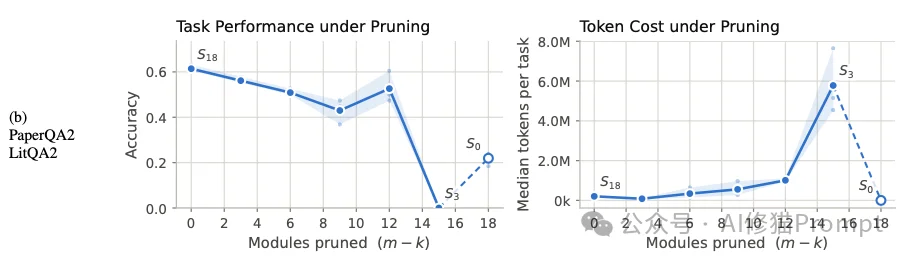
原因在于,PaperQA2的各个模块之间存在明显的依赖关系。例如,负责检索证据的机制被移除后,Agent可能需要处理更多无关论文内容;如果负责结束任务的工具无法正常发挥作用,Agent即使已经生成答案,也可能继续搜索和调用模型。
所以,删掉一个模块不一定能省Token,连续删掉多个模块还可能让整个工作流程出问题。
PaperQA2的结果也提醒我们:SHARP找到的是不同模块组合下的性能与成本变化,并不能保证每一种Harness都能通过大规模剪枝获得更好的结果。
研究者将五个场景中的剪枝配置放在一起,比较任务性能和Token开销,并绘制了帕累托前沿(Pareto Frontier)。
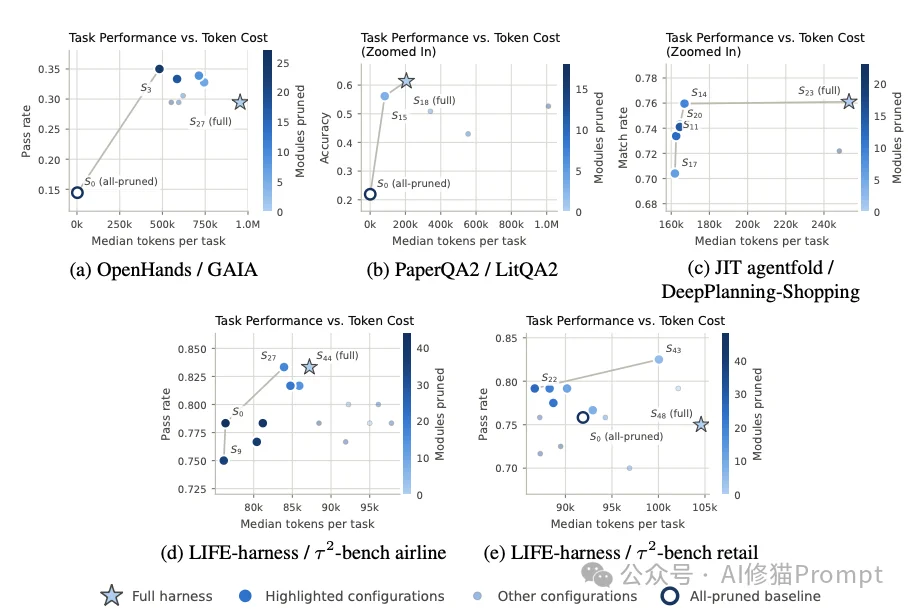
这个概念并不难理解:如果一个配置的成功率更高,同时消耗的Token更少,那么它就比另一个配置更划算。
在OpenHands和LIFE-harness的零售场景中,研究者确实找到了这样的精简版本:它们不仅比完整版更省Token,任务成功率也更高。
但在PaperQA2中,降低Token开销往往需要牺牲一定的任务成功率;有些模块组合甚至会让两项指标同时恶化。
因此,这篇论文真正有价值的发现,是证明了现有Harness中确实可能存在大量可以删除的冗余模块,而且模块数量与Agent的实际能力并不存在简单的正比关系。
至于到底应该删哪些、删多少,SHARP给出了一套可以通过实际测试回答的方法。
为什么有些模块删掉后,Agent不仅表现更好,还能省下大量Token?而另一些模块一旦删除,Token消耗反而会暴涨?
研究者回看了Agent完成任务时的每一步操作,发现主要有四种情况。
在DeepPlanning-Shopping的一道购物任务中,用户要求JIT agentfold挑选5件符合条件的服装和鞋靴,并尽量找到最低价格。
完整版Harness中有一条 Shopping cost strategy(购物成本策略)提示词,要求Agent不断寻找更便宜的商品。
问题就出在这里:Agent其实早就选对了全部5件商品,却还在按照提示词继续找更低的价格。
它又进行了 26次商品搜索和26次商品详情查询,直到用完执行步数,购物车里的商品也没有发生任何变化。整道任务一共调用了43次大模型。
研究者尝试删掉这条购物策略提示词。结果Agent选出了完全相同的商品,核对完优惠券就直接提交答案。
两次运行的任务匹配率都是 100%,但模型调用次数从 43次减少到14次,Token消耗直接下降 74%。
原本是为了让Agent找到更便宜的商品而添加的提示词,最后反而让它在已经完成任务后继续重复搜索,白白浪费Token。
还有一些模块,即使Agent从头到尾都没有使用,也可能一直在消耗Token。
例如,OpenHands在GAIA的一道任务中,需要读取图书馆的馆藏PDF,统计某位作者有多少本书不在书架上。
研究者分别测试了完整版和剪枝版,发现两者的执行过程完全一样:都是调用2次终端命令提取PDF文本,再经过3次模型调用返回正确答案。
既然执行步骤完全相同,为什么剪枝版消耗的Token更少?
因为完整版OpenHands的上下文中还放着 64个Skills的说明,以及文件编辑器和Git版本控制等额外信息。
这些内容虽然在任务中没有派上用场,但模型每次调用时仍然需要处理相关上下文。
删除这些模块后,第一次模型调用的输入量就从 19,706 Token降到12,953 Token,后续调用也有类似的减少。最终整道任务的Token消耗下降了 32%。
也就是说,有些模块不需要真正运行,光是把说明放在上下文里,就已经开始花钱了。
但并不是所有模块都能随便删。PaperQA2的实验就出现了相反的结果。
在LitQA2论文问答测试中,完整版PaperQA2有18个候选模块,任务成功率为 61.40%,平均每道题消耗约 126万Token。
随着模块不断被删除,Token开销反而越来越高。当只剩下3个候选模块时,成功率直接降到了 0%,平均Token消耗却涨到了约 592万,接近完整版的 4.7倍。
为什么模块少了,反而花这么多Token?
研究者发现,其中一个问题出在 Completion tool(完成工具)上。
这个工具负责让Agent提交最终答案并结束任务。如果把它删掉,Agent即使已经生成了正确答案,也可能无法正常结束执行。
在研究者检查的一次运行中,Agent已经生成了答案,却还在继续搜索论文、处理文本、重新生成答案,直到把 500秒的执行时间用完。
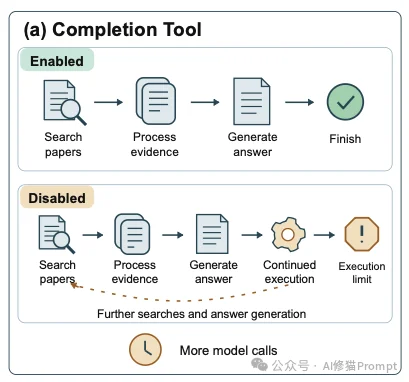
类似的问题也出现在工作流指南和证据收集工具上:删掉工作流指南,Agent可能不知道什么时候该停;删掉证据收集工具,Agent可能反复搜索论文,却始终没有整理出可以用于回答问题的证据。
这些模块看起来没有直接参与生成最终答案,但它们能保证Agent按照正确的流程完成任务,并在该结束的时候及时停止。
PaperQA2还有另一个很典型的问题:删掉一个负责筛选信息的模块,反而让模型需要处理更多内容。
正常情况下,PaperQA2会先搜索论文,再由 Evidence retrieval(证据检索模块)从收集到的文本中挑出最相关的段落,交给大模型总结。
如果把这个模块删掉,原本只需要处理少量相关段落的任务,就可能变成把收集到的所有论文段落都交给模型处理,其中还包括大量用不上的内容。
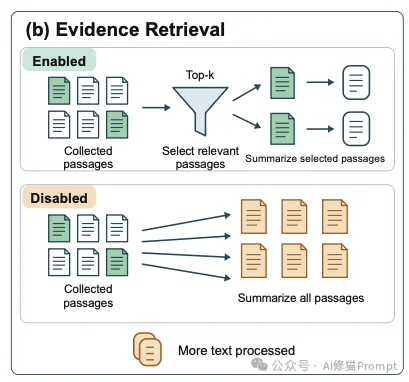
模型要读的文字更多,Token消耗自然也跟着上涨。
类似的现象还出现在JIT agentfold中。完整版平均每道题消耗约32.9万Token,但删除全部候选模块后,平均开销反而涨到了 64.2万,几乎翻倍。这里同时删除了历史折叠等多个模块,说明过度剪枝可能让原本负责控制上下文和执行流程的机制一起失效。
这几组执行轨迹说明了一个很关键的问题:
Harness中有些模块是在帮Agent完成任务,有些是在帮它减少不必要的操作,还有些只是不断增加上下文和重复工作。
因此,剪枝不能简单地按照模块大小、提示词长度或调用频率决定删除顺序。真正需要判断的是:删掉这个模块以后,Agent的任务完成得怎么样,又会多花或少花多少Token?
这也是SHARP同时评估任务性能与Token开销的原因。
对于使用OpenClaw、DSH或自研Harness的朋友,你同样可以借鉴这套方法优化你已有的Agent。
按照SHARP的思路,你可以先找出业务里几十个真实的Bug修复任务,然后每次只禁用一个模块,让Agent重新完成同一批任务,记录测试通过率和Token消耗。
如果关掉任务规划后,Bug依然能修好,Token还明显减少了,那这个模块就值得考虑删除。反过来,如果关掉历史摘要后,修复成功率没什么变化,Token消耗却大幅增加,那它显然还有保留价值。
SHARP的官方代码已经开源:
https://github.com/UCSB-NLP-Chang/SHarP [1]
你可以把自己的消融实验结果导入项目,直接计算模块的性能与效率显著性,并生成剪枝顺序。不过,它目前还不能一键接管你的Agent,你仍然需要自己准备测试任务、实现模块开关,并验证多个模块同时删除后的效果。
这篇论文给我们提供了一种重新审视Agent的方法:以后每增加一个Skill、Prompt或Tool,都可以通过实际测试看看它究竟带来了多少收益,又多花了多少Token。
毕竟,Agent的能力最终要看它能完成多少任务、完成得有多好、需要花多少钱,而不是看它装了多少模块。
文章来自于"AI修猫Prompt",作者 "AI修猫Prompt"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
