
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
谷歌今年的一篇论文,愣是把存储芯片巨头的股价都给整出动静了。
论文里提到,KV Cache至少能压缩6倍。
要知道,大模型推理越来越吃内存,KV Cache又是其中一笔不小的开销。
现在谷歌突然把它压下去这么多,美光等存储芯片巨头的股价随之下跌。
结果才过去几个月,又有人对KV Cache下了更狠的一刀。
这次连压缩都不满足了。
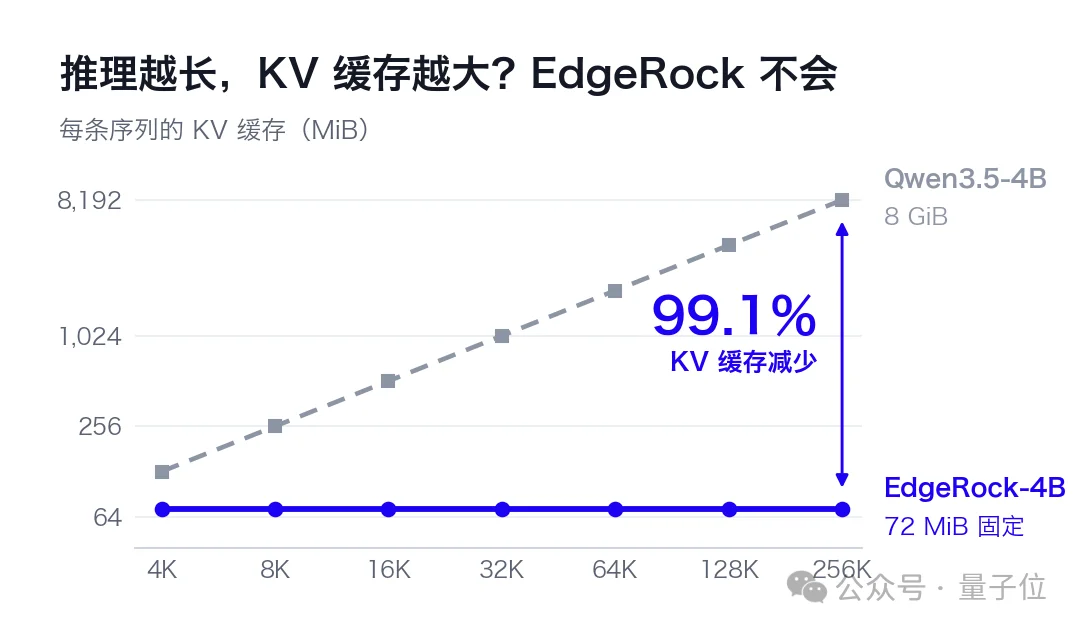
上下文从4K一路涨到256K,KV Cache占用愣是没变。
在256K上下文下,始终固定在72MiB。相比源模型,KV Cache直接减少99.1%。
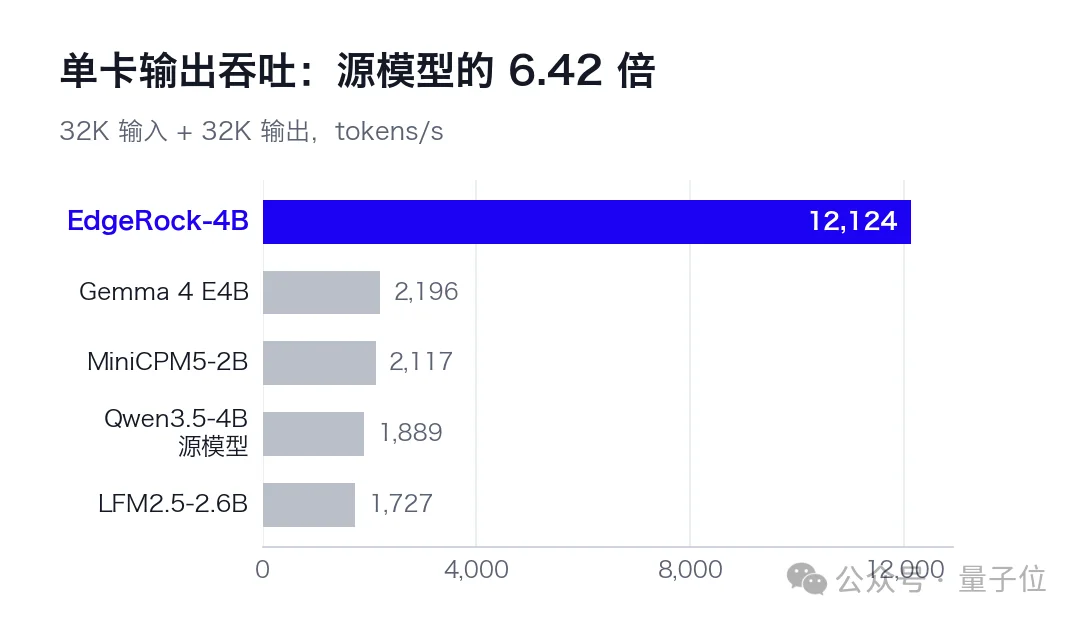
更夸张的是,一张80GB显卡同时跑512路长推理,输出吞吐达到12124 tokens/s,是源模型的6.42倍。
而且推理能力也基本保住了,AIME 2024—2026平均一次通过率达到82.9%,而参评的有界状态模型即便做到14B,最好也只有18.8%。
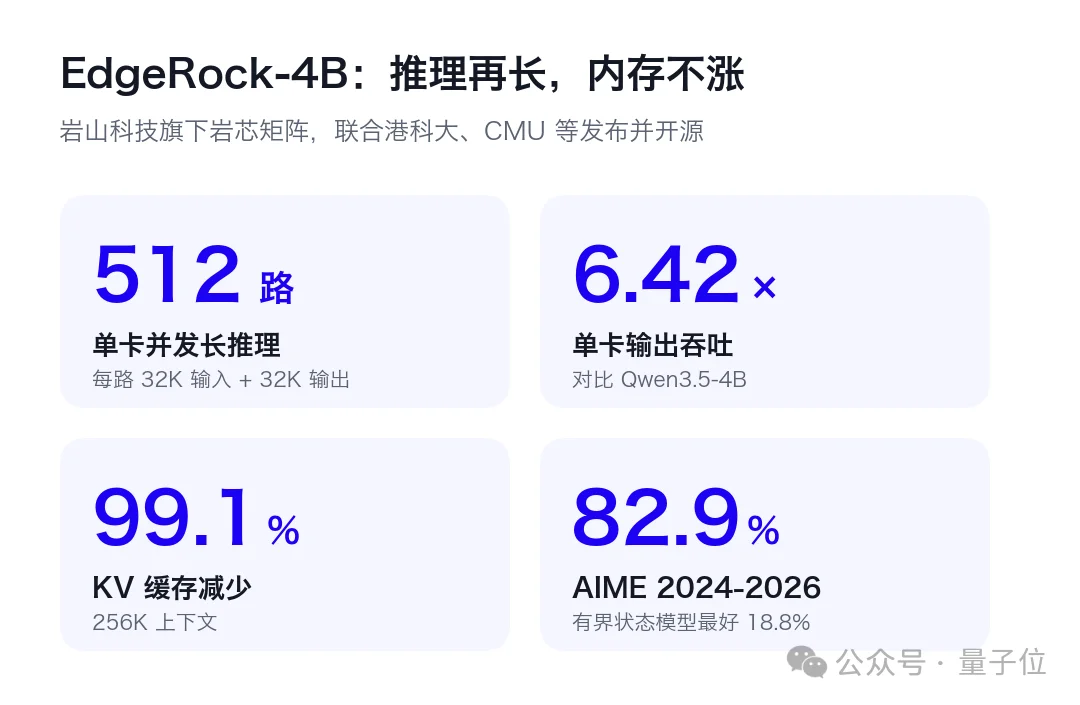
这就是岩山科技旗下岩芯矩阵联合港科大、CMU等高校刚刚发布并开源的EdgeRock-4B。
它给长推理带来的一个变化是:
推理再长,内存不涨。
模型权重和推理代码目前均已开源,还支持文本和图像推理。
现在的模型,动不动就要思考几万token;Agent更是能连续工作几十轮,搜索结果、代码、工具调用记录不断往上下文里塞。
模型越干越起劲,显存却先扛不住了。
问题就出在KV Cache上。
如今大多数模型,都把推理历史存在KV Cache里,每生成一个token,就多存一些。
以Qwen3.5-4B为例,每个token要新增32 KiB的KV Cache。推理到64K,一条序列就是2 GiB;推理到256K,就是8 GiB。
这在推理模型时代尤其要命。
模型越来越爱“深度思考”,动辄输出几万token;Agent一跑就是几十轮工具调用,上下文越滚越长。
推理越长,占的显存越多,一张卡能同时服务的请求就越少。
到了端侧,KV Cache还得跟感知、控制模块争抢本就有限的内存。
业界的办法大致有两类。
一类是给每个token“瘦身”:
多头潜在注意力(MLA)压缩KV,KIVI这类量化方法降低精度,谷歌的TurboQuant也属于这一路。
但它们只降低了单个token的成本,缓存照样随推理增长。
另一类是有界状态模型:
循环模型、状态空间模型、滑动窗口模型,内存天生固定。
问题是,它们往往留不住后续推理要用的远处细节,推理能力随之大打折扣。
所以真正的难题就变成了:
能不能在固定内存里,留住推理要用的关键细节?
EdgeRock给出的答案是:能。
先看最直观的吞吐。
测试设定是32K输入、32K输出,所有模型都在单张Hopper 80GB GPU上跑,各自取实测最快的批大小。
结果,EdgeRock-4B一口气开到512路并发,输出吞吐12124 tokens/s。
源模型Qwen3.5-4B最快的配置是批大小64,只有1889 tokens/s;Gemma 4 E4B、MiniCPM5-2B、LFM2.5-2.6B也都在1700到2200 tokens/s之间。
差距为什么这么大?账其实很好算。
32K输入加32K输出跑完,Qwen3.5-4B每条序列的KV Cache是2 GiB。
单张80GB显卡并发几十条就会被占满,更多请求只能排队。
而EdgeRock-4B批量运行时,每条序列需要保存的全部历史状态固定为97.76 MiB,不随长度变化。
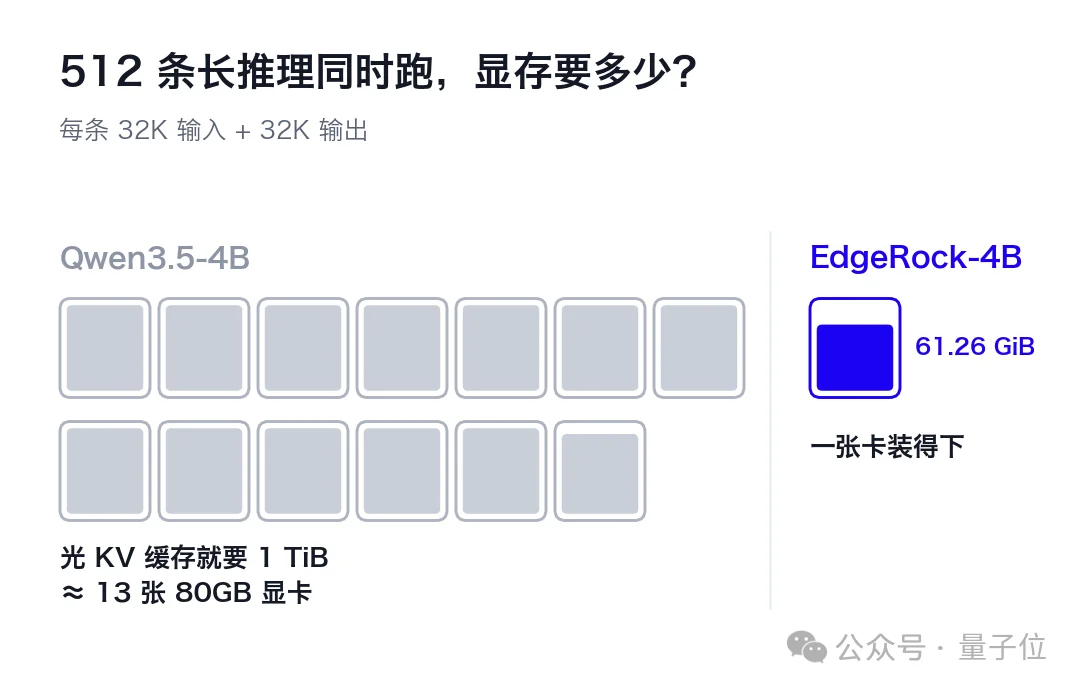
打个比方:如果让Qwen3.5-4B也同时跑完这512条序列,光是生成结束时的KV Cache就要1 TiB,约等于13张80GB显卡的显存。
EdgeRock一张卡就装下了,峰值61.26 GiB,还含着模型权重。
再看扩展性。
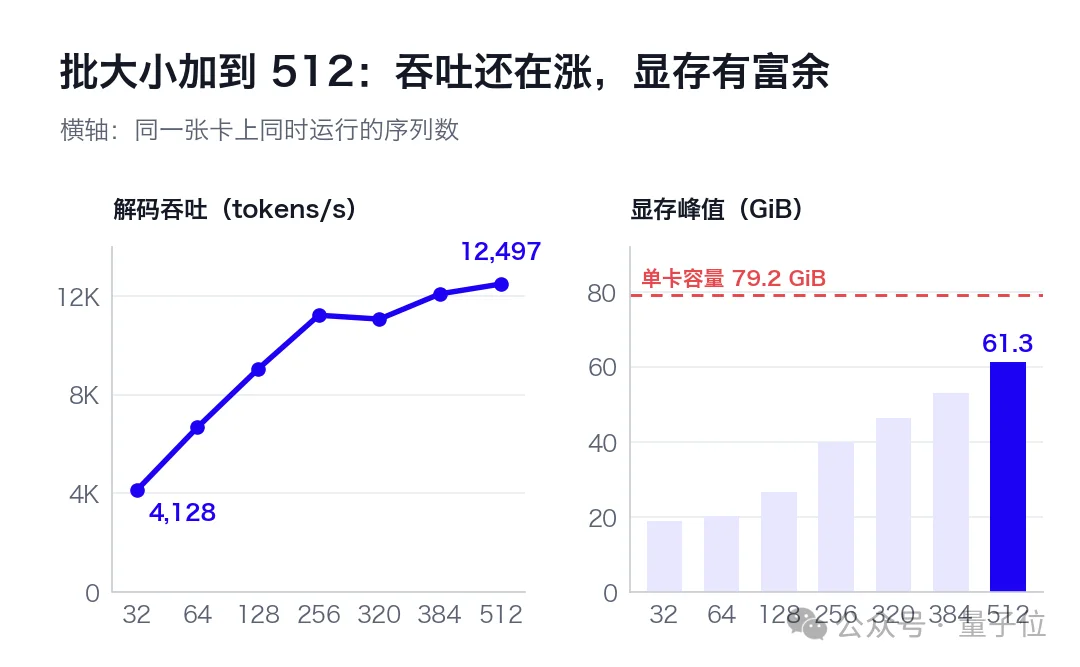
在4K到32K输入、输出两两组合的16种负载上,批大小从32一路加到512,加权解码吞吐从4128涨到12497 tokens/s,显存峰值始终没碰到单卡上限。
单条请求也不慢。
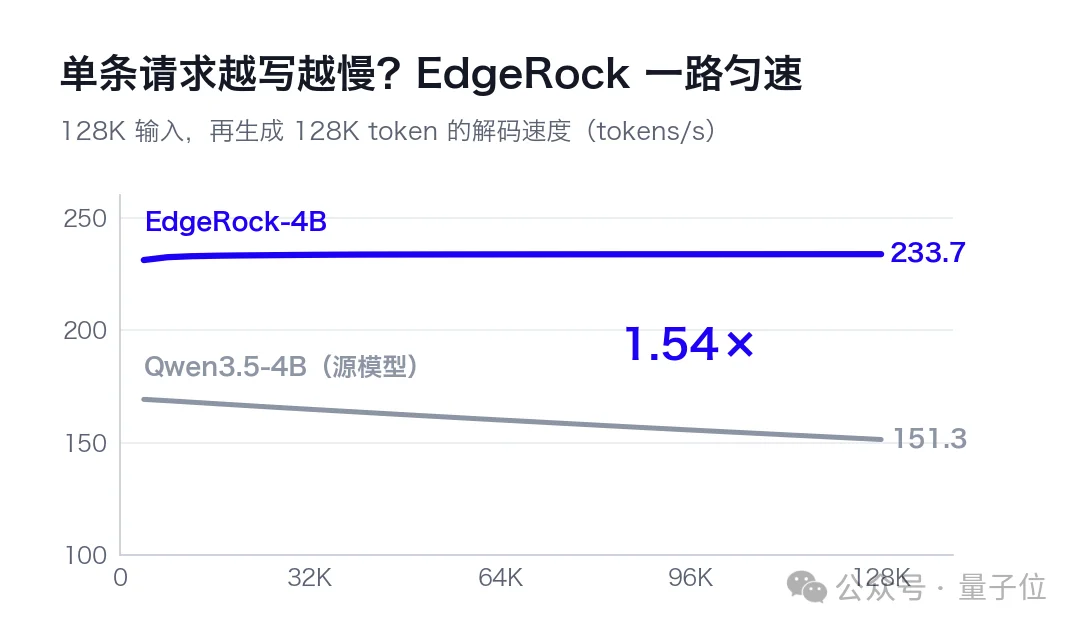
KV Cache随推理增长的模型有个通病:越写越慢。
因为每生成一个新token,都要回头看一遍越积越多的KV Cache。
EdgeRock每个token的计算量不随上下文增长。
128K输入后再生成128K token,它的速度从头到尾稳在233.7 tokens/s;
Qwen3.5-4B则从169左右一路降到151.3。
吞吐翻几倍,换个角度看,就是成本降几倍。
同一张卡、同样的负载,生成同样多的token:
按GPU时长计费的话,每个token的算力成本也按这个比例下降。
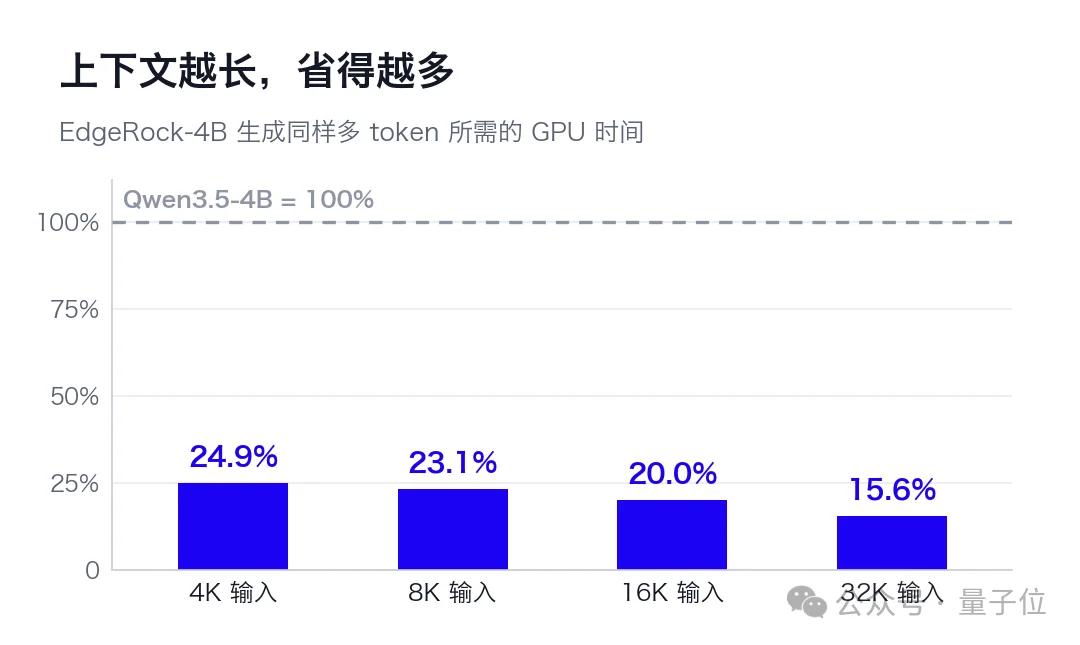
四种输入长度平均下来,EdgeRock的吞吐是Qwen3.5-4B的4.94倍,是LFM2.5-2.6B的7.18倍。
更关键的是趋势:上下文越长,差距越大。
Qwen3.5-4B的KV Cache随长度越涨越多,EdgeRock的不涨。
除了“省”,固定内存还带来一个容易被忽视的好处:确定。
每条请求要多少内存,推理开始前就能算清楚。
在内存越来越金贵的当下,这笔账只会越算越值。
看到这儿,懂行的朋友可能要问了:恒定内存,RNN、Mamba早就做到了,有什么稀奇?
稀奇就稀奇在,省了内存,推理能力还在。
团队拿EdgeRock-4B和16个有界状态模型做了对比,涵盖GDN、RWKV、Mamba等路线,其中三个是14B级别。
AIME 2024–2026上,EdgeRock-4B平均一次通过率82.9%;对照组里最强的RWKV-7 G1j 13.3B只有18.8%,AHN-GDN Qwen2.5 14B是11.4%。
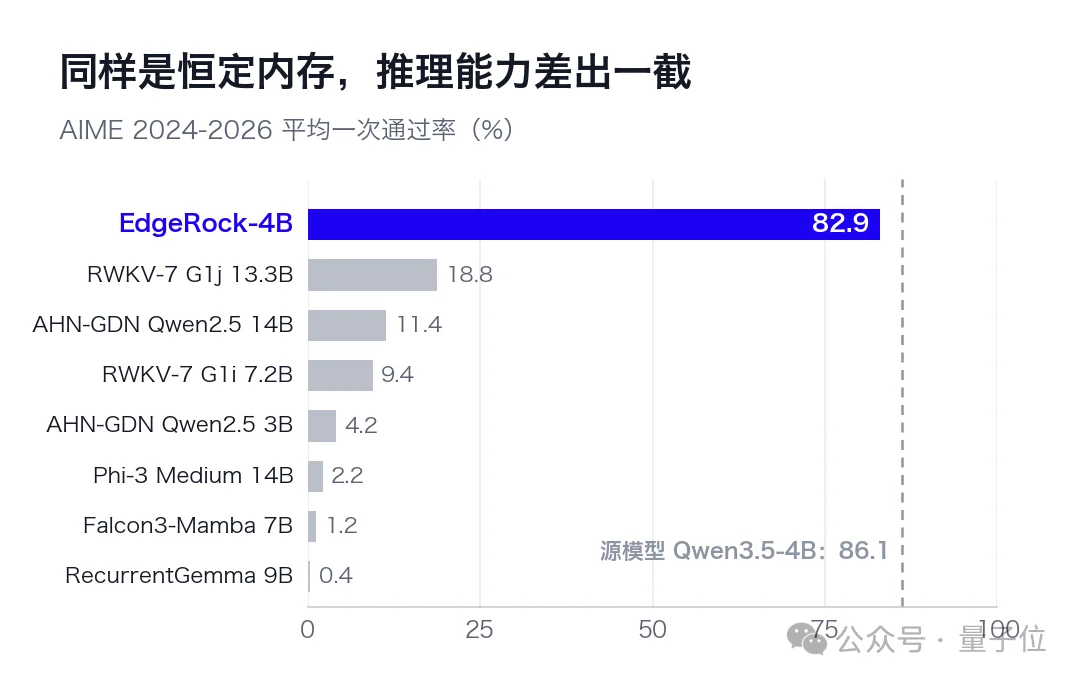
在29项文本基准中,EdgeRock-4B在其中24项排名有界状态模型第一;29项等权均值比该指标上最强的基线AHN-GDN Qwen2.5 14B高出23.8个百分点。
和源模型比,能力也基本保住了:
这一成绩,已经和内存随推理增长的领先小尺寸模型处于同一水平。
那么,EdgeRock是怎么做到的?
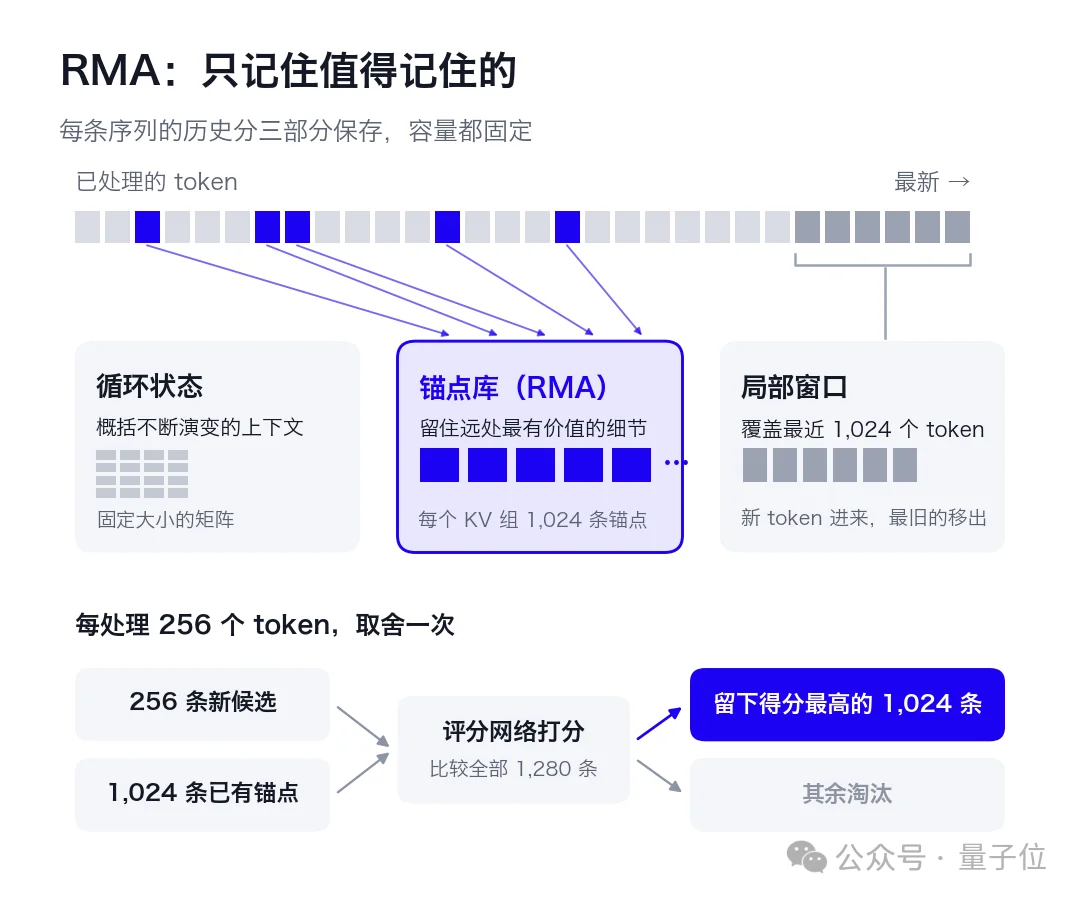
核心是一种新的记忆机制,记忆岩锚(Rock Memory Anchors,RMA)。
它的设计取意于岩锚:将推理所需的关键信息固定下来。
就像攀岩者把岩锚钉进岩壁,后面的每一步都有可靠的支点,RMA把推理途中真正重要的细节“钉”在一个固定容量的锚点库里,需要时直接读取。
具体来说,EdgeRock把每条序列的历史分成三部分保存,三部分各司其职:
锚点的取舍过程是这样的:
写入器为每个token生成一条候选记录,评分网络给它打分;
每累积256条候选,就和锚点库里已有的记录放在一起比较,只留下得分最高的1024条,其余淘汰。
四个KV组各自独立进行。
留下的锚点彼此独立、内容不变。所以哪怕它的来源早已滑出局部窗口,后面的推理仍然可以直接读到。
说白了,模型学会的不是“记住一切”,而是“只记值得记住的”。
局部窗口加锚点库,把每条序列的注意力KV固定在72 MiB。这就是内存不涨的来源。
架构上,EdgeRock-4B基于Qwen3.5-4B改造:保留24个Gated DeltaNet层,把8个全注意力层换成1024窗口的滑动窗口注意力,外加独立的RMA模块。
整个模型由Qwen3.5-4B分阶段转换而来,无需从头预训练。
那锚点到底有没有起作用?
团队做了个实验:推理时把8个RMA模块全部关掉,循环层和局部注意力照常工作。
在256段16K至130K token的长上下文上,每段问4个问题,涵盖检索、状态更新、跨文档信息组合和变量绑定:
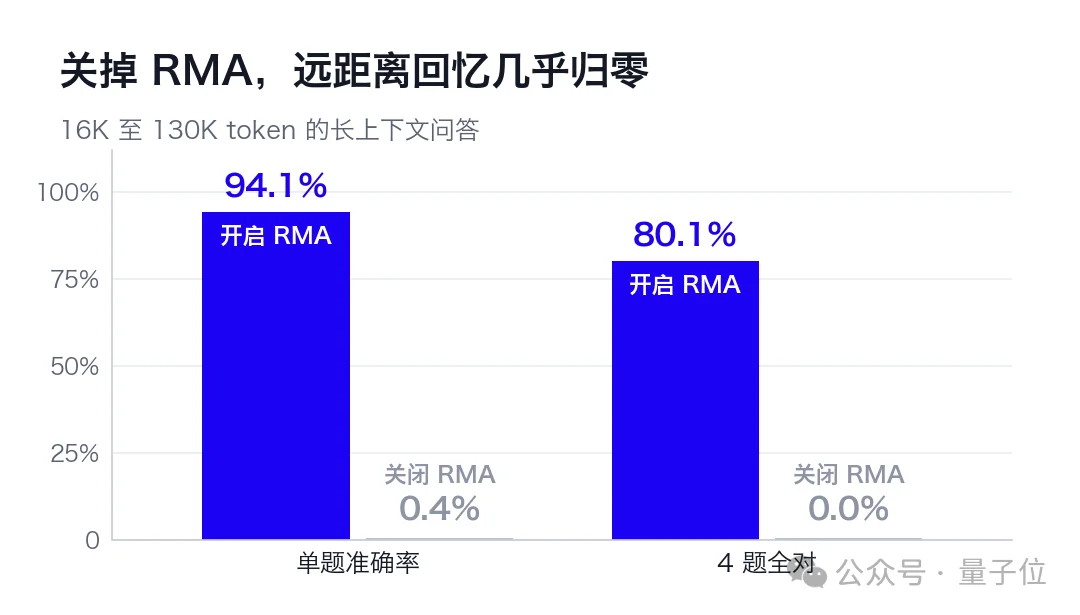
远距离回忆几乎归零。这说明,EdgeRock确实是靠锚点在读取远处的信息作答。
而且每个锚点都记录了来源位置,可以直接查看模型选择记住了什么。
EdgeRock由岩山科技旗下岩芯矩阵,联合港科大、CMU等高校共同完成。目前模型已开源,可商用。
团队透露,更多参数规模的EdgeRock正在路上。
对于需要长时间运行的机器人来说,这套机制也挺有想象空间。
毕竟机器人一边感知环境、一边规划动作,任务跑上几个小时甚至更久,总不能让历史缓存跟着无限膨胀。
如果推理过程中的内存占用能提前算清楚,端侧部署也能省不少事。
至于内存还会不会跌,交给市场去回答。
但至少有一件事已经变了:模型想得再久,记忆也不会再膨胀。
论文地址:https://rockmatrix.ai/documents/edgerock-report-zh.pdf
GitHub:https://github.com/rockmatrix-ai/EdgeRock
Hugging Face:https://huggingface.co/rockmatrix-ai/EdgeRock
文章来自于"量子位",作者 "允中"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
