
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI Agent 能否像研究人员一样,从论文中学习?
最近两年,大语言模型的能力不断提升,围绕模型构建的 AI Agent 也逐渐能够处理复杂的任务。从调用工具、操作软件,到规划和执行多步骤工作流,Agent 从处理简单的问答,走向能够独立解决长程复杂工具调用的任务。与此同时,每天也都有很多新的 agent 领域的 preprint 公开在 arXiv 中。
但一个现实问题随之出现:当 Agent 遇到能力瓶颈时,我们该如何让它变得更好?
最直接的办法是训练更强的模型。然而,Agent 的表现并不完全取决于底层模型。工具如何调用、上下文如何管理、经验如何复用,以及任务如何规划,都会影响最终的执行效果。
这些围绕模型运行的软件系统,通常被称为 Agent Harness。
近期,Meta Harness 等研究开始探索自动优化 Harness:让一个 Coding Agent 分析任务执行中的失败,再尝试修改 Harness 的代码,并通过实验寻找更好的版本。
这种方式已经展现出一定潜力,但也存在一个明显的局限:Coding Agent 提出的改进,很大程度上依赖于自身 Backbone 模型已有的知识,以及此前观察到的失败案例。如果一个问题还没出现,或者模型本身不知道某种更好的解决方法,它就很难主动探索相应的改进方向。
人类研究人员面对类似问题时,通常会阅读最新论文,了解其他研究者提出的方法,再尝试将这些方法应用到自己的系统中。那么,能否让 Agent 也具备这样的能力?
近日,来自 UCSB 和微软的研究团队提出了 ScholarEvolve,尝试将阅读研究文献、实现算法、评估效果这一研究过程自动化,让最新的学术成果能够直接参与 Agent Harness 的演化。
在不修改底层模型参数的情况下,ScholarEvolve 将 Qwen3.5-27B 在 AppWorld Challenge 上的任务完成率从 49.6% 提升至 63.6%,提高了 14.0 个百分点。
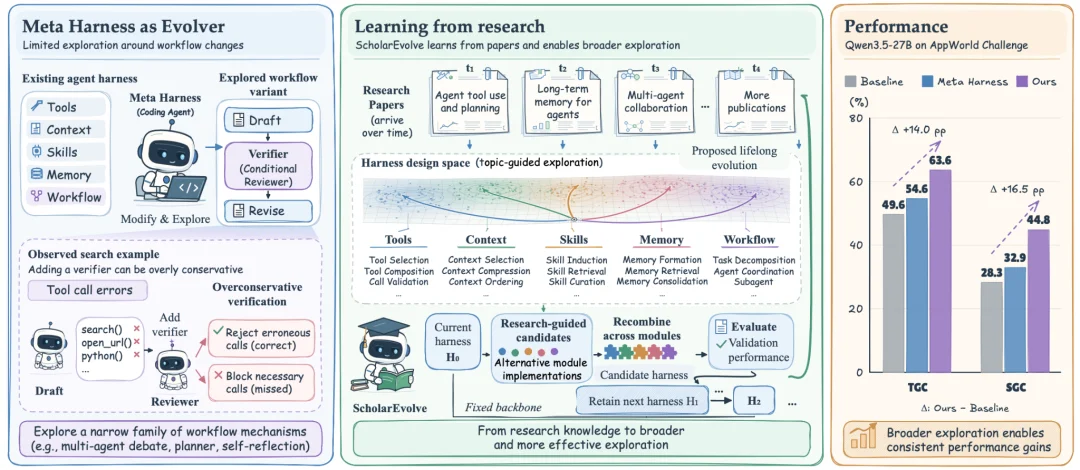
ScholarEvolve 的核心思路并不复杂:让 Agent 不再仅仅依靠自己的经验寻找改进,而是主动从研究文献中获取新的方法。不过,阅读论文只是第一步。真正困难的是,如何从海量研究中找到不同的改进方向,并将它们转化为能够合并起作用的 Harness。
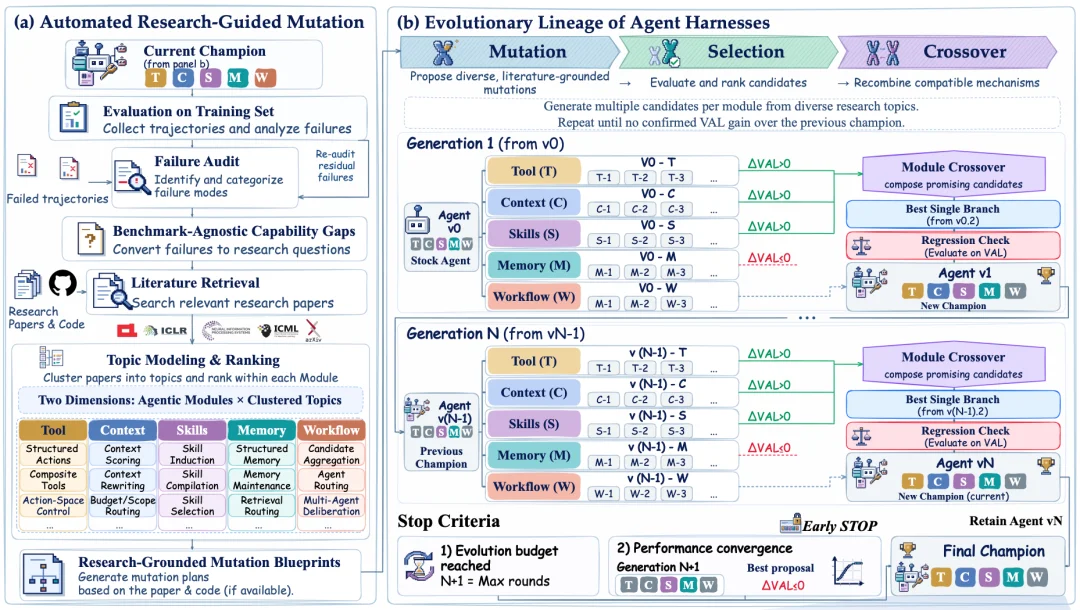
为了解决这个问题,ScholarEvolve 设计了一套自动化的研究与演化流程。
1)将 Agent Harness 拆成五个主要的功能模块。
这五个模块分别负责工具接口(Tools)、上下文管理(Context)、技能(Skills)、记忆(Memory)和工作流(Workflow)。这样的划分让系统能够更有针对性地寻找改进。例如,当 Agent 容易丢失历史信息时,可以研究新的上下文压缩或记忆检索方法,而当 Agent 无法有效完成长程任务时,则可以尝试新的任务规划与工作流设计。
2)让 Research Agent 从论文中寻找解决方案。
系统首先分析 Agent 的执行轨迹,识别反复出现的问题,并将其转化为更一般的能力需求。
随后,Research Agent 根据不同模块的职责构建检索查询,从 arXiv 等学术文献来源中寻找相关研究。
然而,ScholarEvolve 并不是简单地选择检索结果中最相关的几篇论文。因为高度相关的论文可能使用非常相似的方法。如果将有限的实验预算全部花在这些论文上,搜索就很容易局限于少数技术路线。为了解决这个问题,ScholarEvolve 使用 Topic Modeling,将检索到的论文按照不同的技术机制进行归类,并尽量覆盖彼此不同的研究方向。
例如,同样是改善上下文管理,有的文章通过压缩上下文降低长度,有的则通过检索重要片段保留关键证据。两者解决的是相似问题,却采用了不同的机制,这使得 ScholarEvolve 能够在有限预算内探索更多不同的解决方案。
3)将论文中的方法实现为代码,并寻找最佳组合。
Research Agent 会进一步阅读选中的论文,包括 GitHub 中的代码实现和附录里的 prompt 细节,生成具体的实现方案,再交由 Coding Agent 修改对应的 Harness 模块。每个候选实现都会在验证任务上测试实际效果。但一个模块单独表现好,并不意味着它与其他模块组合之后仍然有效。
因此,ScholarEvolve 还会尝试组合不同模块的改进,评估完整 Harness 的性能,并保留经过验证、优于当前版本的设计。
整个过程类似于一次自动化的科研:从最新的文献中提取核心方法,通过代码实现,再用实验结果决定是否采用。
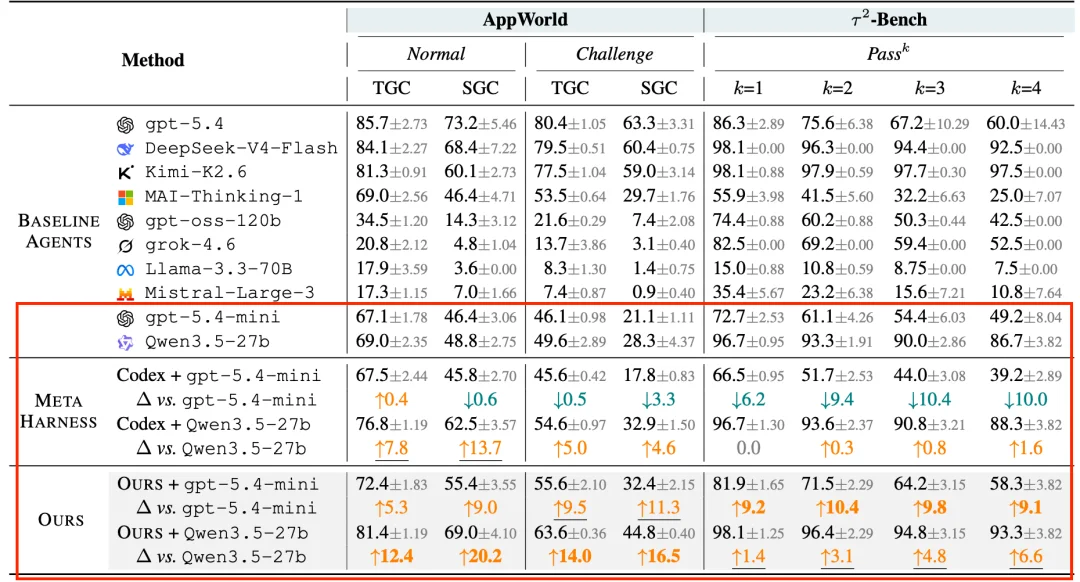
研究团队在两个具有代表性的 Agent Benchmark 上进行了实验:AppWorld 和 τ²-Bench。
实验分别使用 Qwen3.5-27B 和 GPT-5.4-mini 作为 Backbone 模型,并与原始 Harness 及 Meta Harness 进行比较。
在 AppWorld Normal 上,经过 ScholarEvolve 优化的 Qwen3.5-27B,任务完成率从 69.0% 提升至 81.4%。
值得一提的是,在 AppWorld Challenge 中。该测试集包含训练和验证阶段未出现过的 Amazon、Gmail 等应用,因此能够进一步检验改进后的 Harness 是否具备泛化能力。在这一设置下,Qwen3.5-27B 的任务完成率从 49.6% 提升至 63.6%。相比之下,同一实验设置下的 Meta Harness 仅仅达到 54.6%。对于 GPT-5.4-mini,ScholarEvolve 同样取得了明显提升,在 AppWorld Challenge 上将任务完成率从 46.1% 提升至 55.6%。
在 τ²-Bench Telecom 上,GPT-5.4-mini 的单次任务成功率也从 72.7% 提升至 81.9%。这些结果说明即使不进行额外的模型训练,仅仅优化 Harness,也能够显著改善 Agent 的实际表现
研究团队还进行了消融实验,分别考察文献指导、模块化搜索和 Topic Modeling 的作用。
结果显示,移除这些设计后,Agent 的表现会逐步下降。这说明性能提升不仅来自自动修改代码,还与如何寻找、组织和组合不同的研究方法有关。
另一个有意思的发现是:单独表现最好的模块,并不一定能组成表现最好的 Harness。这也进一步说明,Harness 的改进不能只关注某一个组件,还需要考虑不同模块在实际执行过程中的相互影响。
ScholarEvolve 更进一步的目标,是让 Agent 能够自动随着 Agent 研究进展持续改进。传统的 Harness 优化通常在完成几轮搜索后就收敛,最终得到一个固定版本的 Agent。但研究领域本身一直在发展。新的工具调用方法、记忆架构或推理策略,可能在几个月后才被提出。
ScholarEvolve 希望利用这些不断出现的研究成果,让 Agent 即使没有遇到新的失败,也能主动尝试新的改进方向。
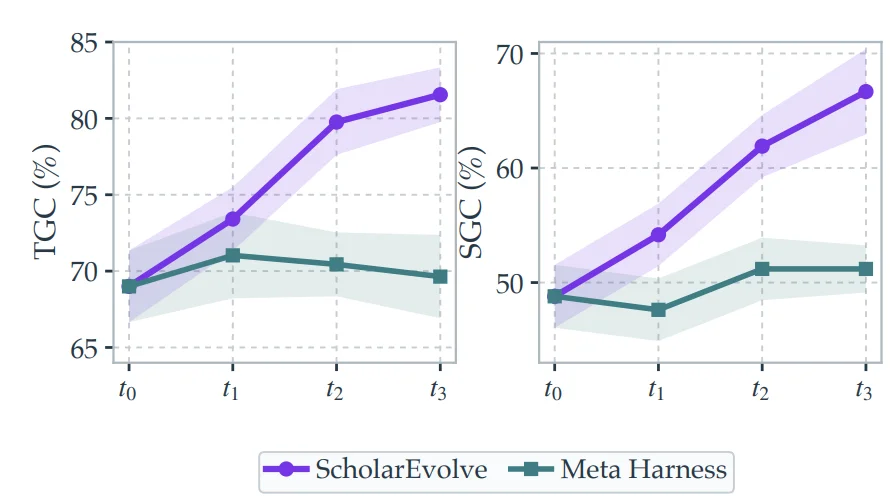
为验证这一想法,研究团队按照论文的发表时间构建了三个连续的研究窗口(25 年 12 月,26 年 1 月-4 月,26 年 5 月-8 月),在保持底层模型不变的情况下,模拟新论文逐步加入后的 Harness 演化过程。
实验结果显示,Qwen3.5-27B 在 AppWorld Normal 上的任务完成率,从最初的 69.0%,经过多轮演化,逐步提升至 73.4%、79.8%,最终达到 81.5%。
ScholarEvolve 并不意味着 Agent 已经能够完全自主地解决自身的所有问题。
论文的进一步分析也发现,虽然演化后的 Harness 明显减少了许多问题,但在复杂任务的约束跟踪、信息检索完整性等方面,仍然存在改进空间。
从论文中提取的方法也并不总是有效。部分候选实现甚至会导致性能下降,因此实际评估和筛选仍然不可或缺。
不过,ScholarEvolve 探索了一条值得关注的路线。过去,一篇新的 Agent 论文发表后,通常需要研究人员或工程师阅读、理解、复现,并手动集成到已有系统中,才能真正产生实际价值。ScholarEvolve 尝试将这一过程连接起来,让 AI Agent 能够主动阅读研究、实现新的机制,再通过实验检验它们是否真的有用。
随着相关研究不断推进,未来的 Agent 或许不仅能够完成用户交给它的任务,还能自动且持续地从新的知识中学习。
Jingbo Yang,加州大学圣塔芭芭拉分校(UCSB)计算机系博士生,研究方向包括大语言模型智能体、自进化系统、智能体记忆与高效推理。曾在微软开展研究实习,相关研究成果发表于 NeurIPS、ACL 等国际学术会议。
文章来自于"机器之心",作者 "Jingbo Yang"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
