
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
在多轮工具调用与复杂环境交互中,大语言模型正加速以 Agent 形态落地。受限于前沿大模型高昂的推理成本,如何将其决策能力迁移至轻量级模型,成为当前 Agent 研究的重要课题。
然而,不同于单轮文本生成,Agent 的每一步输出都会改变环境状态并影响后续轨迹,这引出了两个基本问题:
1. 在什么状态监督? 是在教师走出的预设轨迹上,还是在学生实际遇到的状态上?
2. 以什么粒度对齐? 是逐 Token 拟合词表分布,还是在更高层的 “动作语义” 上对齐决策?
围绕这两个问题,清华大学研究团队提出了 ActionOPD(Action-level On-Policy Distillation):在学生实际访问的状态下,以高层 “语义动作” 作为监督单元,在规避状态分布偏移的同时,实现了教师决策监督与学生 Token 表达的彻底解耦。
一、从 “逐字模仿” 到 “决策对齐”:
为什么 Token 级蒸馏存在局限?
审视当前主流的两类 Agent 蒸馏范式(图 1),二者在多轮交互中各有掣肘:
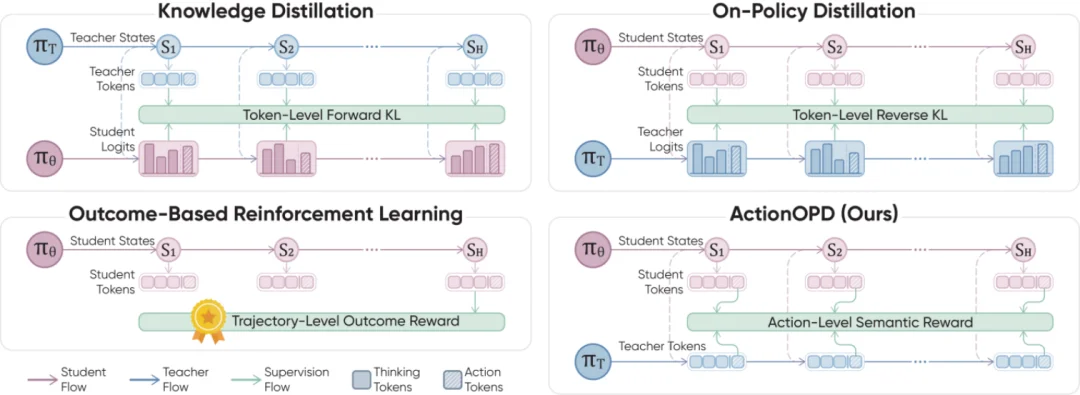
图 1:Agent 蒸馏范式对比。离线 KD 在教师轨迹上模仿 Token;Token 级 OPD 在学生轨迹上对比 Token 分布;ActionOPD 则在学生访问状态上直接奖励与教师动作 “语义一致” 的回复。
归根结底,上述两类方法的监督仍主要落在 Token 层面。然而,ActionOPD 的核心洞察在于:多轮交互中真正推动环境状态转移的是 “语义动作”,而非具体 Token 序列。 Agent 单步输出包含内部推理与外部动作:内部推理不直接作用于环境;外部动作无论是工具调用(取决于函数与参数语义)还是用户回复(取决于沟通意图与核心事实),均存在多种等价表达。例如,“基础经济舱不能改签” 与 “这类机票不支持变更” 措辞不同,但表达的限制一致。因此,若想让学生在决策层面而非字面表达上对齐教师,蒸馏目标就不应是拟合特定 Token 序列,而是最大化学生在当前状态下做出教师同义动作的整体概率。
二、ActionOPD 方法揭秘:
把动作语义一致性变成强化学习奖励
2.1 从动作似然自然导出策略梯度
确立 “对齐动作而非 Token” 的目标后,核心问题随之而来:当高层语义动作不再对应唯一固定的 Token 序列时,如何优化这一动作级概率?
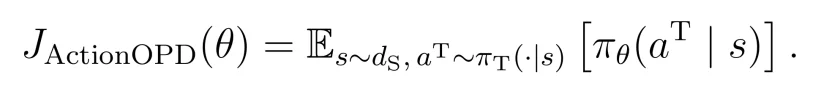
在语言模型中,同一语义动作可由多种推理路径与措辞实现,故学生做出某语义动作的总概率,等于所有能表达该语义的回复序列概率之和。尽管直接遍历求和并不现实,论文在理论上证明了一个简洁的等价关系:在学生实际访问的状态下,对 “期望教师动作似然” 求梯度,可严密转化为经典的 REINFORCE 策略梯度 —— 其中,“学生回复与教师动作是否语义一致” 恰好充当策略优化的奖励信号,且可通过有限采样高效估计。
这一性质带来两个直接优势:
1. 纯黑盒接口与跨家族兼容:只需从教师和学生分别采样回复,判断其中动作是否语义等价,即可构造蒸馏奖励,无需教师 Token log-prob 或同源 Tokenizer。
2. 动作监督与自主推理解耦:动作级奖励统一加权单步生成的所有 Token,直接强化学生自主生成的推理链与动作表达,无需逐字模仿教师思维链。
2.2 State-Group Rollout 与策略更新
如图 2 所示,为将上述理论落地到多轮训练,ActionOPD 设计了 State-Group Rollout(状态组采样)机制:
1. 并行采样师生动作:在每个访问状态并行采样多个教师动作与一组学生候选回复。
2. 动作级语义匹配打分:忽略内部思维链,仅提取外部动作比对语义 —— 工具调用通过参数规范化判别操作语义,用户回复则由 LLM 比对沟通意图与关键事实。命中教师采样即获基础正奖励,匹配多个教师样本则获小幅频次加成,非法输出受负向惩罚。
3. 环境推进与策略更新分工:推进环境时仅提交执行组内最高分动作,借教师偏好引导学生探索更有信息量的状态;更新参数时则复用组内全部候选计算归一化相对优势,通过 PPO 风格裁剪目标更新学生权重。
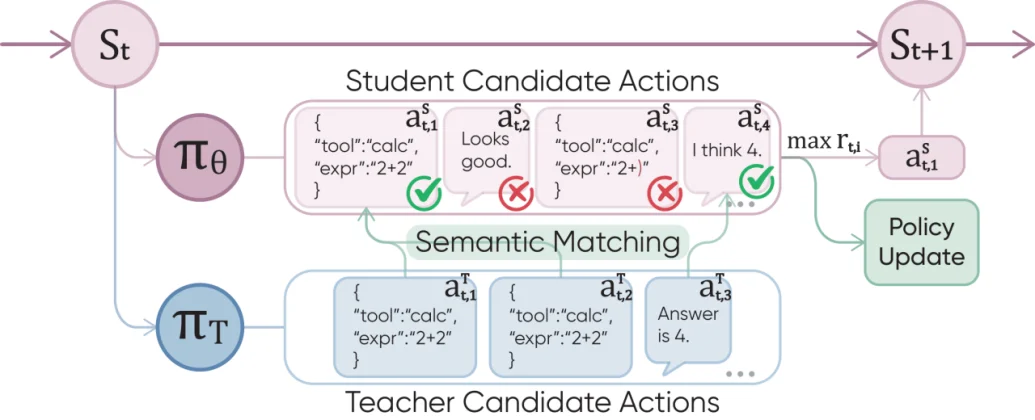
图 2:单状态下的 ActionOPD 流程。学生候选与教师采样集进行语义匹配打分;最高分动作被提交执行以推进环境,组内全部候选均用于更新策略。
三、实验结果:
跨基准泛化、跨家族蒸馏与真实案例
这种 “学决策而非抄 Token” 的范式效果如何?研究团队从跨基准与跨家族泛化、同族蒸馏受控对比及真实交互案例三个维度进行了验证。
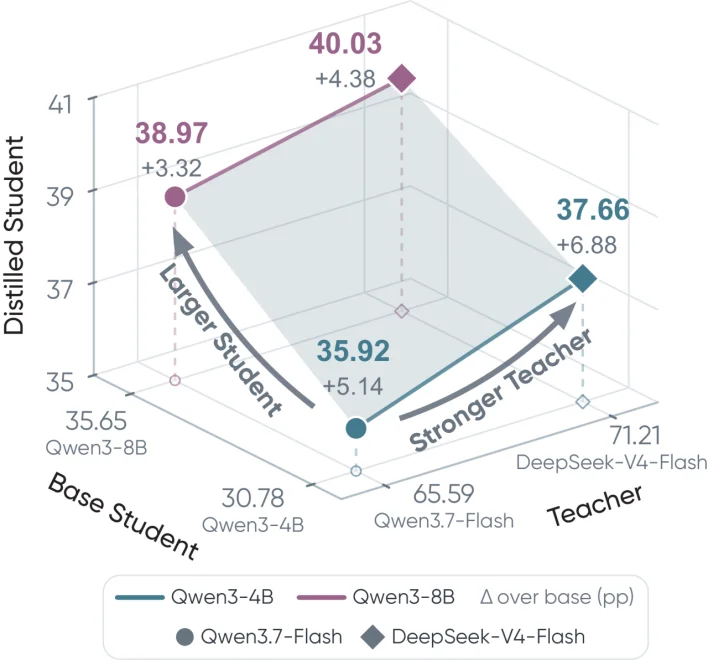
图 3:ActionOPD 的 Student–teacher scaling 特性。
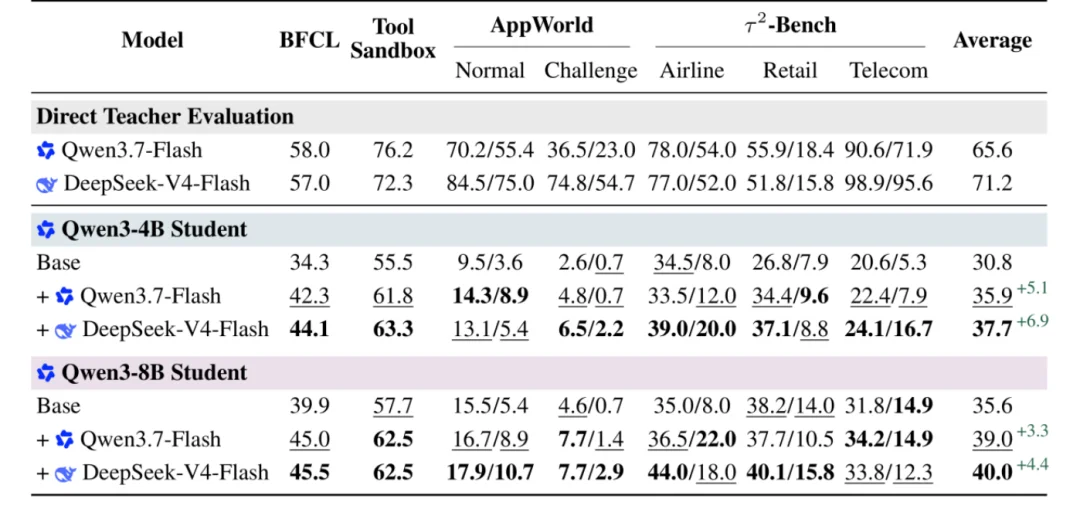
表 1:跨基准零样本迁移表现(%),绿色上标为相对同尺寸 Base 的平均提升。
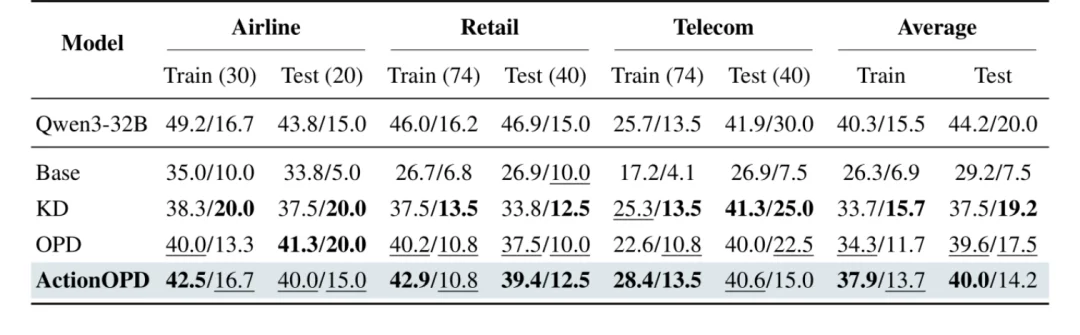
表 2:τ²-bench 蒸馏方法对比(单次成功率 pass¹ / 四次全成功率 pass⁴,%)。
1. 遵守业务规则约束:航空场景中面对禁改的基础经济舱,Base 仍盲目调用 API 违规改签,ActionOPD 则能严守规则并合规转接人工;
2. 准确区分信息源与操作目标:零售场景中需从历史订单提取地址以修改当前订单,Base 混淆源与目标订单导致漏改,ActionOPD 则准确完成 “查源地址 → 改目标订单” 链路;
3. 补全操作闭环与结果核验:电信场景中缴费后不会自动复机,Base 仅口头承诺恢复却漏调工具,ActionOPD 则主动调用 resume_line 复机并指导用户核验 SIM 卡。
四、Self-ActionOPD:
利用特权上下文实现同模型自蒸馏
既然 ActionOPD 只要求对齐外部动作语义、不强求模仿内部思维链,这自然引出一个设想:若没有更强的外部教师,同一个模型能否借助 “信息差” 实现自蒸馏?
在 Self-ActionOPD 中,同一个 Qwen3-4B 兼任师生:教师端额外输入未公开的用户目标、隐含规则与参考动作提示等特权上下文,学生端仅接收公开上下文。由于仅对齐外部动作,学生无需模仿教师基于特权信息的内部推理,而是直接学习在公开上下文下做出与 “开卷教师” 一致的决策。训练后撤除特权信息,仅凭公开上下文独立测试。
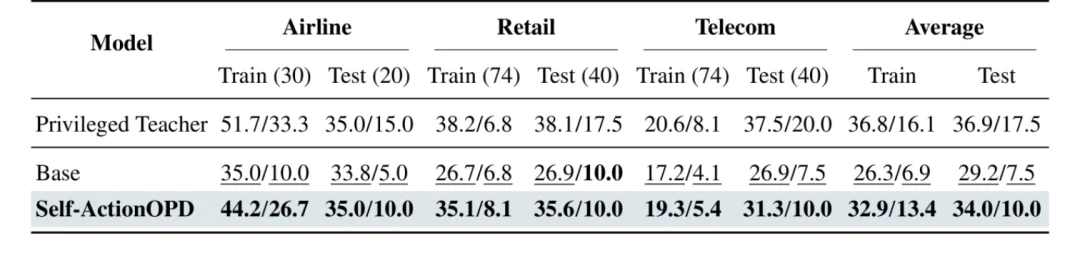
表 3:Self-ActionOPD 在 τ²-bench 上的实验结果(%)。
如表 3 所示,自蒸馏后的 Qwen3-4B 测试集 pass¹ 提升 4.8 个百分点、pass⁴ 提升 2.5 个百分点,三个子领域全面增长,表明模型能将 “特权视角” 下的高质量决策内化为常态能力,为探索 Agent 自我进化提供了可行路径。
五、总结与展望
围绕 “学决策而非抄 Token” 的理念,ActionOPD 将期望教师动作似然转化为带语义奖励的在线策略优化,仅凭黑盒文本接口即可打通跨家族在线蒸馏与同模型自蒸馏。未来,如何结合环境验证信号过滤教师失误、降低复杂动作匹配误差,以及在多合理路径状态中提升采样覆盖率,仍是值得深挖的方向。目前代码与模型权重均已开源,欢迎访问项目主页与 GitHub 仓库了解更多细节。
文章来自于微信公众号 “机器之心”,作者 “机器之心”

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
