
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
上个月告诉助手「订机票选靠窗座位,优先上午的航班」,这次出差让它订票,它还记得吗?换一个对话、交给另一个执行任务的 Agent,这条要求还在吗?
近日,DeepSeek 在《Super-agent 设计探索》中为下一代智能体提出了四个特征:连续、高效、主动、持久,并主张「Session 应当是系统的实现细节,而不应是用户的认知负担」。会话交给系统管理之后,用户交代过的要求、做过的任务、给出的反馈,怎样进入下一次工作,就成了系统设计要回答的问题。
常驻型个人智能体 Comma 给出了一套完整的工程实现:整个工作区只保留一条主会话,用快速决策模型 Jev 维护一份所有 Agent 共享的事实清单,让 Agent 自己编写监控程序,并根据人工验收和实际花费持续调整任务分配。
值得一提的是,Comma 在这条路线上起步更早。今年 4 月 28 日,Comma 的前身 Bridge 公开发布,产品形态就是一个常驻的主 Agent 统一接收请求、把具体任务分派给子 Agent;6 月 3 日,固定的主对话与任务委派在产品中正式上线。作为对照,Anthropic 在 6 月 23 日推出了理念相近的 Claude Tag,让团队在 Slack 频道里共用一个 Claude。10 月 1 日,Comma 正式发布,比 DeepSeek 的文章早了一个月。从公开发布算起,Comma 比 Claude Tag 早了近两个月,比 DeepSeek 公布 Super-agent 设计早了约半年,如今已经在真实的个人与团队工作中持续运行。
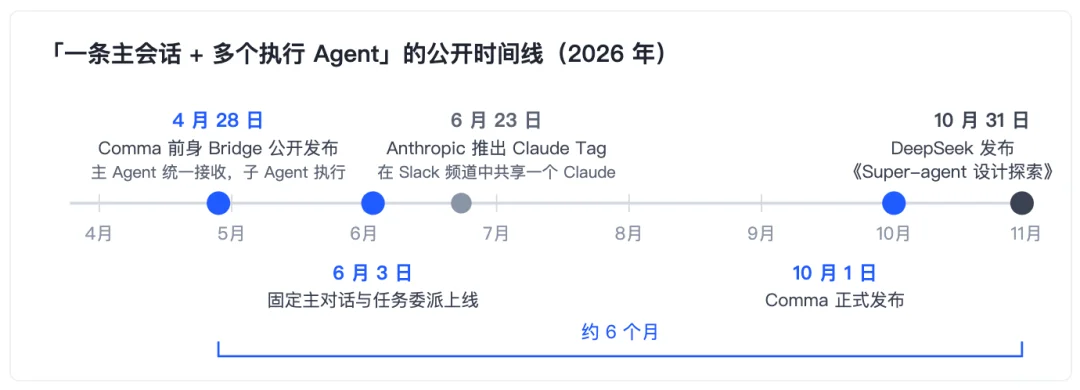
图 1 | Comma、Claude Tag 与 DeepSeek Super-agent 的公开时间线。
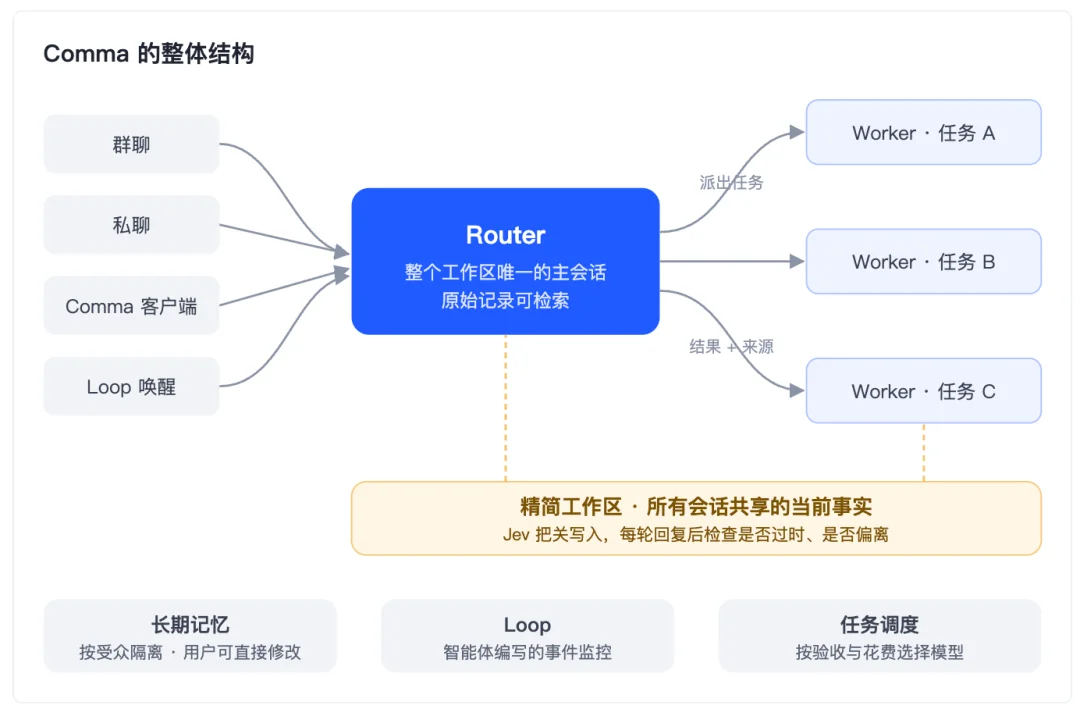
图 2 | Comma 的整体结构。一条主会话汇集所有入口,Worker 并行执行任务,精简工作区在所有会话间共享当前事实。
在深入细节之前,先看看 Comma 日常是怎么工作的。
路上随手拍一张广告牌,让它做一个复古滤镜 app。Comma 会派出 Worker 写好这个小应用并直接部署出预览,照片可以在里面套用各种复古滤镜:
图 3 | 演示:让 Comma 做一个复古滤镜 app。
在手机上,连接的邮箱、Slack 等应用,以及等待你确认的任务,都汇总在同一个地方:

图 4 | 演示:手机端汇总连接的应用和待处理任务。
Comma 为每个工作区运行一个常驻的 Router。群聊、私聊、客户端里的消息都进入同一条会话,Router 在多个讨论之间共享上下文。具体任务交给独立的 Worker 会话执行,完成后将结果和来源交回 Router。Comma 将这种设计称为 single-session。
这样一来,Router 始终在同一条会话中工作,所有任务结果都留在同一份连续记录里。上下文窗口占满时,较早的内容会被压缩出模型上下文,原始记录则完整保留:Router 可以在自己的历史中搜索原始消息和工具结果,包括已被压缩的部分,并读回完整原文。
举个例子,用户想知道上次去上海时为什么订了离地铁站远一些的那家酒店。Router 可以直接检索当时的任务返回、比价结果和执行记录,找到原因后再决定这次是否沿用。
单一主会话也带来新的挑战:Router 需要依次处理所有请求,历史越长,找到某个过去的决定所需的工作也越多。精简工作区正是为此设计的。
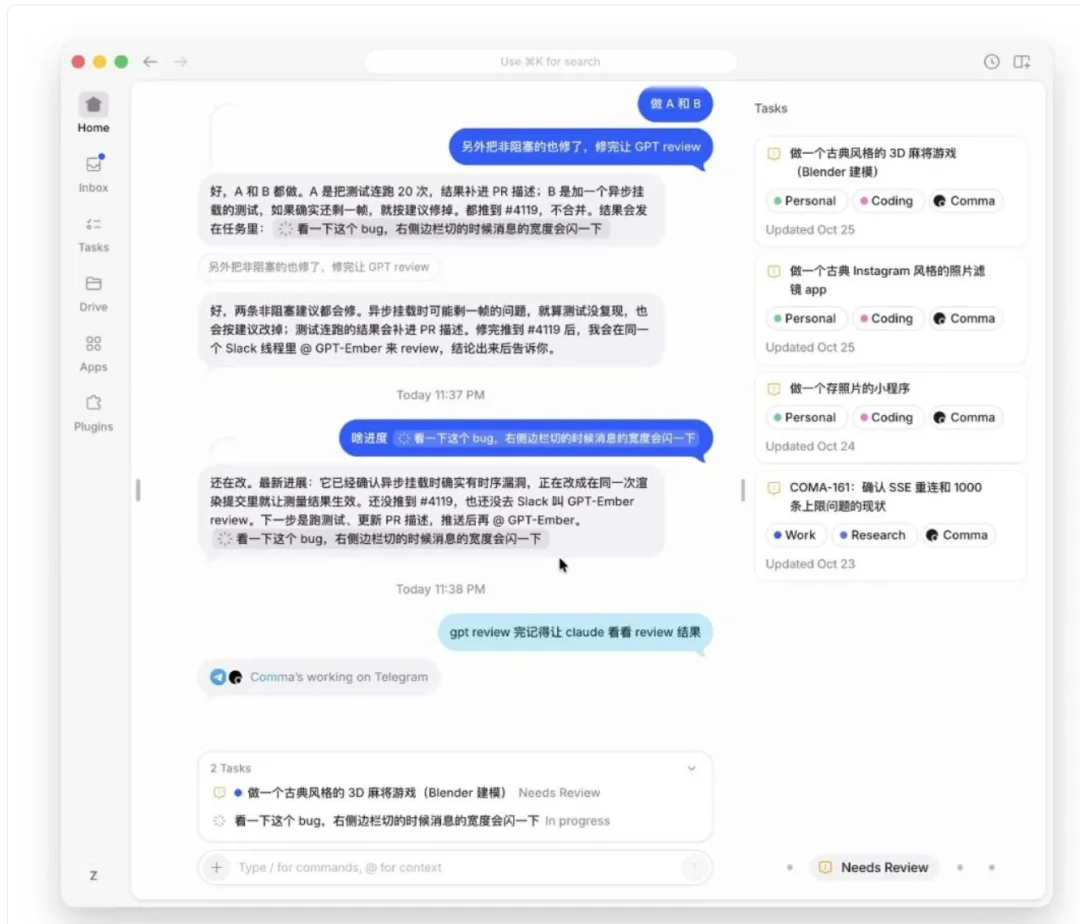
图 5 | Comma 客户端。左侧是与 Router 的主会话,右侧是它派出的各项任务及状态。
在同一条对话里,用户可以同时推进几件事。下面的例子中,「查局域网 IP 再连上空调」的任务还在等用户补充信息,用户已经接着让它看最近的邮件、问 OpenAI 昨天发了什么:

图 6 | 演示:一条对话里同时推进多项任务。
精简工作区(Condensed Workspace)是一份按工作区维护的事实清单,用户可以在 Comma 设置中开启。开启后,工作区内每个 Router 和 Worker 的上下文中都有这份清单的最新版本,每条内容是一句话。
清单进入了每个会话的上下文,写进去的内容就要可靠,过时的内容也要及时更新。Comma 把这两项判断交给快速决策模型 Jev。Jev 接收一段状态和若干个独立的问题,返回结构化的判断;对是非题,它给出概率,Comma 再按阈值决定如何处理。
写入前:逐条判断是否值得共享
Agent 新增或修改条目时,每一条都作为一个独立的是非题交给 Jev:这条内容是否属于工作区内其他 Agent 也需要知道的当前事实?任何一条的概率低于阈值,这次更新会退回给 Agent,由 Agent 做最终决定;它仍然认为应当写入时,可以确认后再次提交。
问题的问法经过对比测试。在人工标注的样本上,用反向问法提问时,合适的事实也会得到很高的概率,几乎所有更新都会被拒;改为正向提问后,两类内容之间拉开了明显差距,阈值就设在这段差距中。
每轮回复后:判断清单是否过时、工作是否跑偏
Agent 每完成一次回复,Comma 会结合当前清单、最近的对话和本轮的工具调用,向 Jev 提出两个独立的问题:
「需要更新」的概率超过阈值,系统会提醒 Agent 修改清单;「偏离」的概率超过阈值,会提醒它先对照当前事实和用户请求检查计划。提醒由 Agent 自行判断是否采纳。这两个阈值同样根据人工标注的回复确定。
回到开头的例子。用户提出「订机票选靠窗座位,优先上午的航班」,Agent 写入清单时,Jev 判断这是工作区需要共享的当前事实,条目随即生效。之后无论机票由 Router 自己预订,还是交给一个新建的 Worker 去比价,这条要求都已在上下文中。用户后来提到「最近腰不好,长途航班改选过道座位」,如果旧条目还留在清单里,下一轮的检查会判断清单已经过时,并提醒 Agent 更新。
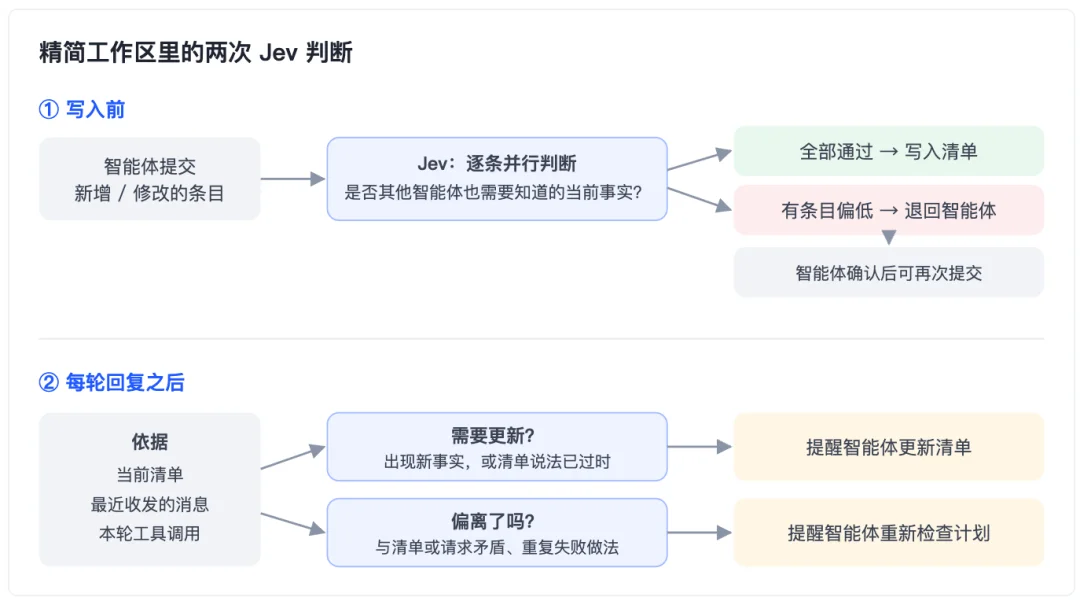
图 7 | 精简工作区中的两次 Jev 判断:写入前的共享判断,以及每轮回复后的过时与偏离检查。
精简工作区存放简短的当前事实,更完整的信息存放在 Router 的长期记忆中,包括用户偏好、相关人员、工作环境和按日期记录的工作日志。长期偏好、用户要求记住的内容和待交接的进度,由 Router 在对话过程中写入;Worker 通过任务交接获得所需信息。
在团队版 Comma for Teams 中,一个 Router 服务整个团队,它同时接收群聊、私聊和私密频道的消息,这些信息的读者各不相同。
为此,Comma for Teams 用信息流控制(Information Flow Control,IFC)管理信息的去向:每份信息都标明了哪些人有权读取,Agent 每次对外发送内容,都要声明用到了哪些来源,IFC 会检查目标对话里的读者是否都有权读取这些来源。检查通过才会发出;被拦下时,Agent 会收到原因,可以去掉受限内容后重新发送,或者请相应的人批准。IFC 的判定由一个用 Lean 实现的内核执行。
在团队版中,长期记忆遵循同样的规则。群组记忆对整个群组可见,所以来自私聊或私密频道的信息会写入按受众划分的笔记,笔记的读者范围由写入时用到的来源决定。比如,你在私聊里提到的客户报价,Router 会记下来供之后使用,而群里的其他成员看到的回复里,只会出现他们有权读取的内容。
长期记忆以文件形式保存,用户可以直接查看和修改:偏好写得过宽、口径已经过时,都可以直接修正;需要作为固定规则的要求,可以写入 Router 的指令。
在团队版里,成员之间的请求也会经过对方确认。下面的例子中,一位同事在 Slack 里让 Comma for Teams 去问另一位成员的 Comma 要 iOS 的进度,请求先送到对方那里,由对方选择拒绝、交给自己的 Router,或者直接创建任务:
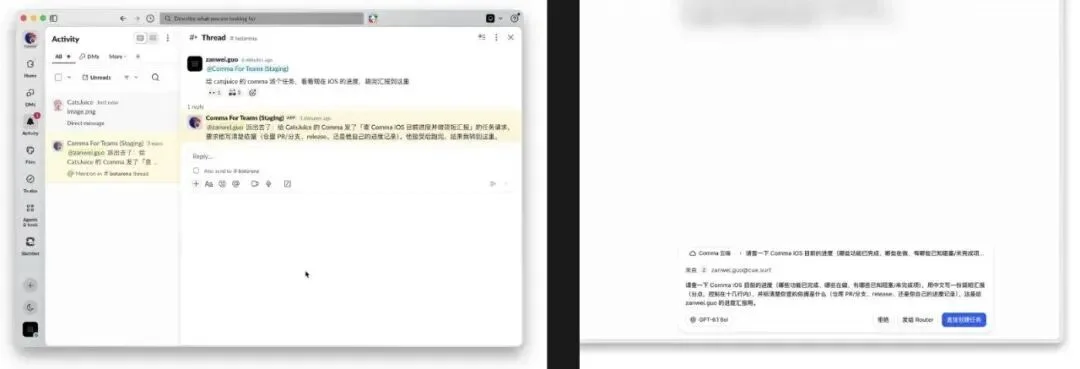
图 8 | 演示:团队版中,跨成员的请求先由对方确认。
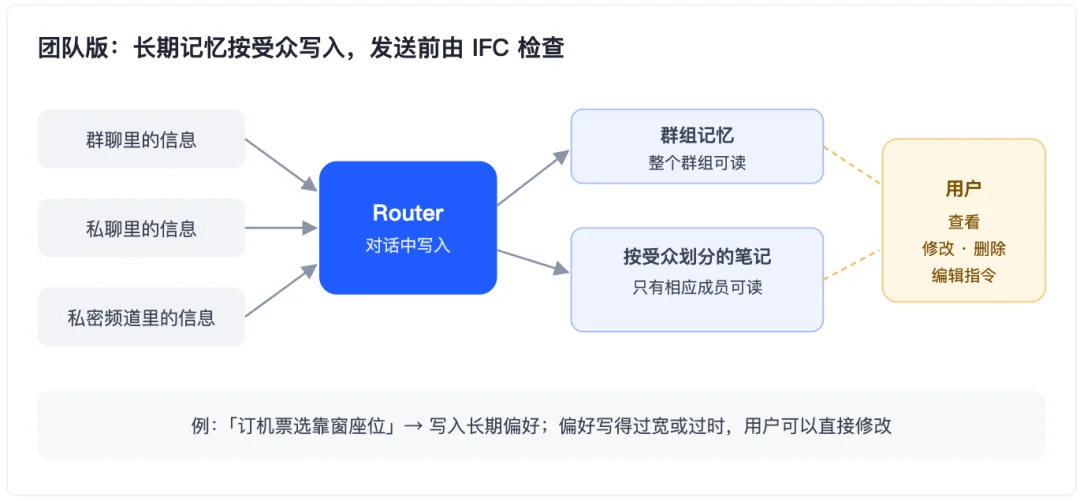
图 9 | 团队版 Comma for Teams 中,长期记忆按受众写入,对外发送前由 IFC 检查读者范围。
很多工作需要等待外部事件,例如合同签回、代码仓库出现相关变更、航班信息变化。Comma 让 Agent 为每项监控编写一段 C 程序,编译为 eBPF 后在集群中常驻运行,称为 Loop。
每个 Loop 等待定时器或事件,检查条件,必要时唤醒所属的 Agent。需要语义判断时,Loop 可以向同一个决策模型 Jev 提出结构化问题,Jev 只返回判断结果,具体操作和权限仍由 Agent 掌握。
Agent 写出的程序要和成千上万个其他 Loop 运行在同一个进程里,每个程序都只能访问自己的内存,这是整套机制成立的前提。为此,Comma 的 Loop 运行时 async-ebpf 给出了机器检查的证明:约 4 万行 Lean 证明确立,凡是通过校验的程序,编译成 x86_64 机器码后只会访问属于它自己的内存,返回时调用方的状态完整保留。证明针对的正是实际运行的代码:运行时的 Rust 模块经 Charon 和 Aeneas 翻译成 Lean 后再加以证明。编译 Loop 用的 C 编译器本身也被编译成 eBPF,在同样的沙箱中运行。
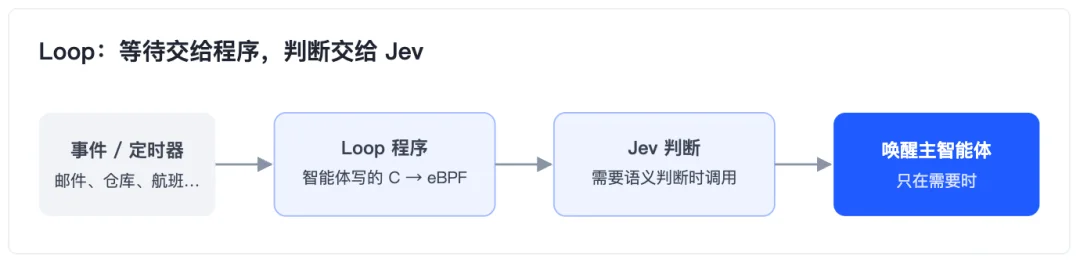
图 10 | Loop 的工作方式。
以航班比价为例:让 Comma 查第二天上海飞昆明的机票,它会先比出当前最便宜的航班,以卡片形式返回;之后的价格变化交给 Loop 持续关注,出现值得处理的变化时再叫醒 Agent 告诉用户。
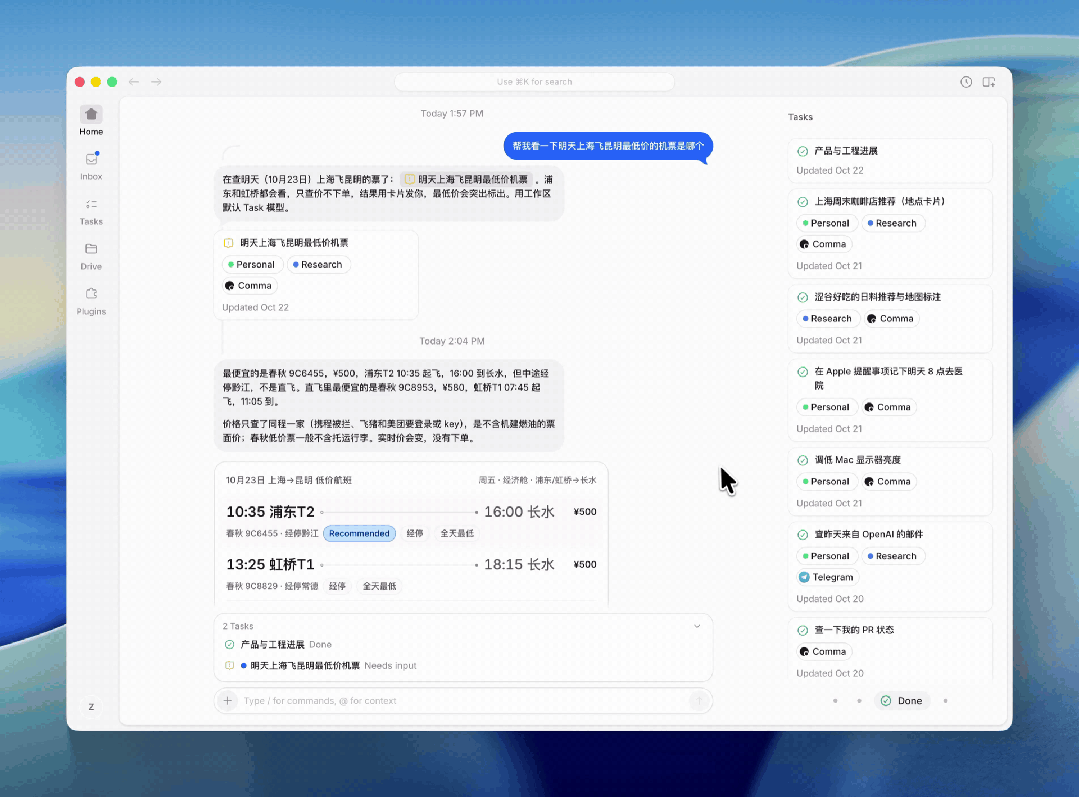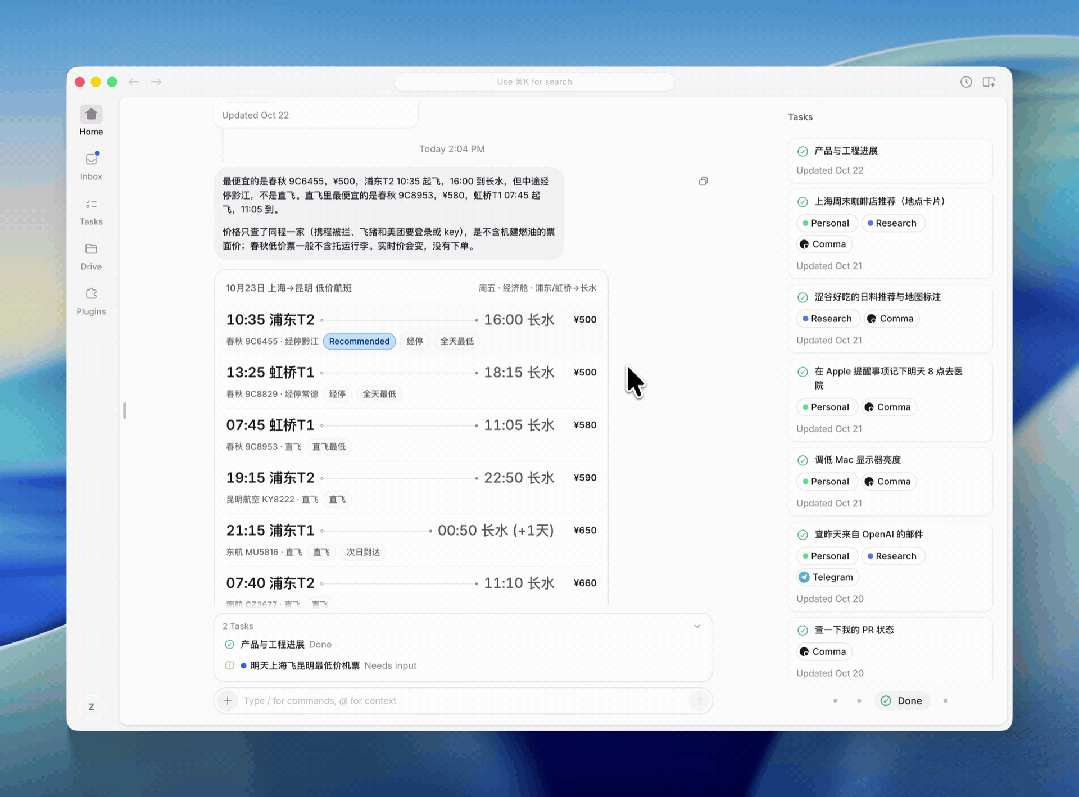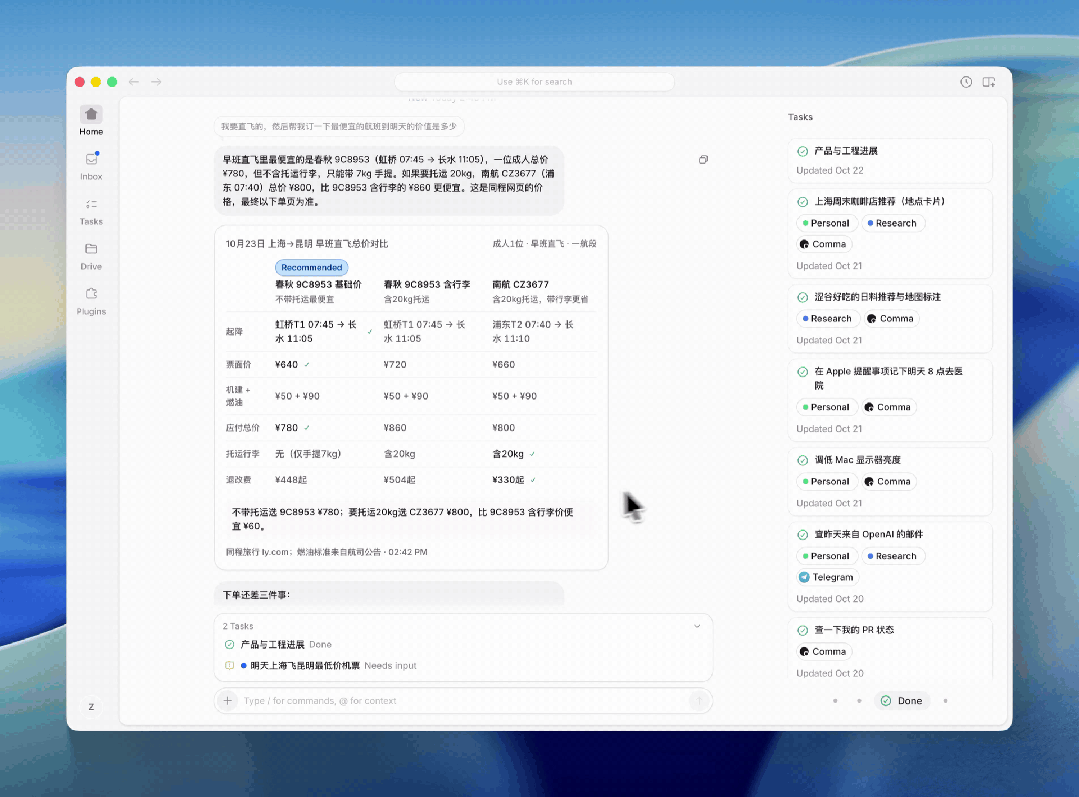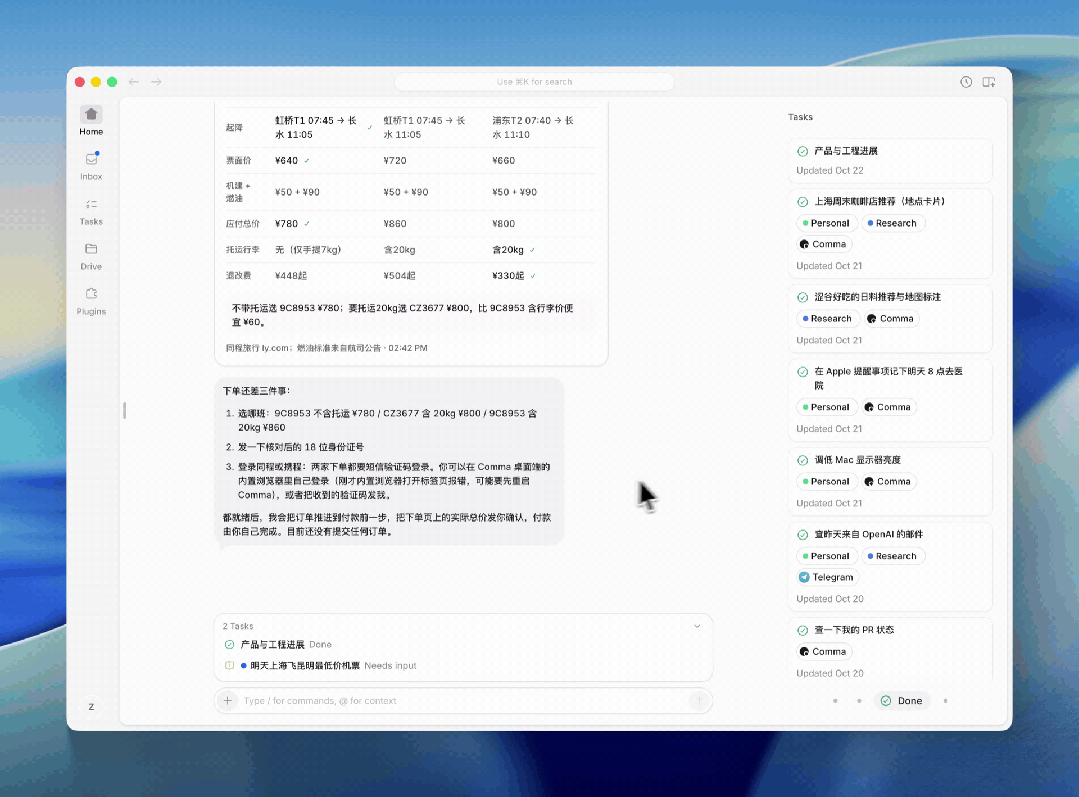
图 11 | 演示:航班比价,查询第二天上海飞昆明的最低价机票。
除了记录要求,Comma 还会根据任务结果调整任务交给哪个模型完成。
每个任务会被归入路由表中的某一类,例如「比价订票」「整理邮件」。调度层为每一类任务分别记录所用的模型和推理强度、完成次数与花费。完成与否以人工验收为准:待审核的任务被验收通过,记为一次成功;任务失败,记为一次失败。
在此基础上,调度层选择每完成一个任务平均花费最低的组合,并让少量任务在团队允许的模型范围内尝试其他组合,以积累比较的依据。每一类任务积累的记录越多,分配就越准确,成本也越低。
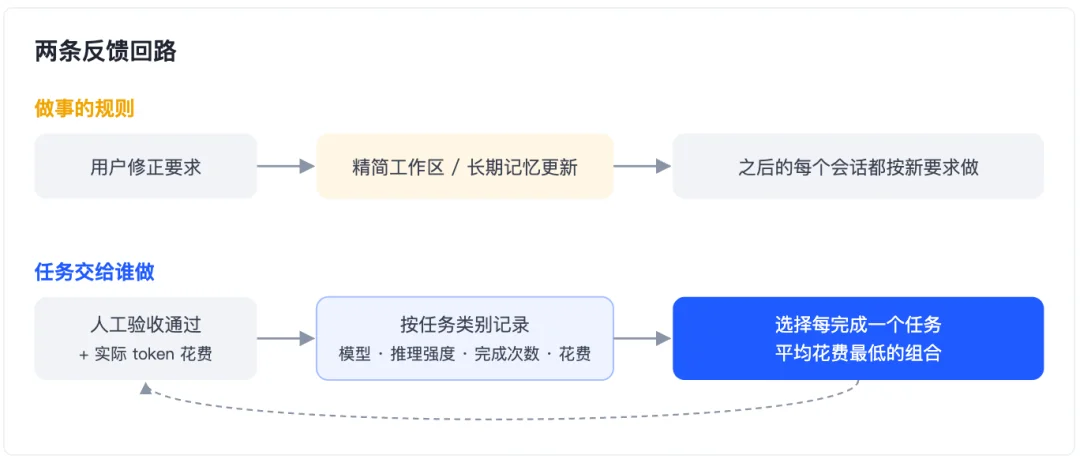
图 12 | 两条反馈回路:用户修正改变做事的规则,验收与花费改变任务交给谁做。
DeepSeek 提出的连续、高效、主动、持久,描述了下一代智能体的方向。Comma 在 DeepSeek 发文前约半年就已公开发布,并围绕其中的「持久」给出了自己的实现:一条主会话保留完整的工作记录,Jev 维护所有 Agent 共享并持续校验的事实清单,长期记忆按受众划分并交由用户修改,Agent 编写的 Loop 承担等待,任务调度从每一次验收中积累依据。
对用户来说,交代过一次的事会被记住并沿用,记错的内容也能找到并修改。随着 Agent 越来越多地常驻在团队的工作流里,这类系统层面的设计,会和模型能力一样决定 Agent 能否长期胜任工作。
文章来自于"机器之心",作者 "机器之心"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
