
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
近年来,AI 算力的赛道上从来不缺故事。
就连行业巨头英伟达也不能免俗。在今年柏林的 GTC 大会上,黄仁勋带着一群可爱的机器鸭 Microduck 亮相。小黄鸭们应声起立,坐下,翻跟头,一下子风靡全球。
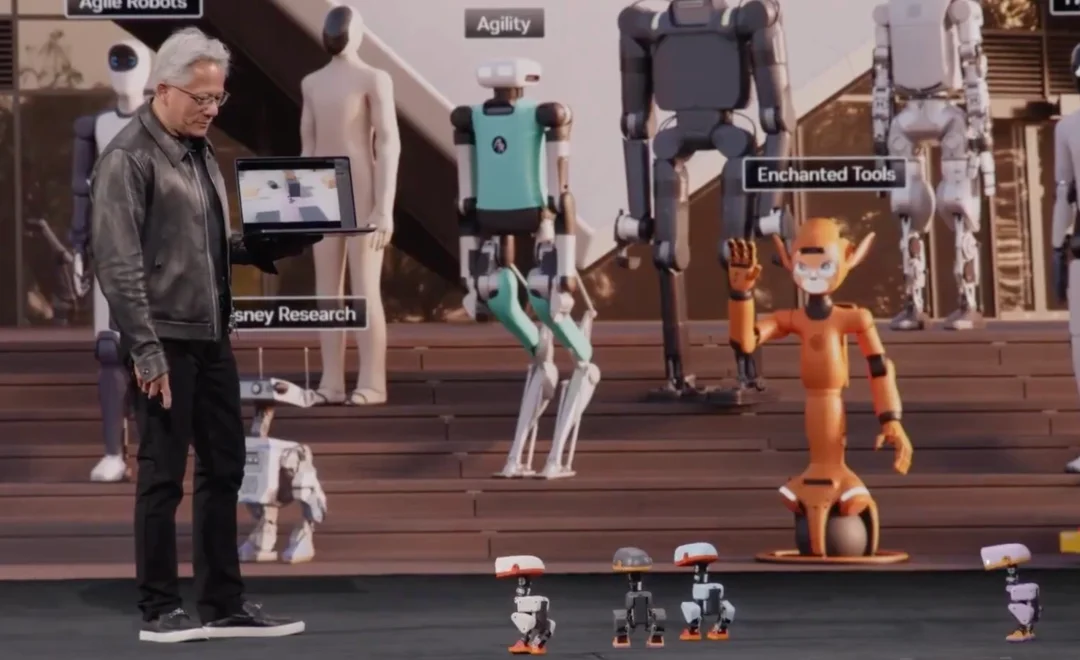
黄仁勋说这些小黄鸭「在 RTX Spark 上诞生,在云端一堆英伟达超级计算机上训练,又在数字孪生里学会了本事」。
近日,天数智芯在上海举办了主题为「从模型到世界」的媒体开放日。这是这家今年 1 月登陆港股的通用 GPU 公司,上市以来首次系统性地向媒体展示产品全貌。
而「手搓版」Microduck 也出现在了开放日现场。这是通过 3D 打印和手工组装制作的机器鸭,在现场表演「走路、打盹、起身」等动作。
以下视频来源于天数智芯
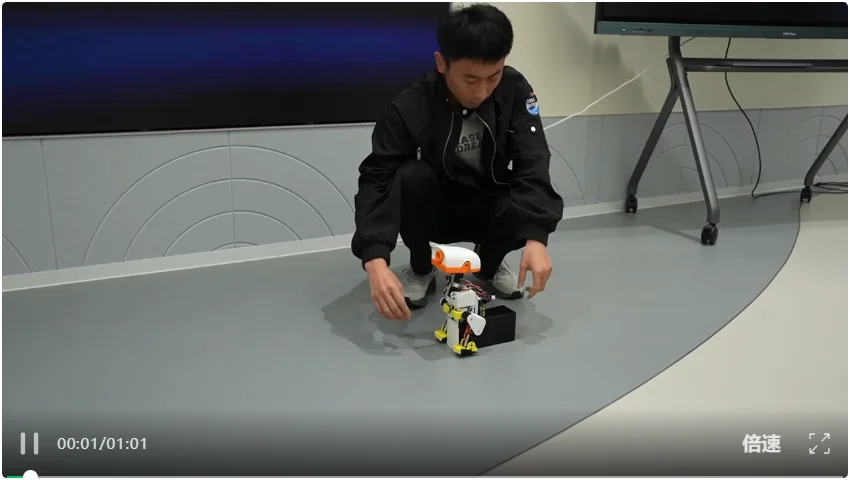
和英伟达方案不同的是,英伟达的小黄鸭训练仍然依赖云端算力的支撑。而天数智芯的小黄鸭,在一台端侧设备上完成了全部训练流程。
这是天数智芯最新端侧算力终端 彤央 TY1200 ,稠密算力标称值为 300 TOPS,实测性能超越英伟达 Thor T5000。
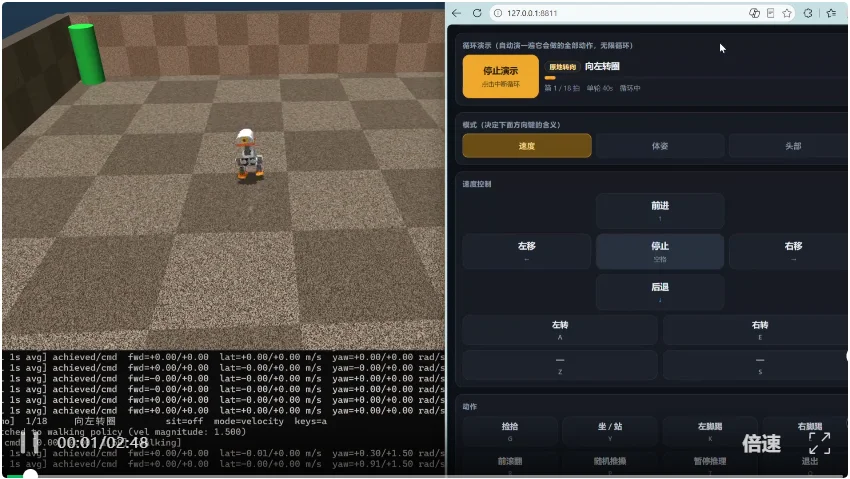
在现场,一台彤央 TY1200 终端,独立完成了从环境构建、策略训练到实时仿真的全流程,机器人在虚拟环境中学会行走的过程被完整呈现。这是国内端侧产品首次实现 GPU 加速的物理仿真引擎本地运行。
在此次开放日中,同台亮相的除了端侧算力终端彤央 TY1200 之外, 还有最新的算力卡天垓 300 云端通用 GPU,「用 AI 开发 AI」的软件栈。
硬核内容警告。接下来,我们将关注端侧,看看这个能把英伟达在云端完成的小黄鸭训练拉到本地的国产终端,到底是什么来头。
端侧机会的出现,首先与模型能力的变化有关。
斯坦福 HAI《2025 AI Index》记录了一个变化:在 MMLU 上跨过 60% 得分门槛的最小模型,参数规模从 2022 年的 5400 亿,降至 2024 年的 38 亿。它说明,达到一定能力水平所需的模型体量正在飞速缩小。
在近期发布 Jetson 新模组时,英伟达表示,通用机器人和自主机器正在从研究机构走向大众市场,由此催生了对能够在边缘运行基础模型、紧凑且高能效的 AI 超级计算机的需求。
与此同时,端侧算力芯片本身也在快速迭代,算力密度和能效比逐代提升。两条曲线正在交汇,而彤央 TY1200 恰好站在了这个交叉点上,成为国产端侧算力一个全新的里程碑。
实测对标:TY1200 vs NVIDIA Thor T5000
这次,成为了各位媒体老师目光焦点的小黄鸭,正是在彤央 TY1200 端侧算力终端上完成的全链路训练。
TY1200 的算力表现究竟有多强?从标称参数来看,它拥有 300 TOPS 的稠密算力,已经相当可观。但更令人意外的是,在实际测试中,TY1200 的性能表现甚至超过了英伟达 Thor T5000。
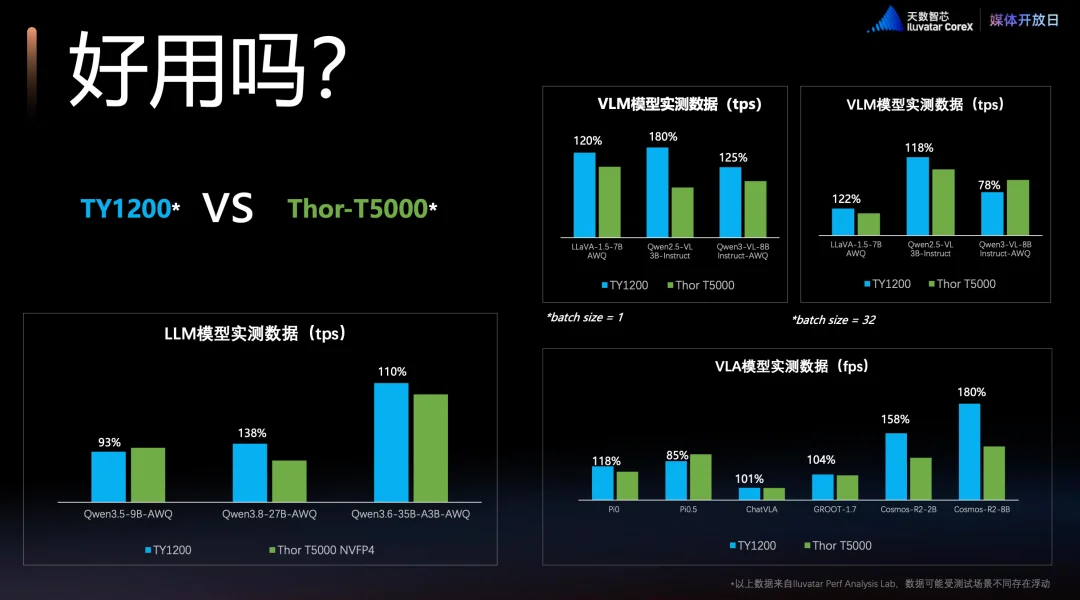
首先看 LLM 实测数据。生成吞吐,衡量的是单位时间内能够生成多少 Token,也就是模型处理和生成文本的基本单位。TY1200 运行 Qwen3.8-27B-AWQ 的生成吞吐,达到 Thor T5000 对照方案的 1.38 倍。在 Qwen3.6-35B-A3B-AWQ 上,这一数值为 1.10 倍。
在能够处理图像与文本的视觉语言模型测试中,TY1200 也取得了较高的相对成绩。例如,运行 Qwen2.5-VL-3B-Instruct 时,其生成吞吐为 Thor T5000 的 1.80 倍;Batch Size 到 32 时,则为 1.18 倍。
VLA 相关测试中,TY1200 在 Cosmos-R2-2B 和 Cosmos-R2-8B 上的表现,分别为 Thor 的 1.58 倍和 1.80 倍。
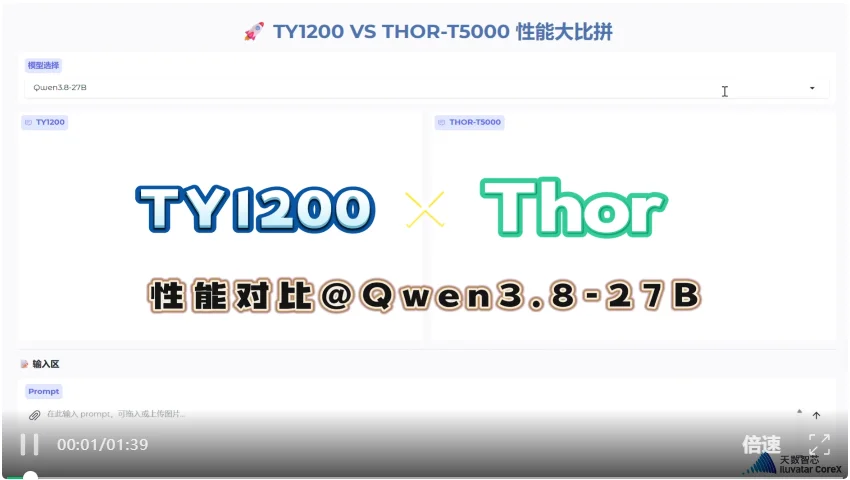
实机对比视频则把体验呈现得更直观。两台设备接收同一提示词后,TY1200 用了 0.223 秒开始返回首个 Token,Thor T5000 为 0.411 秒;随后,TY1200 的生成速度达到每秒 30.21 Token,而 Thor 为每秒 24.46 Token。
打开端侧的无限空间
当算力从云端落到本地,AI 应用的边界也会随之拓宽。
越来越多的模型能够摆脱云端算力,甚至能够在本地完成训练之后,不仅意味着更低的延迟、更好的数据隐私保护,也让 AI 有机会深入实验室、医院、机器人等更多真实场景。
在实验室,AI 正在改变科研人员处理数据的方式。
天数智芯联合河海大学新能源学院与常州电池协会,面向储能电芯研发打造了垂直 AI 智能体,并已部署在河海大学金坛校区的电池材料分析实验平台。在 TY1200 的算力支持下,系统打通了从专业仪器数据采集、清洗校验、结构化入库到智能分析、报告生成的完整流程,仅需约 2 分钟即可生成分析报告。
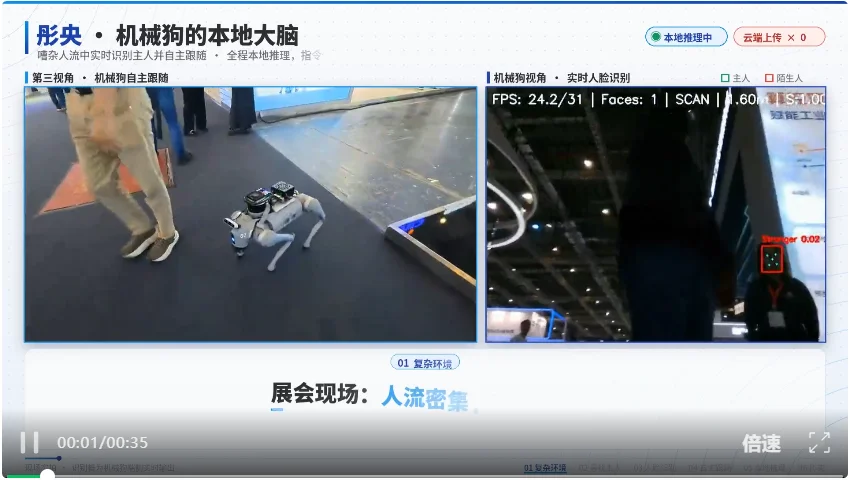
在复杂动态环境中,机器狗展示了端侧 AI 的实时感知能力。
现场视频同时呈现第三人称画面和机器狗的第一视角。摄像头捕捉到人脸后,系统完成目标识别,机器狗随即跟随目标移动。据介绍,人脸检测、识别及相关决策均由搭载的 TY1000 模组在本地完成。
在博物馆,一台设备还能实现「白天工作、夜间训练」。
根据天数智芯的介绍,TY1200 白天支持视觉、语音与大模型结合的智能导览服务,夜间则用于 CV 小模型训练。这种模式让端侧设备既能承担日常推理任务,也能利用空闲时段参与模型更新,提高算力资源的利用效率。
在医院,端侧 AI 已经走进真实的服务场景。
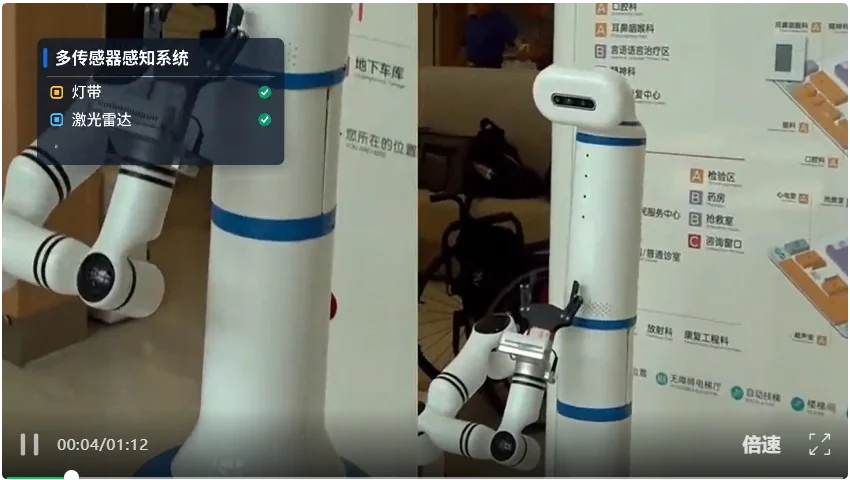
由 TY1200 提供算力支持的陪诊机器人,已在上海市阳光康复中心投入使用,为视障人士提供路线引导、就诊流程指引等服务。相比简单的语音交互,这类应用还需要将环境感知、信息理解与现场行动衔接起来,对端侧算力提出了更高要求。
端侧算力的消费模式正在从「连接云端做推理」转向「独立完成训练 - 推理 - 部署全链路」。彤央产品线的定位,正是为这种新的算力消费模式提供硬件基础。
以边端产品完美衔接「算力分层」
为什么一家通用 GPU 厂商,要把算力进一步带到办公桌、实验室,甚至机器人身上?
在开放日上,天数智芯彤央产品市场负责人宋远盈给出了三个理由:业务变了,技术变了,商业资源也变了。
首先,随着物理 AI 兴起,越来越多的数据直接产生于真实世界,机器人、工业设备等场景对实时响应的要求也越来越高。与此同时,企业对数据安全和隐私的重视,也让合同、财务、源代码等敏感信息有了更强的本地处理需求。算力越靠近数据,越能满足这些场景对时延和安全的要求。
其次,模型正在变得越来越「小而强」。过去需要更大参数规模才能完成的任务,如今可以交给更小的模型处理。这意味着,端侧设备已经能够承载越来越多真正有用的 AI 能力。
最后,还有一笔经济账。随着 AI 从尝鲜走向规模化应用,企业开始认真计算 Token 成本、设备投入与长期使用效率。对于高频、稳定的本地任务,端侧部署有机会减少持续调用云端 API 的开销。
三股力量共同推动了「算力分层」的现实需求。不是所有的 AI 需求都需要云端服务,复杂任务由云端承担,实时性要求高、适合就地处理的任务下沉到边端,让每一份算力都用在最能发挥价值的位置。
而对于天数智芯这样的通用 GPU 厂商,布局边端还有一项重要基础:云端积累的 GPU 架构、软件栈和模型优化经验,可以进一步复用到边端。
这也是彤央产品线强调 「端云同源」 的原因。模型在云端训练,在边端部署,通过统一的 GPU 架构和软件生态,降低模型迁移与应用适配的成本。对于客户而言,获得的不再只是一台算力设备,而是一套能够贯通云边端的计算能力。
算力分层打开了更多商业化的可能,也对端侧产品的形态和能力提出了不同要求。 不同场景对算力规模、功耗、设备形态和部署方式的要求差异很大,端侧产品也需要有足够丰富的选择。
因此,产品矩阵的梯度化,正在成为端侧算力厂商的共同选择。 以英伟达为例,其 Jetson 产品线覆盖了从 70 TOPS 到 2000 TFLOPS 的不同算力档位,以适应从轻量级边缘 AI 到高性能机器人计算的多样化需求。
为此,天数智芯推出的彤央系列并非单一的算力终端,而是构建了覆盖不同场景、不同算力需求的完整产品矩阵,可以概括为 「1 套生态、2 种形态、5 款产品」,让算力分层的理念真正落到产品层面。
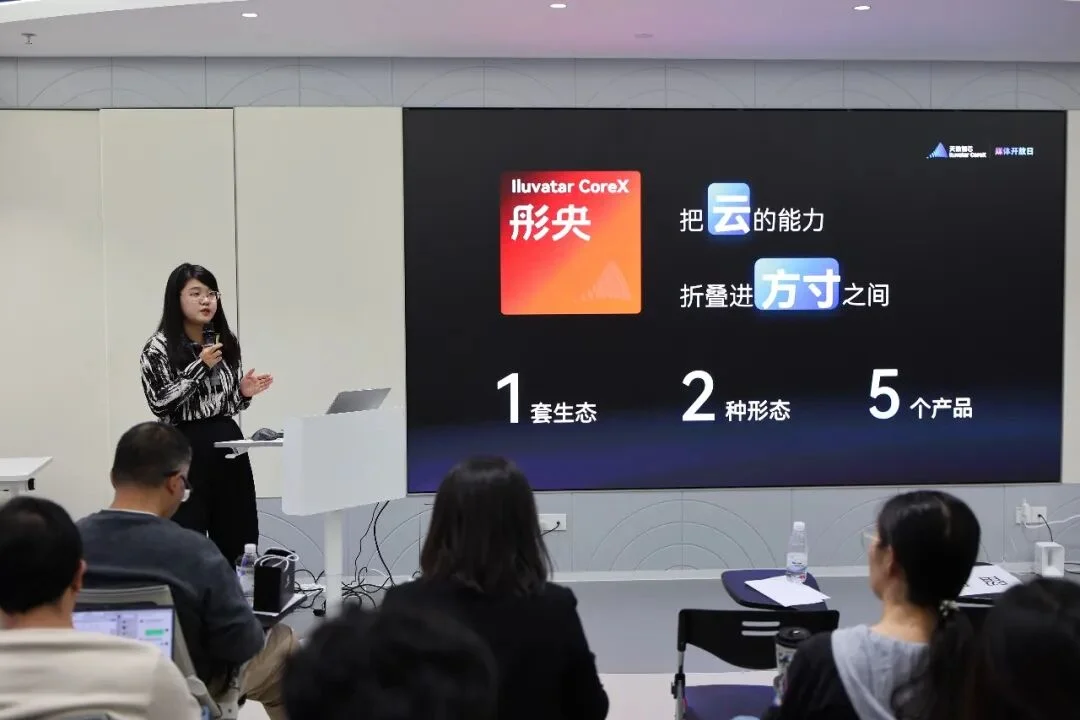
其中,「1 套生态」指的是端侧沿用了云端的通用 GPU 架构和完整软件栈,让云端与端侧能够共享技术生态;「2 种形态」分别是面向研发客户、支持灵活集成的算力模组,以及面向业务客户、主打即插即用的算力终端;「5 款产品」则覆盖了从轻量级到旗舰级的不同算力档位,满足多样化的端侧计算需求。
长期以来,CUDA 生态的护城河,很大程度上建立在十几年积累的算子库和数以百万计的开发者经验之上。
大模型的编程能力,正在改变一切。今年 2 月,字节跳动 Seed 与清华大学 AIR 发布 CUDA Agent,用大规模智能体强化学习训练模型编写高性能 CUDA Kernel,在 KernelBench 的三个难度子集上,生成 Kernel 快于 PyTorch 实现的比例分别达到 100%、100% 和 92%。英伟达同样推出了 Jetson Agent Skills,让智能体接手内存优化、系统配置和部署等工作,把原本需要数周的优化缩短到数天。
此外,模型从云端走向本地时,需要改动多少代码,已有工具能否继续使用,后续版本能否顺利升级。对于天数智芯这样的通用 GPU 厂商,云端积累的软件栈和模型优化经验,正是布局边端可以继续利用的基础。
英伟达在 2025 年推出 Jetson Thor 时,将其定位于物理 AI 和机器人,并强调通过配套软件栈连接云端与边缘开发。其 JetPack 7 对 Arm 平台统一 CUDA 安装方式的支持,也体现了降低跨平台开发成本的方向。
在智能体飞速发展的浪潮下,天数智芯正将 Agentic AI 引入 GPU 软件开发,让过去高度依赖工程师经验的开发、适配和调优工作,逐步走向自动化。
软件栈的核心思路是「易于使用、易于优化、易于开发」三个层次。
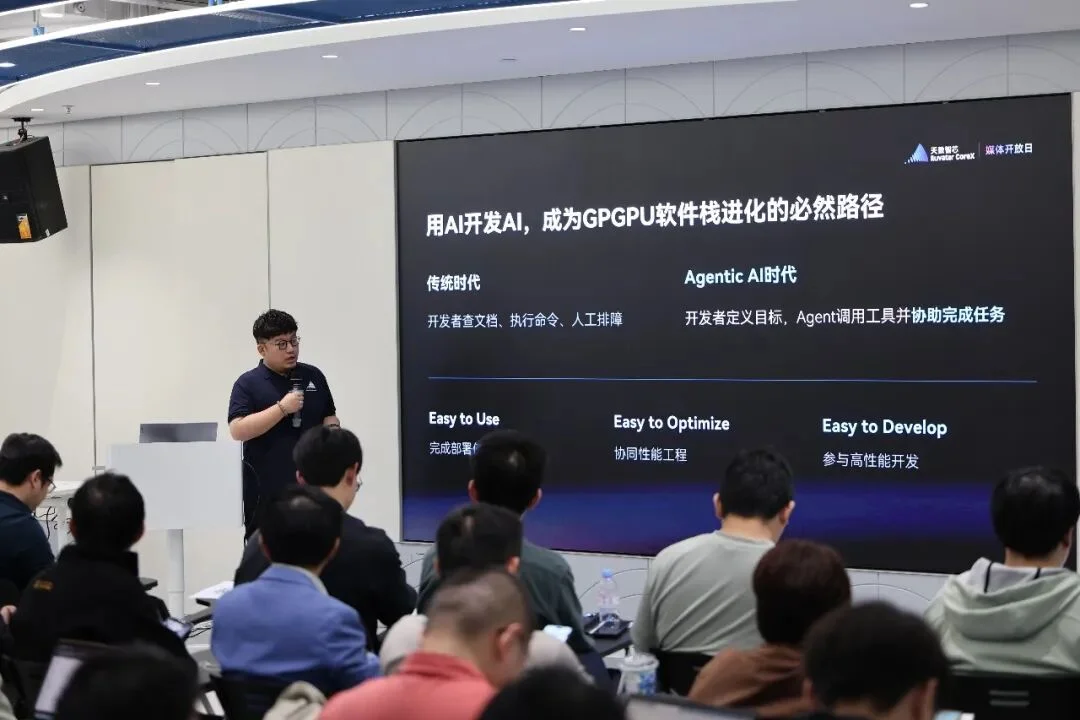
这套方法论总结为「用 AI 开发 AI」。当大模型本身成为 GPU 软件开发的工具,GPGPU 的生态建设将从依赖人力堆叠转向 AI 驱动的自动化迭代,这对于繁荣国产 GPU 生态尤其重要。
「Agentic AI 让一位工程师的经验,能够持续服务千千万万开发者。」
国产算力正在经历一场成人礼。
过去几年,这条赛道从来不缺令人眼花缭乱的参数和性能指标。但真正稀缺的,是敢于把产品摆上台面、把性能数据公开、接受真实测试与市场检验的勇气和底气。
几年前,国产算力卡更多扮演「备选项」的角色。供应受限时,客户愿意为可用性让步,对性能差距和生态短板给予足够的包容。如今,国产算力行业正在跨过一道重要的门槛:正从过去追求算力规模的快速扩张,逐渐更加重视实际产出和长期使用价值。
据国家数据局披露,Token 已成为连接技术供给与商业需求的「结算单位」。今年以来,有大模型企业仅用 20 天就超过了 2025 年全年收入。以 Token 为计费基础的新商业逻辑正在加速成形。
现在,我们会拿同一把尺子衡量所有算力产品:「高质量算力」。
高效率、可预期、可持续是高质量算力的核心逻辑,也是国产算力从性能追赶走向真正的产业竞争,必须回答的问题。
沿着这一思路,天数智芯正在尝试将云端 GPU、AI 软件栈与端侧产品连接起来:云端负责大规模 Token 生产,软件栈降低开发与适配成本、沉淀可复用能力,端侧则让智能真正进入更多物理场景。随着应用不断落地,真实场景中产生的新需求和反馈,又能反过来推动模型、软件和硬件持续迭代。
天数智芯将这种相互促进的机制称为「增强回路」。
当性能追赶逐渐成为基础,真正拉开差距的,将是能否把算力优势转化为应用价值,再让应用反过来推动技术进化。而国产算力下一阶段的发展方向,也将由此展开。
当客户既不因「国产」而宽容,也不因「国产」而犹豫,我们的算力行业,就真正成功了。
最后,天数智芯预告了下一代产品彤央 TY2000,标称算力达到 600T 的国产端侧算力时代即将到来!
文章来自于"机器之心",作者 "冷猫"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
