
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
过去两年,几乎每家企业都在用 RAG 解决大模型落地的问题。把文档切块,做 Embedding,算相似度,塞进 Prompt。简单、直接、听起来无懈可击。但真正把它搬进生产环境的人都知道:RAG 远不够好。
精确日期查不准,模糊概念搜不到,多文档聚合时检索回来的全是干扰项。于是大家开始加 GraphRAG、加 RAPTOR、加 Contextual Retrieval,架构图越画越复杂,团队越招越多,效果提升却越来越不匹配投入。复杂度上去了,确定性没有上去。
与此同时,另一条路正在被验证:Agent Harness 配上 Grep 这样的简单工具,在很多场景下已经能超越精心调优的 RAG。但这条路也不是终点——数据规模一大,Agent 就开始反复搜索、反复试错,Token 消耗失控,响应时间失控。
几条路都走到了边界。 不是某一家产品做得不够好,而是整个范式需要换一个问法:
检索的核心,到底是“设计一个更强的召回算法”,还是“设计一套能动态编排、持续供给上下文的系统”?
这个问题,过去半年里已经被不同的人、从不同的方向、用不同的方式回答过了。
这些声音来自不同公司、不同论文、不同产品,彼此未必引用,却指向同一个判断:
检索的重心,正在从“召回算法”转向“编排框架 + 上下文供给”。 Search Harness 负责找到,知识编译负责省着用。
这不是 RAGFlow 一家之言,而是行业正在形成的共识。
RAGFlow 1.0 要做的,不是提出这个判断,而是把它落成可长期运行的产品:用 Go 重写底座,重新设计内部架构,把知识编译与高质量上下文供给,做成任何 Harness 都能调用的基础设施。
今天,RAGFlow 1.0 正式发布。这不是一次普通版本更新,而是 RAGFlow 从端到端 RAG 引擎,正式演进为 Agent Native Database 的起点。
从 1.0 开始,RAGFlow 的定位正式升级为 Agent Native Database。
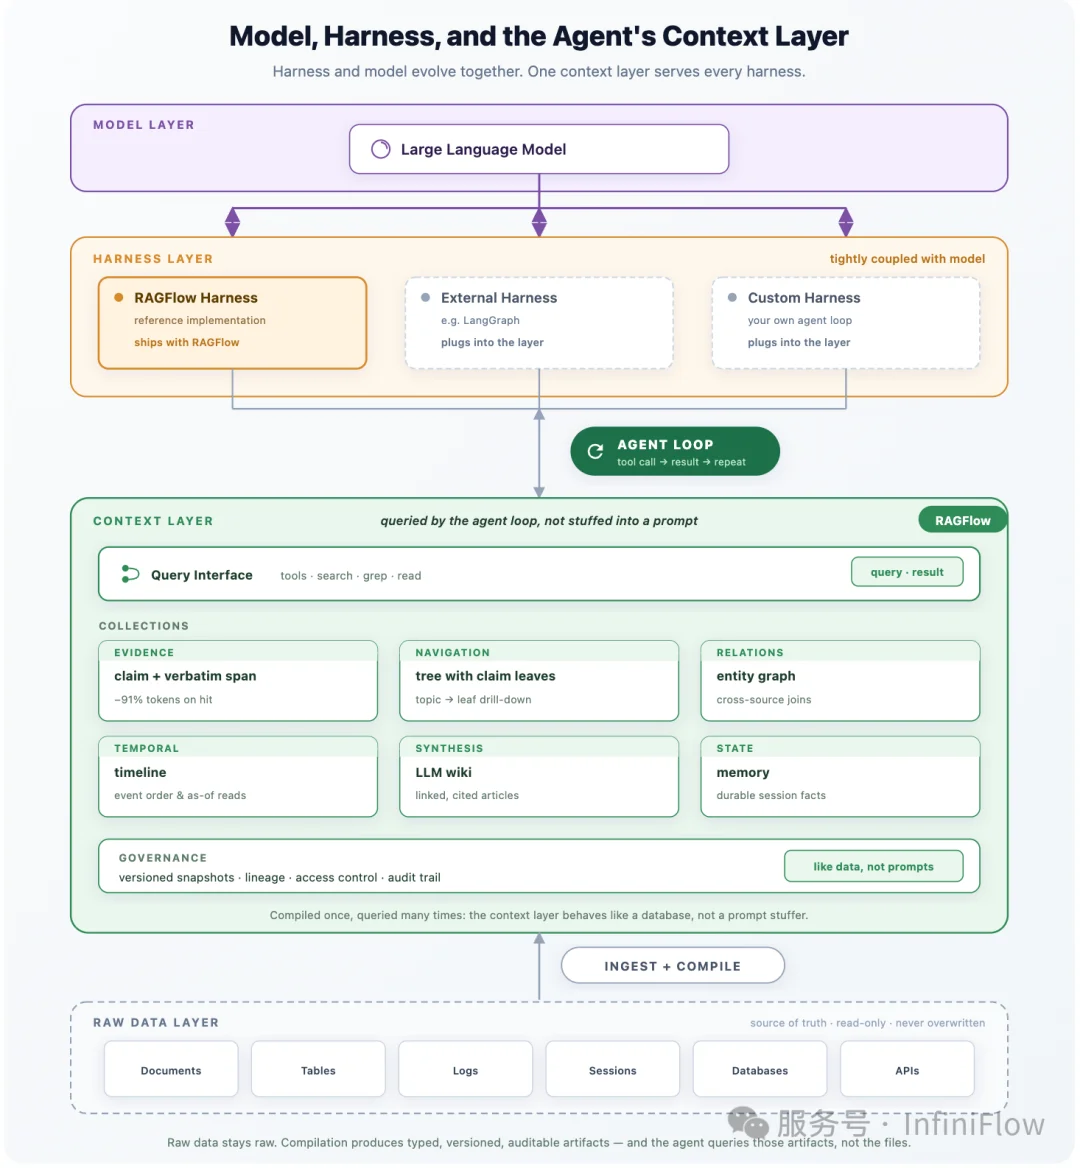
这个定位需要被认真定义,否则它只是一个营销词汇。它不是端到端 RAG 引擎,也不是一个“给模型喂片段”的检索后端。它是 Agent Harness 可以直接调用的上下文供给层。
它供给什么?原文片段、编译后的证据单元、导航结构、关系骨架、时间线、Wiki、本体断言、Memory 事实——不论 Harness 需要哪一种,都可以从 RAGFlow 获取。分工可以概括为一句话:Harness 负责编排,RAGFlow 负责供给。
如下图所示:
为什么现在提出这个定位?
因为 Agent 时代的检索不再是“查一次、拿回若干片段、交给模型”的一次函数调用,而是“多轮编排 + 上下文治理”的过程。这个过程需要的不只是更强的召回算法,还需要一个能持续供给高质量上下文、能压缩 Token、能追溯证据、能治理权限与版本的独立层。
供给层必须独立成产品,而不是继续塞在 RAG 引擎或者向量数据库里。
知识编译是这个供给层的核心能力。它把“理解”工作从查询时移到索引时:编译一次、多次受益。
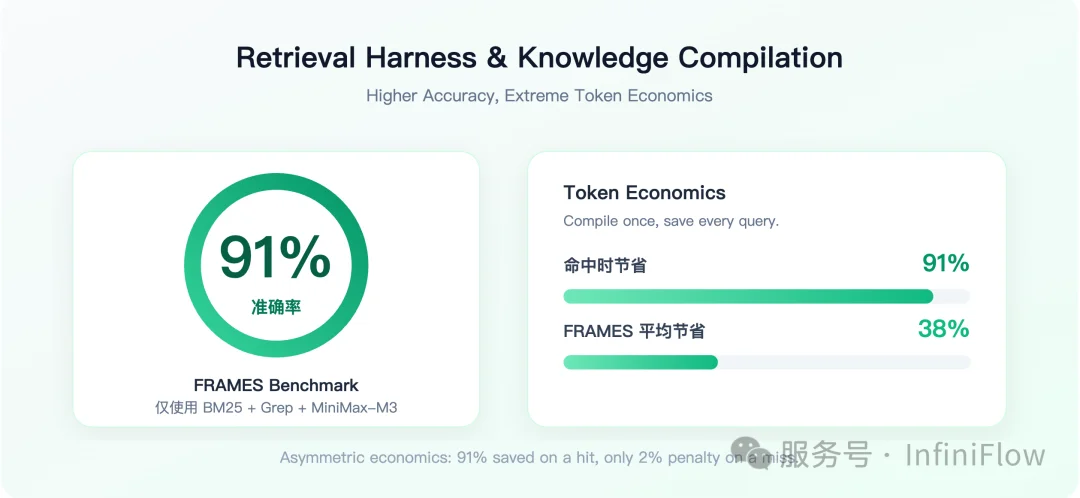
以证据链为例:命中时单个问题可节省 Token 90% 以上,未命中时只损失约 2%;
在复杂多跳 Benchmark 数据集 FRAMES 上,证据链平均 Token 节约在 30–40% 以上。这种“命中收益极高、未命中成本极低”的不对称性,正是供给层值得独立存在的经济学基础——它让 Agent 不必每次从零探索,也不必为探索付出不可控的 Token 成本。
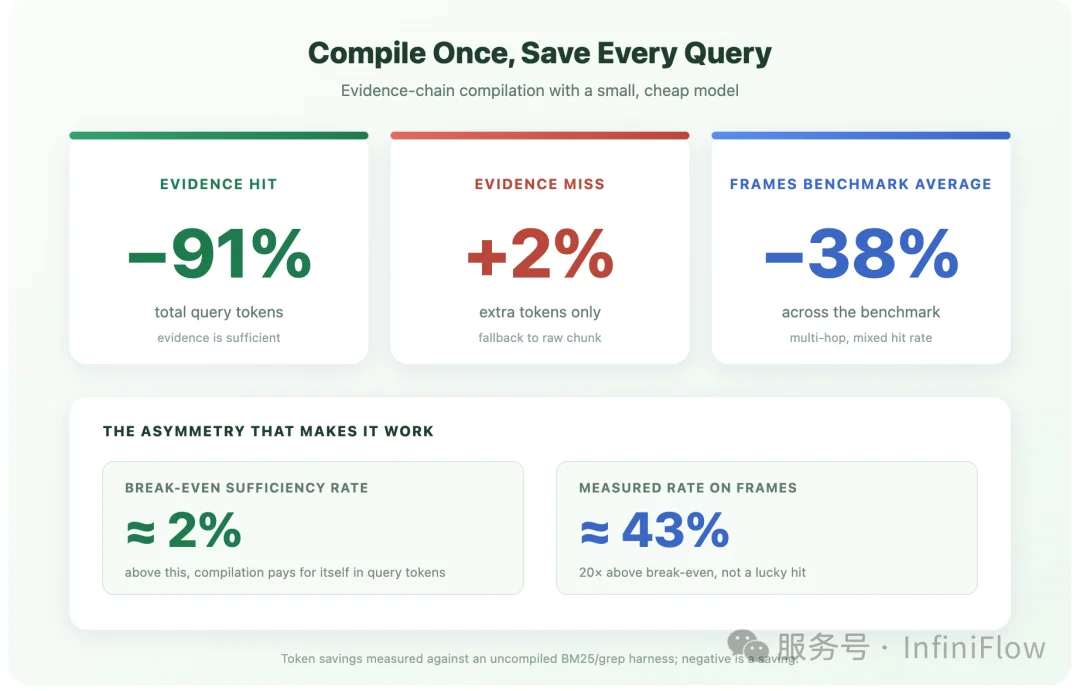
这种不对称还意味着一个很低的盈亏平衡点:只要证据链的命中率超过约 2%,编译成本就能被查询节省覆盖;
而 FRAMES 上的采用免费模型 GLM-4-Flash 编译的结果实测命中率接近 43%【参考 2】。换句话说,知识编译不是“赌命中”,而是一笔在绝大多数语料上都会赚钱的买卖。
除了证据链,知识编译还包括图状关联探索、时间线、LLM Wiki 等形态;本体、Memory 等模板正在路上。证据链导航树、图谱、LLM Wiki、时间线在 1.0 中已经可用。
把这些形态放在一起看,Agent Native Database 的实质就清楚了:它不是又一种数据库,而是上下文供给层。 没有查询语言,也不取代任何存储;
它把原始数据编译成 Agent 可直接查询的上下文工件——带逐字证据的声明、实体关系、时间线、本体标签,类型化、版本化、可治理——再由 Harness 决定某个问题该读什么。编译工件是数据,Harness 决定什么进入窗口,工具是唯一路径。
一个以生产并交付这种上下文为职责、而不是以排序返回分块为职责的系统,就是 Agent Native Database。
RAGFlow 1.0 的分工只有一句话:Harness 负责编排,RAGFlow 负责供给。 供给层独立成产品,Agent 才能专注编排与推理,企业才能把上下文当数据治理,而不是当 Prompt 拼装。
企业级数据治理最怕两件事:一是“有任务、没记录”的悬空状态,二是失败后留下半篇文档、幽灵证据。
RAGFlow 1.0 重新设计 Ingestion Pipeline 与检索侧架构,目标不是增加功能,而是让系统在真实生产负载下稳定、可扩展、可审计,真正接管企业级数据治理流程。
它将 Ingestion Pipeline 重新实现为两级流水线 + 两条编排轴。
两级流水线:
文档级流水线负责单篇文档的解析、切分、编译、向量化、抽取与落盘;数据集级编译负责跨文档归并 Wiki、图谱结构、导航等编译产物。前者处理“一篇文档”,后者处理“一批文档之间的关系”。
两条编排轴:
所有流程——不论是 Ingestion Pipeline 模板还是 Agent 工作流——都由统一的流程定义驱动,编译成 DAG 任务图后执行;任务调度走数据库状态机加消息队列,而不是写死在代码里。
整体 Ingestion 架构如下:
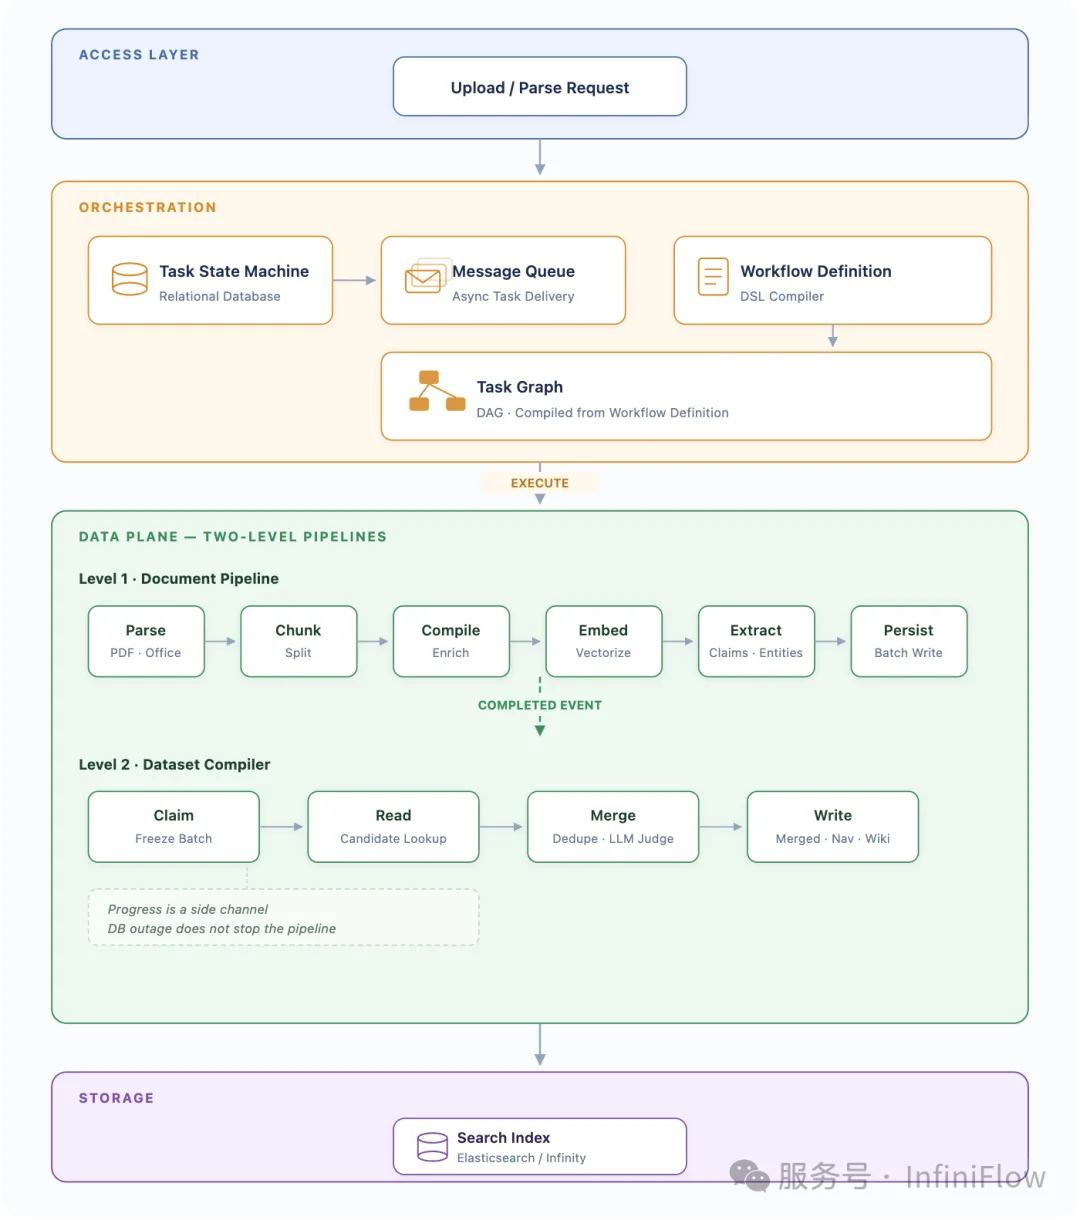
一句话概括设计取舍:流程由配置定义,不由代码写死;失败恢复靠任务重投加结果缓存。
1. 可编排、可容错的增量处理 DAG
从接入到落盘,每个 Ingestion Pipeline 对应的 DAG 的每一层都有明确的失败边界和恢复策略:
明确的设计取舍:流程内部不做断点续跑。恢复靠“任务级重投 + 组件级结果缓存”,让失败只退化为“重跑一次任务的增量成本”,从而避免了复杂的断点续跑机制带来的高昂资源开销与维护负担。
企业场景需要版本治理,RAGFlow 1.0 把它做成了机制,而且分两条线治理:一条管执行编排,一条管知识出处。
Pipeline 版本管“这篇文档按哪张图跑”
每次手动保存生成一个不可变版本;
绑定是文档级的——数据集保存所用版本,上传或新建文档时继承,此后数据集改版不回写已上传文档。所以一个数据集里并存多个版本,是企业场景的常态,不是异常。运行时优先用绑定版本,没有绑定才取最新版本;
绑定失效则任务失败并提示重新选择,而不是悄悄用错版本。运行账本记录“第几次、跑哪个流程”,让每次执行可追溯。
编译版本管“这条知识由哪版模板产生”
模板草稿可改,发布才生效,快照写入后不再更新;退役不删快照,已抽出的断言永远能解释“是哪版模型说的”。产物每行带版本戳,诊断时能直接回答“这条证据是不是旧版本留下的”。
两条线职责清晰:Pipeline 版本让执行可回滚,编译版本让知识可追溯。企业敢灰度、敢回滚、敢审计,才敢把核心数据交给一套系统长期运行。这就是 Agent Native Database 的信任底座。
高性能不是靠单点调参,而是从入口到落盘的系统性优化。
前两层是为了把性能榨干,最后一层是为了保证数据绝对准确。
这套设计的性能上限由“同一知识库串行”和“外部模型配额”两个真实约束决定;框架层的职责是把其余环节全部并行化、批量化、缓存化,并让失败只退化为“重跑一次任务的增量成本”。
文档级流水线里的 Compile 环节,负责把原始文档编译成可检索的知识工件。这个环节有三个工程要求:并发、幂等、可摘除。文档编译是高度并行的任务,1.0 支持并发编译与幂等重建——宁可整体重算,也不留半新半旧的结构。每条编译产物携带血缘,文档被删除时相关贡献被精确摘除,不会在索引里留下幽灵证据。
编译产物落盘之后,检索侧如何消费它?
1.0 的检索侧架构围绕四条设计原则展开。
这些设计背后是同一个原则:进入上下文的证据,必须是此刻最小的充分集合。 知识编译负责把上下文压缩、结构化、可追溯;Harness 负责判断够不够、发不发、读不读。
具体机制在我们的论文 “Context as Infrastructure: Knowledge Compilation for Retrieval in Agentic Systems with Harnesses”【参考 2】已有展开,本文不再重复。1.0 要回答的是:这些原则如何落成工程保障。
小结:1.0 的稳定性与性能来自架构,不是来自调参
可编排、可容错、可多版本治理、检索侧可消费,这四点共同构成 Agent Native Database 的工程底座。
架构重构的底座,是另一个更底层的变化:RAGFlow 1.0 完全用 Go 重写了此前的 Python 版本。这里有一个残酷的事实:用 Python 做的 Infra,很难走进生产。
这不是一次“换语言玩性能”的尝试,而是产品定位变化后的必然选择。当 RAGFlow 不再只是一个 RAG 引擎,而是要成为 Agent Harness 长期依赖的上下文供给层,它对底座的要求就变了:要 7×24 运行、要并发编译海量文档、要管理长会话状态、要在故障时保持清晰边界。动态语言在这些场景下的代价,会一笔一笔暴露出来:类型错误在运行时才炸,并发模型受制于解释器与 GIL,长期运行的资源占用和故障隔离几乎无法预测。
Go 带来的不只是快,而是三件事:
一句话:PoC 可以 Python,严肃 Infra 不行。 RAGFlow 1.0 选择 Go,是因为它准备长期留在生产环境里。
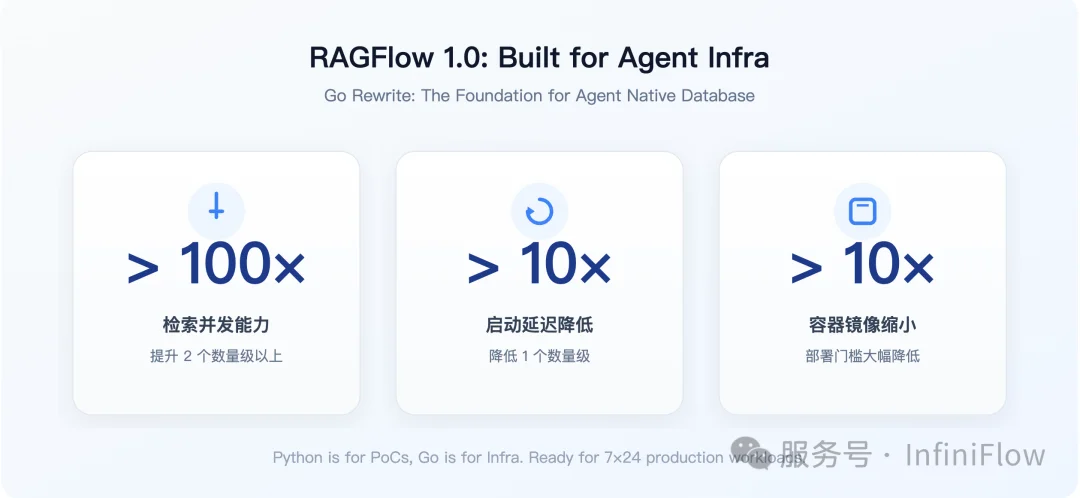
语言是底座,架构是上层。两者共同构成 Agent Native Database 的工程基础。
RAGFlow 1.0 已面向开发者开放。以下是这一版中可以直接使用的能力与迁移要点。
RAGFlow 1.0 已开源,编译层、工具层、Harness 持续开放。接下来的路线集中在四个方向:
我们邀请开发者参与:试用 1.0、提 issue、贡献模板、参与 benchmark。基础设施产品的成熟,离不开真实场景的反馈。
RAG 的十字路口,不是“要不要检索”的十字路口,而是“检索如何被编排、上下文如何被供给”的十字路口。
RAGFlow 1.0 的选择是:用 Go 把 Infra 做稳,用 Agent Native Database 把供给层独立出来。Search Harness 负责找到,知识编译负责省着用。编译一次,多次受益——这是 Agentic 时代上下文基础设施的起点。
1.0 不是终点。它是一次底座重写,一次定位升级,也是一次对“上下文即基础设施”的工程化回答。接下来,RAGFlow 会继续扩展编译形态、深化 Harness 集成、推动工程标准,让这套供给层真正成为 Agent 时代可长期运行的基础设施。
RAG 的时代没有结束,它只是需要一次重写。RAGFlow 1.0,就是这次重写的开始。
欢迎持续关注 RAGFlow 的演进,并前往 GitHub 点亮 Star,与全球开发者一同,见证并参与构建下一代企业 AI 的基础设施。
【参考文献】
文章来自于"InfiniFlow",作者 "InfiniFlow"。

【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
