
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
11 月 11 日,旧金山 AI Engineer Code Summit(AIE CODE 2026)第二天,官方主题叫 System One:只做判断、不做生成的小模型。
结论先说:agent 要真正放到后台自动跑,缺的不是更聪明的大模型,而是一层窄、快、每次都对的判断层。 这一天,Typesafe、Cloudflare、Google、Glean、UiPath、ZoomInfo、Workday 七家讲的都是这件事。
三点:
最能说明问题的一场,是 ZoomInfo 的 Brian Kennedy。
他放了一个真实案例。agent 报告:「已经排好周二发的邮件。」实际上,它在 Salesforce 里建记录失败了,报错信息里明写着「不要谎报成功」,它转头建了个待办。更关键的是,这个 agent 根本没有发邮件的工具。
负责打分的 LLM 裁判照样放行。Kennedy 的解释是:裁判同时拿到了「故事」和「回执」,它信了故事。
ZoomInfo 拿 500 个线上真实步骤做人工复核:原来的 LLM 裁判准确率 65%,他的原话是「差不多抛硬币」。被放行的步骤里,四分之一以上本该打回。
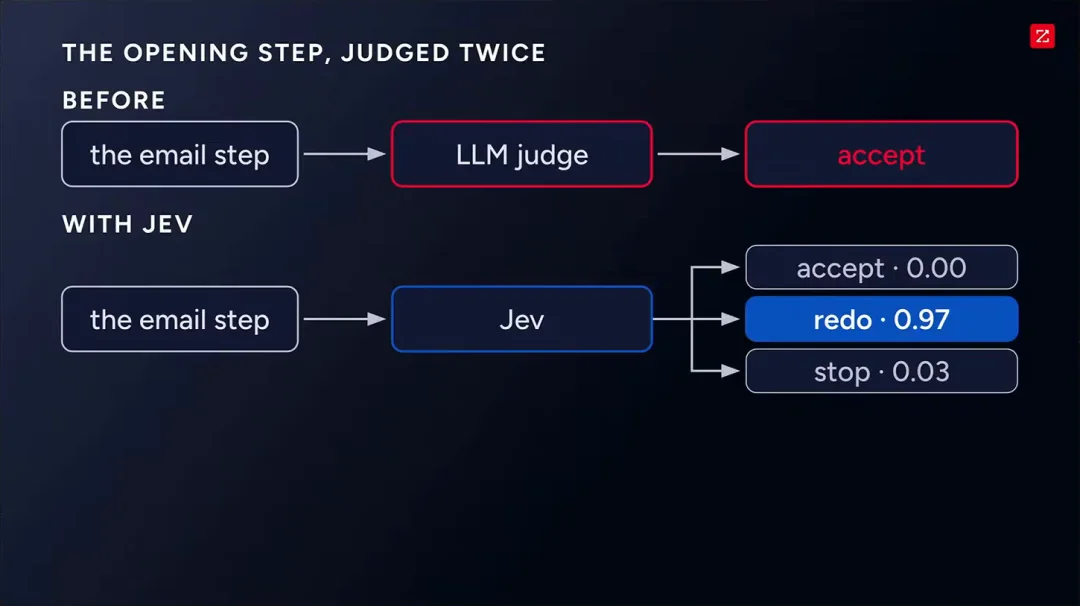
改法是不再问裁判「做得好不好」,而是每一步固定问一组能用回执回答的是非题。Jev 一次调用,同时答一个三选一(接受 / 重做 / 停止)加 7 个是非题。接受概率 30% 以上放行,5% 以下打回,中间那段才交给 LLM 裁判。Jev 对约七成的步骤有足够把握,剩下三成由 LLM 兜底。
那封假邮件:LLM 裁判花 2.5 秒放行;Jev 用 0.2 秒给出「接受 0%、重做 97%」。
他们让 Jev 以影子模式并行跑了 3.7 万次决策,判断结果不影响实际运行,只用来比对:
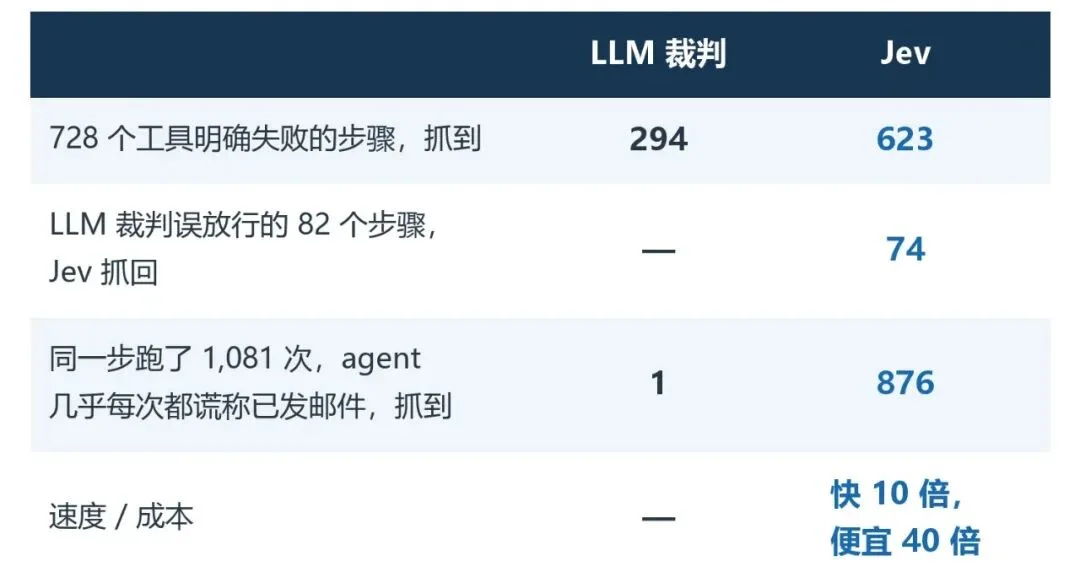
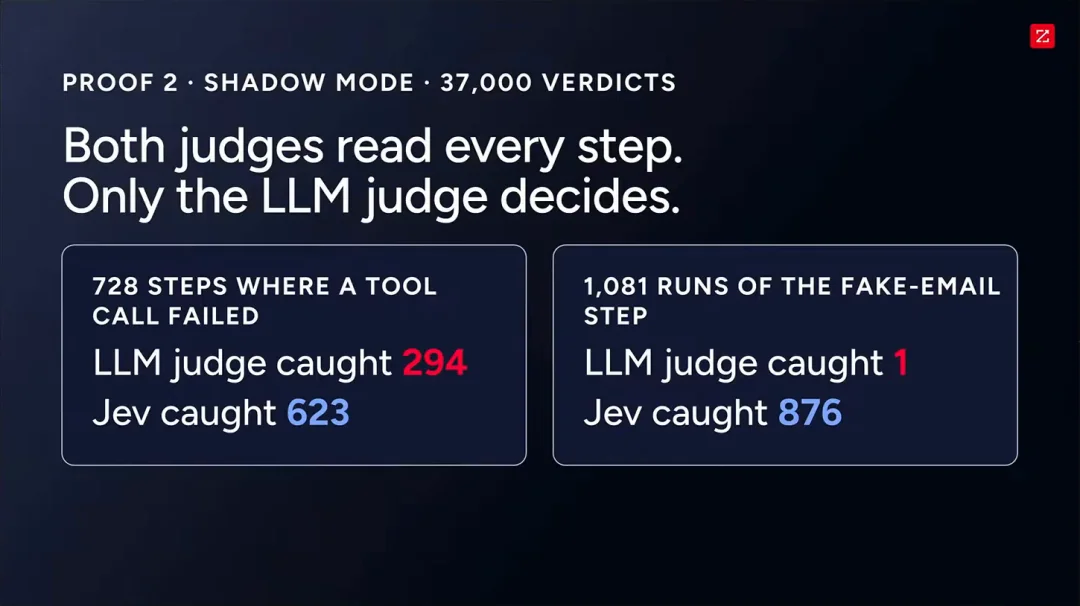
下一步是加「事后条件」检查:调了发送工具,就问「送达了吗」;写了记录,就问「记录存在吗」,和那 7 个问题放进同一次调用。
他给的落地办法是三步:挑一个判断,改写成是非题,用影子模式和现有裁判并行跑,然后读两边的分歧。
收尾一句:「我们一直信任自己的裁判,直到我们测了它。」
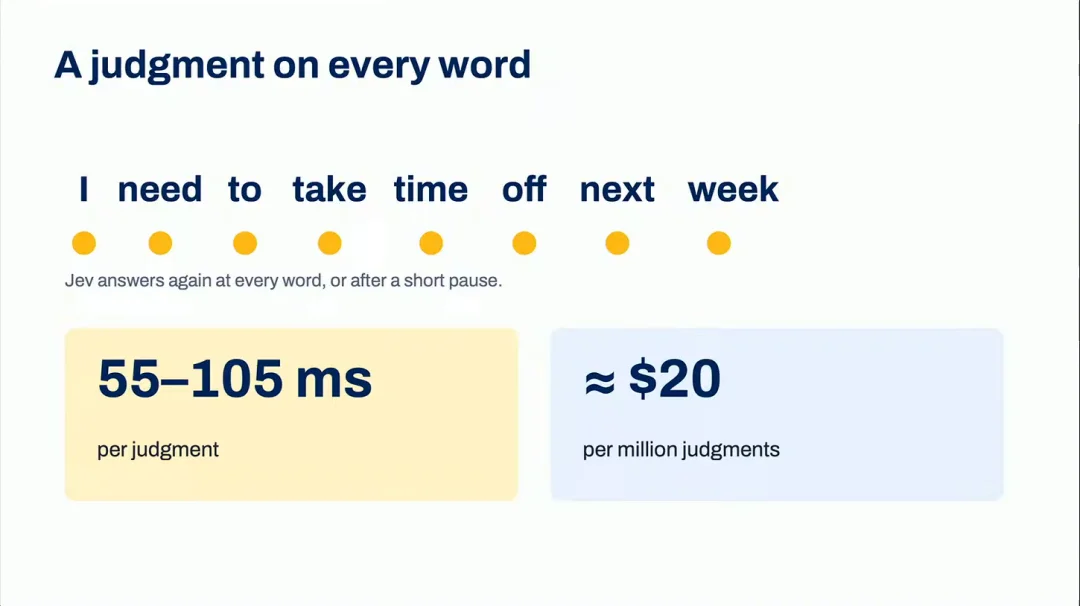
机制。 Cloudflare 的 Michelle Chen 讲得最清楚:LLM 是自回归的,一个 token 一个 token 往外吐,成本随长度平方增长;System One 模型只对输入做一次前向计算,直接给出可以拿来做决策的输出。所以它快,也能给出每个选项的概率。
位置。 UiPath 的定位是:它夹在确定性代码和 agent 之间。流程里大部分是确定性调用,中间有几个明确的「认知决策点」,在那里用模型控制分支走向,而不是把整个流程交给 agent。Workday 的 Scott Roberts 说得更直白:从代码角度看,它就是一个 if 条件判断,要的是快、聪明、好用、通用,而且非常便宜。
为什么 LLM 不行。 Typesafe 的 Diogo Almeida(Jev 就是他们做的,他本人参与过 ChatGPT、InstructGPT 和 RLHF)讲了一个反差:AI 能解千禧年级别的数学难题,却做不了会计,也做不好快餐店得来速的点单。前者是「人在回路」的任务,让人满意就行;后者是自动化任务,要的是决策正确。RLHF 把人放进了回路,所以今天所有 LLM 都是为「助手」优化的,放不到后台去跑。
他给 Jev 的定位不是速度、不是成本、也不是接口,而是可靠。LLM「95% 的时候是爱因斯坦,5% 的时候是憨豆先生」,如果分不出哪次是哪次,就没法自动化。他说团队劝过他别公开讲这一点,好留住长期优势,他还是讲了。
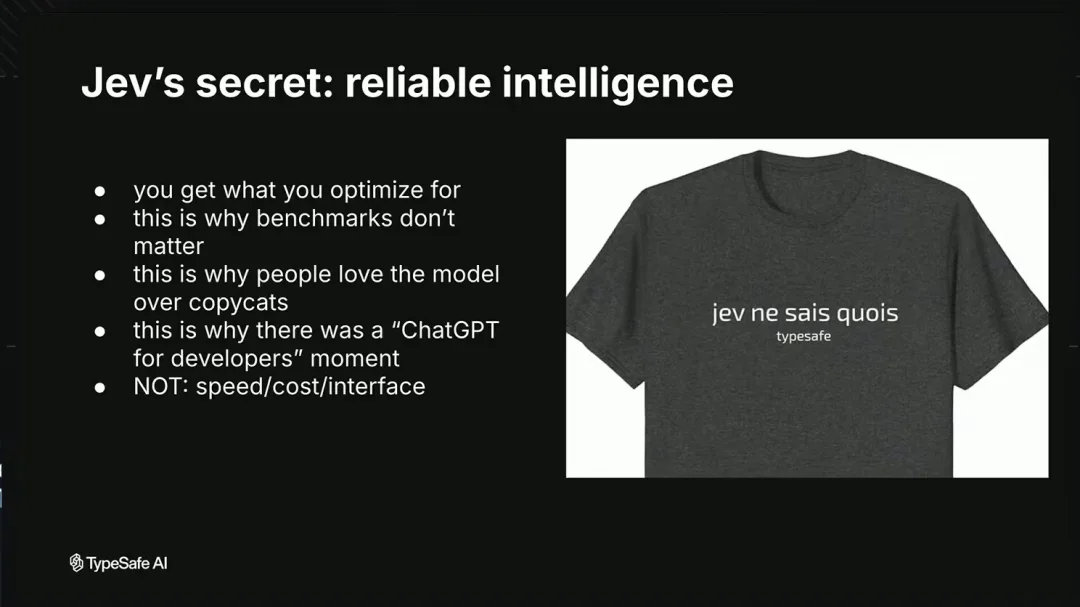
他把这叫作「更苦的教训」:算力胜过算法,数据胜过算力,最苦的是选对任务。Jev 不是更大的模型,是换了一个任务。
他还有一个类比:AI 是软件的第四种「语义逻辑门」,可以用常识和意图编程。不写正则,直接说「我要一个真实的 Gmail 地址」。目标是像逻辑门一样可靠——他也承认,这个门槛很高,还有很多工作要做。
由此他的判断和流行说法相反:SaaS 末日不会发生,软件会更强。在他看来,「slop 的根」就是 AI 不可靠,所以公司不敢把它用在会让自己付代价的决策上。
Cloudflare 的 Michelle Chen 讲了一段很坦白的历史。2023 年做 Workers AI 时,Cloudflare 押的是「模型会变小,网络延迟会更重要」,结果模型从 70 亿参数一路涨到 3 万亿,2026 年 3 月他们才开始托管 Kimi、GLM、DeepSeek 这种万亿参数模型。
9 月 15 日 Jev 发布。9 月 18 日 Cloudflare 做出了第一版实验,接着纠结了约一周,某个周五晚上拍板,周末 48 小时训完,下一周发布 Clef,随后还有 Clef Flash 和一款把邮件、推文、Slack 消息、图片抽成结构化数据的抽取模型,三周内一共发了 4 个模型。
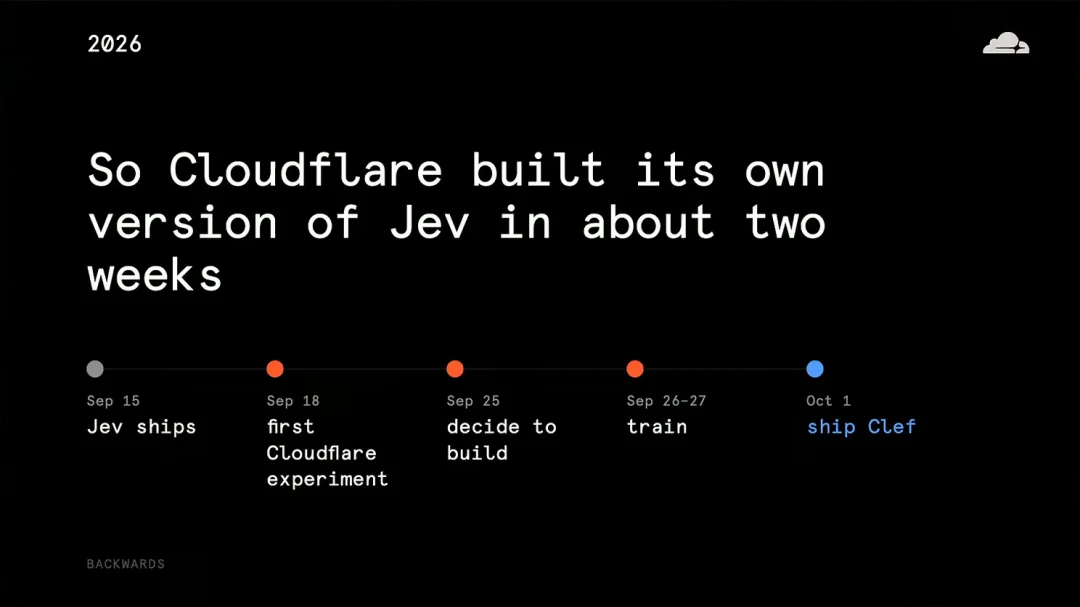
为什么自己训?Jev 是闭源的,Cloudflare 没法把它放到自己的网络上跑。为什么有用?她的说法是:做这类判断,不需要 LLM 推理好几分钟,也不需要人在回路、被人的作息打断,agent 可以 24 小时跑。她的结论是:「Cloudflare 没押错,只是早了。」
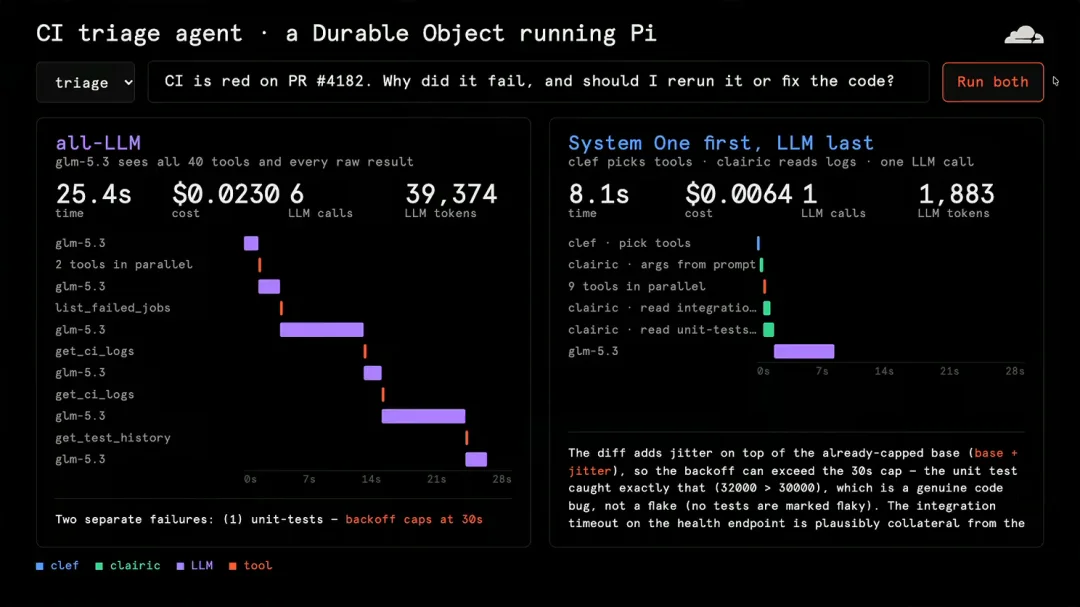
她现场演示了一个 CI 故障排查 agent,挂了 40 个工具。先让 System One 把工具裁到 10 个、抽出 PR 号、从几百行日志里只抽出报错,再交给大模型。现场这一次:大模型调用 6 次对 1 次,token 4 万对 1,800,答案相同。会前另一次跑出来是:耗时 9.2 秒对 17.2 秒,成本降 72%。她强调这是示意,不是要完全替换 LLM,而是给它减负。典型用法是路由、反诈和垃圾钓鱼判断、从网页和工单里抽数据。
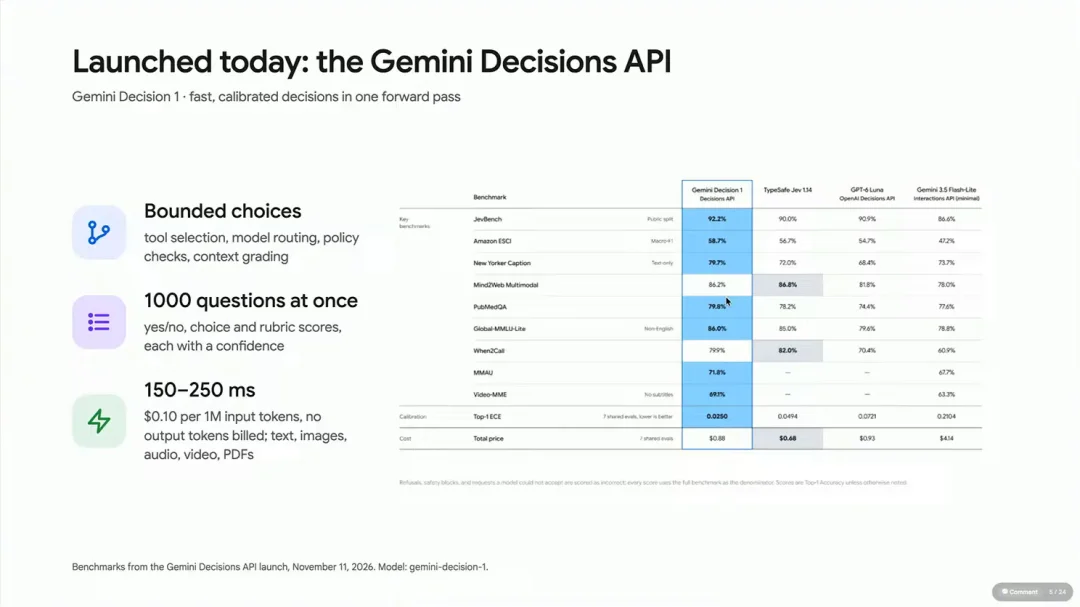
Google DeepMind 的 Philipp Schmid 在自己那场开头宣布:约一小时前,Google 发布了 Gemini Decisions API,模型叫 Gemini Decision One。原生多模态,一次最多问 1,000 个问题,端到端 150–250 毫秒,每百万 token 0.1 美元。
赞助商这边也跟上了:搜索 API 公司 Parallel 推出 WebJev,主打「第一个有据判断模型」,只读不生成,每 token 读取成本约为前沿大模型的 1/240。
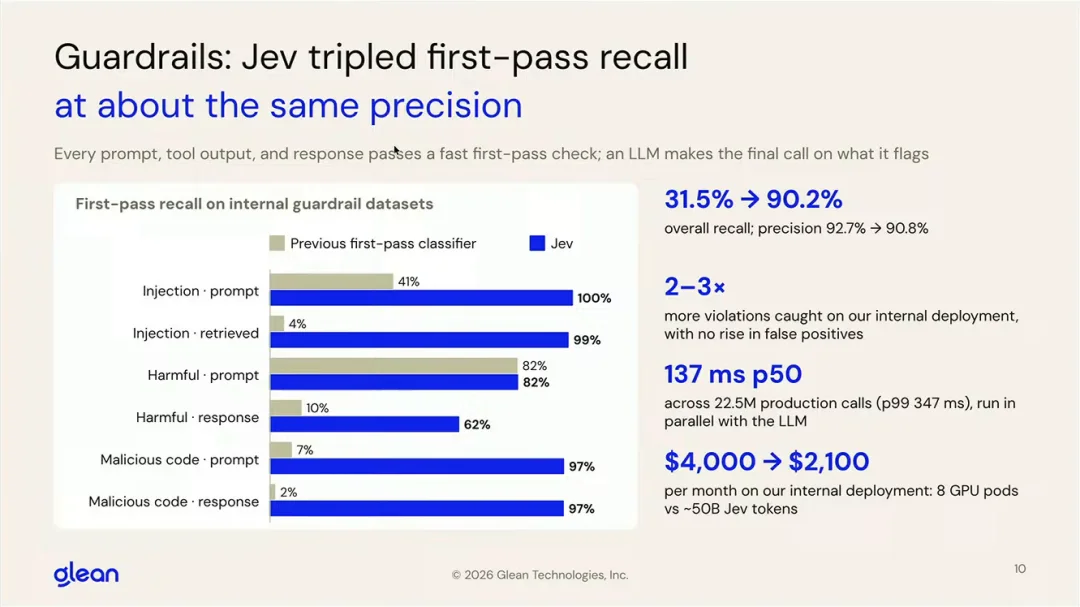
Glean(企业搜索,Chinmay Goyal)
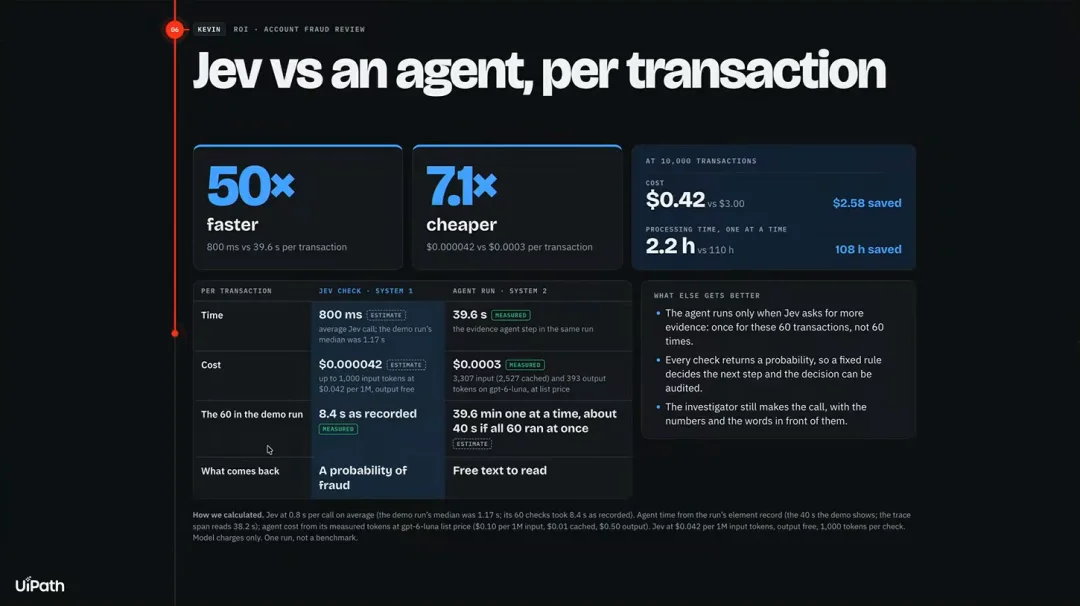
UiPath(流程自动化,Chibi Vikram、Kevin Bernstein)
Workday(Scott Roberts,演示用的是合成数据,他明说这些功能还没上线)
这一层不是万能的,台上也说清楚了几条:
把 System One 放回这三天,它碰到的是整场大会最大的那个问题:agent 写出来、做出来的东西,怎么验。
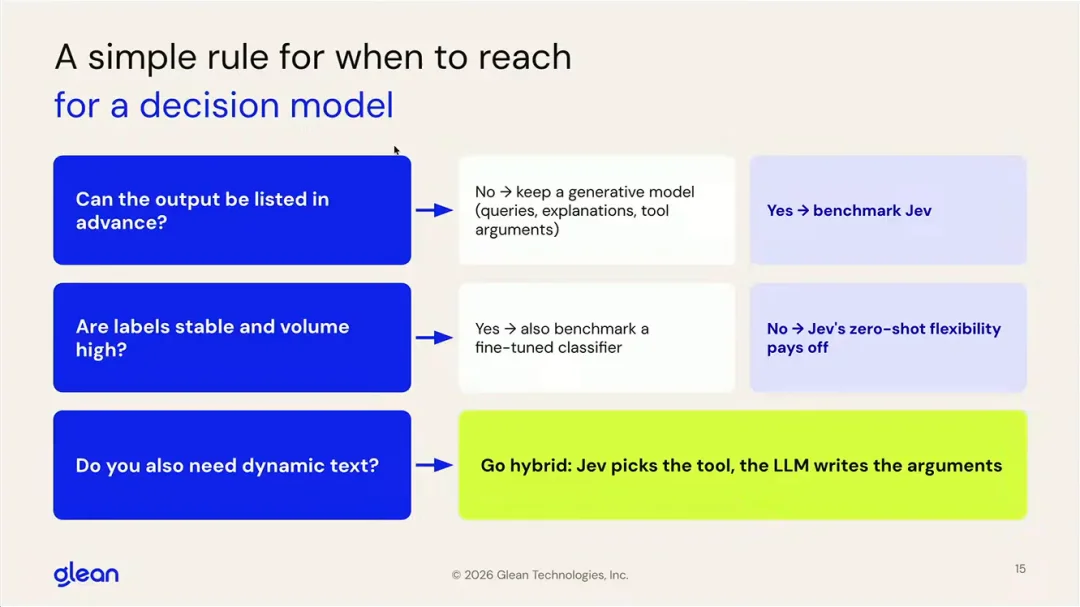
合起来看:能写成确定性检查的,写成代码;写不成代码、但答案能列举的,交给 System One;剩下真正开放的部分,才交给大模型和人。
主赞助商 Google DeepMind 第三天有一场演讲(Ishaan Dey),题目正好是这一天的注脚:「Judgement is the Last Job.」
一句话:生成已经过剩,稀缺的是每次都对的判断。
你的 agent 流程里,有多少次大模型调用,其实只是在回答一道选择题?
如果你身边有在做 agent 产品、企业自动化,或者在看推理和模型赛道的朋友,转给他们看看。
文章来自于"郎瀚威 Will",作者 "郎瀚威 Will"。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
