
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
创造一个世界不难,难的是让这个世界「听话」。
不久前,Google DeepMind 发布了 Genie 4,展示了交互式世界模型的最新进展。用户可以通过键盘或鼠标控制角色探索世界,还能通过提示词改变环境,不少人看了直呼「游戏引擎已死」。
但真上手用了才知道,实际体验和预期还有一定的差距。
「听话」,意味着至少需要具备两种能力:一是控制精度,用户发出的操作指令能够得到准确响应;二是时序一致性,世界在持续变化的同时,仍然能够保持物体的身份、外观和状态稳定。
简单来说,就是该变的变,不该变的不变。
当 AI 已经能够生成一个可探索的世界,如何既实现精准控制,又让这个世界在持续交互中保持稳定,成为世界模型面临的一项重要挑战。
近日,蚂蚁集团,西湖大学和浙江大学联合发布 Code World Model 2.0(CWM 2.0)。其核心视觉引擎 Invoker-Render 能够接收结构化 Proxy,将场景布局、物体运动和镜头变化转化为连续的高保真画面。
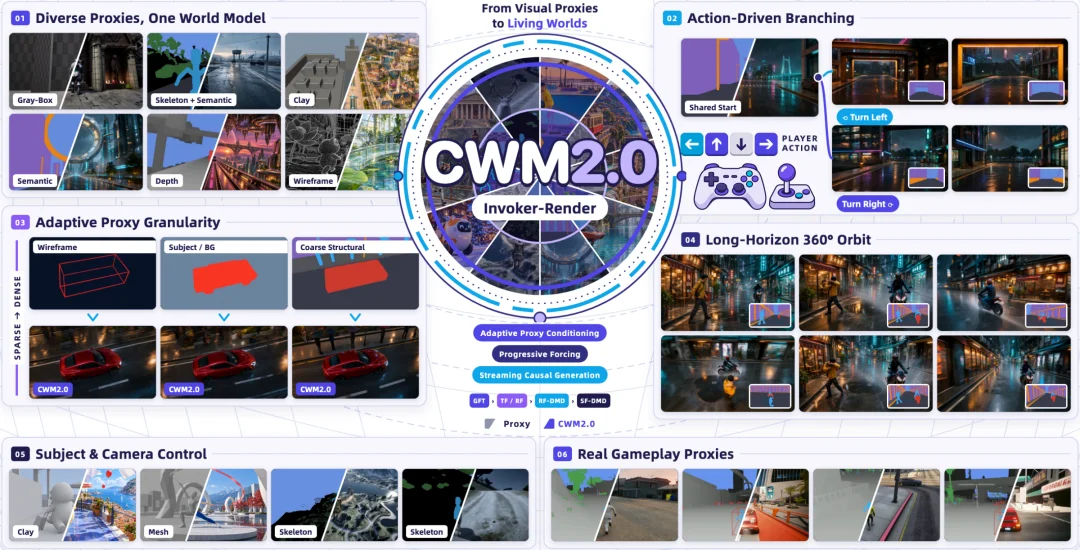
团队的一段赛车演示,充分展现了这种控制方式的优势。
输入端是低模赛车 Proxy,右下角还展示了真实的手柄操作。随着测试者拨动摇杆,Proxy 中的车辆改变方向,主画面中的白色赛车也随之同步转向。
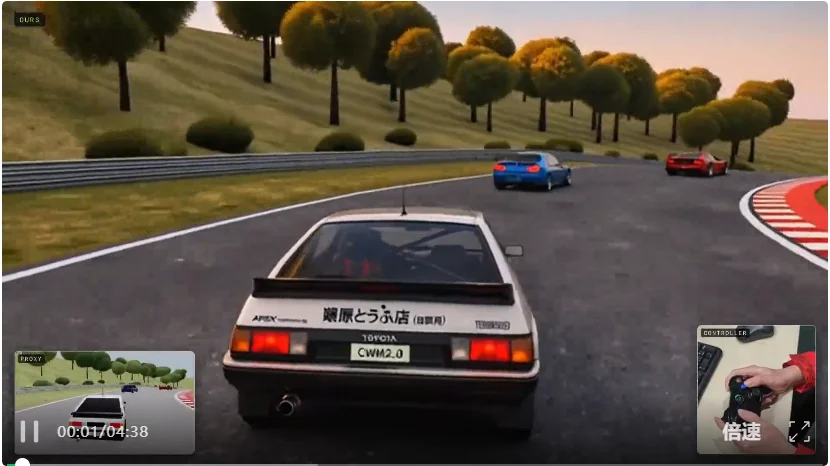
更重要的是,团队还展示了一段 30 分钟的赛车演示,没有任何中途切镜或重置,展现了模型在长时间连续生成中保持画面稳定性和主体一致性的能力。
几根简单的线框究竟如何驱动一个逼真的世界?又如何让这个世界在连续半小时的生成中,始终保持物体外观和场景结构的一致性?
CWM 2.0 给出的答案是 Invoker-Render。
这套生成式渲染引擎既能理解从简单几何到精细骨架等不同粒度的 Proxy,实现对场景、物体和镜头的精准控制,也通过 ProForcing 训练方法提升长时流式生成的稳定性。
目前,一类主流的交互式世界模型采用端到端生成路线:用户输入操作,模型直接预测并生成后续画面,无需单独搭建复杂的世界程序。
但随着交互越来越复杂,模型需要同时承担两类任务:既要像物理引擎一样维护物体状态、运动轨迹和交互规则,又要像图形渲染器一样合成逼真的材质、纹理和光照。这种设计增加了精准控制和修改世界规则的难度。
另一种思路,是将世界状态管理与视觉生成分开。
在这种架构中,代码负责定义物体、运动规则和摄影机路径,并将这些信息转换为结构化 Proxy,交给生成模型完成视觉呈现。代码提供明确、可修改的控制条件,生成模型则负责补充材质、光影和局部细节,实现世界状态与视觉表现的分工。
早在 CWM 1.0 中,团队就尝试将世界状态管理交给代码,将视觉呈现交给生成模型。CWM 2.0 则在此基础上,进一步完善了生成式渲染环节。
在 MiniMax-H3 基座上,团队构建了两种互补的 Invoker-Render 模型,共享结构 Proxy、外观参考图和文本条件这一套输入接口。
一种是双向创作模型,能够读取完整的 Proxy 序列,利用前后文信息生成画面,适合离线视频创作和复杂运镜调整。比如,创作者可以预先规划一段完整的镜头运动,再让模型根据结构条件生成对应画面。
另一种是因果四步流式模型,它无法提前看到尚未发生的操作,只能逐块接收新的 Proxy,结合此前生成的画面,持续生成后续内容。这种方式更适合实时交互。
但要让这套分工真正发挥作用,下游渲染器还需要解决两个问题:理解不同精度的结构输入,并在连续生成中保持画面稳定。
Proxy 是连接上游世界程序与下游生成模型的关键。它可以记录场景布局、物体位置、朝向、运动轨迹和摄影机变化,但不需要完整包含最终画面的材质、纹理和光照信息。
问题在于,不同交互场景需要的结构信息并不相同。
比如,在一个赛车场景中,如果只需要控制车辆沿着道路行驶,几个简单的三维框就可以描述汽车的位置和朝向。这样的 Proxy 构建成本低、传输也更加轻量。
但如果场景换成人物格斗,仅仅知道人物整体移动到哪里就不够了。模型还需要知道手臂、腿部和身体各个关节如何运动,才能准确还原出对应的动作。
如何让同一个模型同时理解粗略结构和精细约束?
Invoker-Render 的解决方案,是将不同粒度的结构控制能力统一到同一套模型中。
五类 Proxy,一套统一的生成模型
具体来说,Invoker-Render 支持五类结构表示:
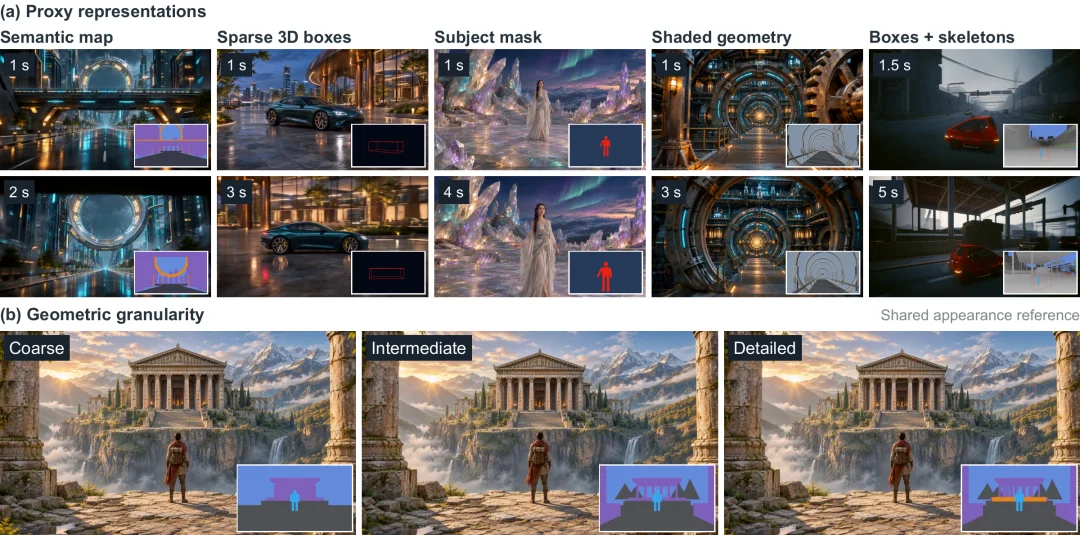
Invoker-Render 支持的五类 Proxy 表示,以及同一场景下从粗略到精细的几何控制示例。
这除了支持不同类型的 Proxy,Invoker-Render 还能够适应同一种表示内部的不同几何精度。
对于简单的人体结构,模型可以自行补全迈步、摆臂等局部动作;当输入更精细的骨架信息时,模型则能够遵循具体的关节姿态,实现更严格的动作控制。
为训练模型理解不同精度的结构输入,团队构建了约 200 小时的多粒度对齐数据,其中约 150 小时来自自采的三维交互和驾驶序列,其余约 50 小时来自 OmniWorld-Game、Magpie、CARLA、Virtual KITTI 2 等公开数据集。
团队通过场景重建和物体运动恢复,从同一场景中生成不同精度的 Proxy,并与对应的真实视频配对,让模型学习不同结构约束下的画面生成。
同一段事件,改变镜头就能改变画面
除了物体和动作,摄影机本身也是世界模型需要控制的重要部分。
在一组海岸隧道追逐的演示中,同一个场景和事件可以对应不同的摄影机运动路线。模型根据输入的 Proxy,分别生成不同视角下的连续画面。
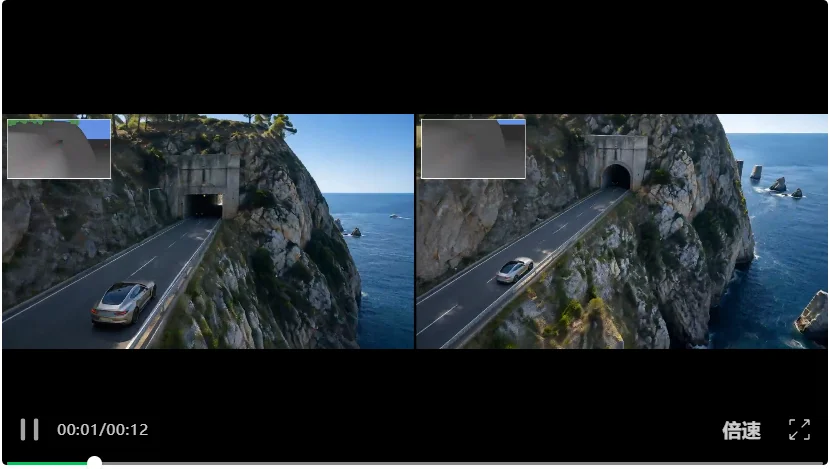
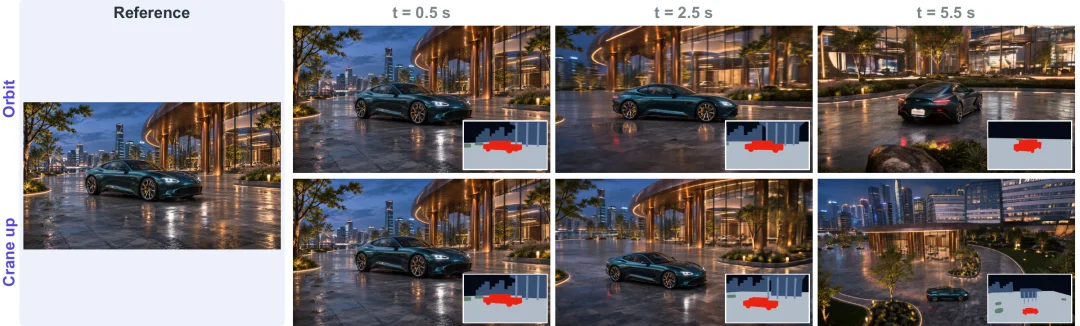
同一场景下的不同摄影机路径示例,分别展示 Orbit 环绕拍摄与 Crane Up 升降拍摄,体现模型对摄影机运动的控制能力。
因此,Proxy 不仅能够描述场景和物体,还能明确规定主体运动与摄影机路径,为镜头、动作和场景布局提供更精确的控制。
如果说多粒度 Proxy 解决的是「如何控制」,那么 ProForcing 要解决的就是「如何持续生成」。
实时流式生成与普通视频生成有一个重要区别:模型无法提前看到完整的视频内容,而是需要不断接收新的输入,逐块生成后续画面。
每一块生成完成后,都会成为下一块的历史上下文。问题也随之出现:如果前面的画面已经产生了一些误差,后续生成可能继续继承这些问题。
例如,最开始生成的红色汽车可能只有轻微的颜色偏移,但随着模型不断读取自己生成的历史,颜色变化可能逐渐累积,最终变成另一种颜色。纹理、光照和物体结构也可能发生类似的变化。
要解决这个问题,模型不仅需要学会快速生成,还必须学会在自身生成的历史存在误差时,继续维持画面质量。
ProForcing:把长时生成拆成三个训练阶段
为此,团队提出了 Progressive Forcing(ProForcing)渐进式训练方法,将因果适应、少步蒸馏和长序列自生成训练拆分为三个阶段。
第一阶段结合 Teacher Forcing(TF)和 Resampling Forcing(RF):前者使用真实视频历史作为上下文,后者则引入一定程度的重建误差,让模型逐渐适应不完美的历史信息。
第二阶段,通过 RF-DMD 将生成过程蒸馏为四步,并结合 GAN 对抗监督改善少步生成容易出现的细节损失和画面过度平滑问题。
第三阶段通过 SF-DMD(Self-Forcing DMD),让模型在自身连续生成的历史上继续训练。同时,团队将学生模型、Fake Score 模型、判别器及相应的优化器状态和 EMA 权重一并延续到这一阶段,以保持训练稳定性。
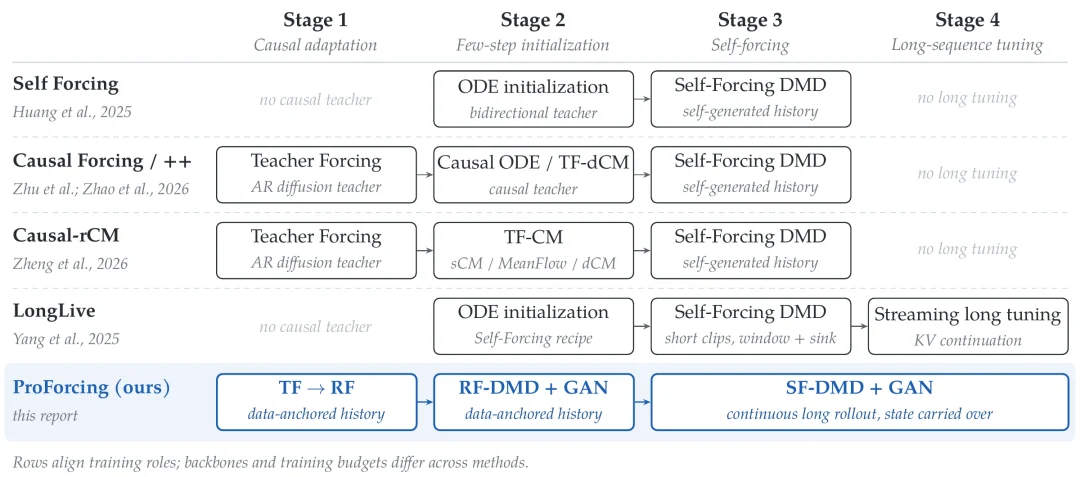
不同流式生成模型的训练流程对比。ProForcing 通过 TF→RF、RF-DMD+GAN 和 SF-DMD+GAN,逐步完成因果适应、少步生成蒸馏与长序列自生成训练。
30 分钟一镜到底,展示长时稳定性
当我们再回看开头的赛车演示,车辆持续沿着赛道行驶,画面中的车身外观、道路结构和环境光照在长时间生成过程中保持了较好的一致性。
Tech Report 还展示了两组约五分钟的赛车序列对比,分别为 298 秒和 299 秒。在这些序列中,Invoker-Render 能够持续跟随输入轨迹,并保持车辆外观。
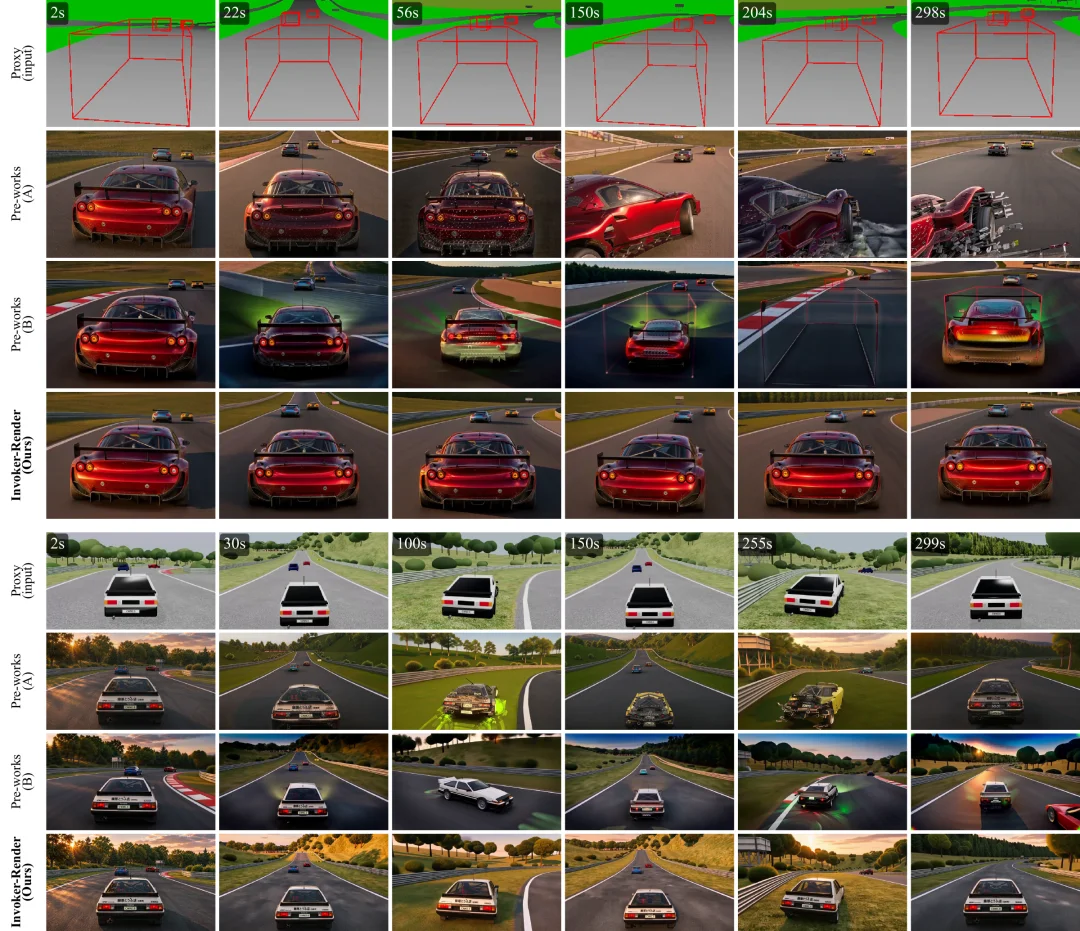
两组长时赛车序列的关键帧对比,生成时长分别达到 298 秒和 299 秒。
团队另外展示的完整赛车演示,则将连续生成时间延伸到了 30 分钟。
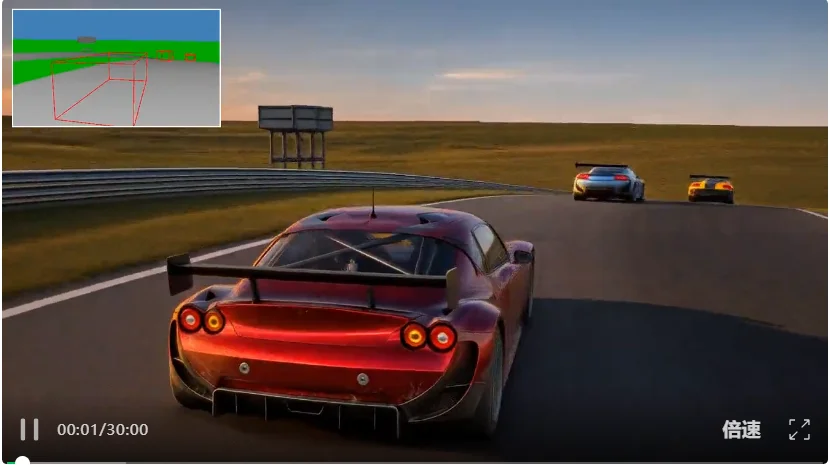
从几秒钟的生成演示,到数分钟的连续运行,再到半小时的一镜到底,CWM 2.0 展示了在长时间流式生成中维持场景结构和主体外观一致性的能力。
除了模型训练,实时流式生成还需要一套能够持续运行的推理系统。
即使模型已经能够用四步完成一个视频块的生成,如果每次推理仍然需要重复处理大量历史信息,编码、生成和解码环节必须依次等待,整体效率仍然会受到限制。
这次 CWM 2.0 不仅发布了模型,也随报告开放了基于 SGLang 与 SGLang-Omni 构建的单机八卡流式推理引擎。
团队针对连续推理设计了几项工程优化。
首先,通过结构化块因果掩码,将每个视频块的主干前向调用从六次减少至四次,降低约三分之一的调用开销。
常规流式推理除了四步去噪,还需要分别完成上一块历史上下文的提交,以及下一块 Proxy 条件的预填充。团队通过结构化块因果掩码,将历史提交、条件预填充和第一步去噪融合到一次前向计算中,剩余三次前向完成后续去噪。
其次是缓存复用。
团队通过常驻外观参考锚点、持久化 KV 缓冲区和零拷贝滑动窗口,让关键历史信息能够在显存中持续复用,同时对不断增长的历史窗口进行管理,减少重复计算与数据搬运。
最后是八卡流水线调度。
在这套系统中,Proxy 编码、视频生成和视频解码不再完全串行等待。模型生成当前视频块时,系统可以并行准备下一块 Proxy,并对上一块生成结果进行解码。不同计算阶段通过流水线调度重叠执行,减少等待时间。
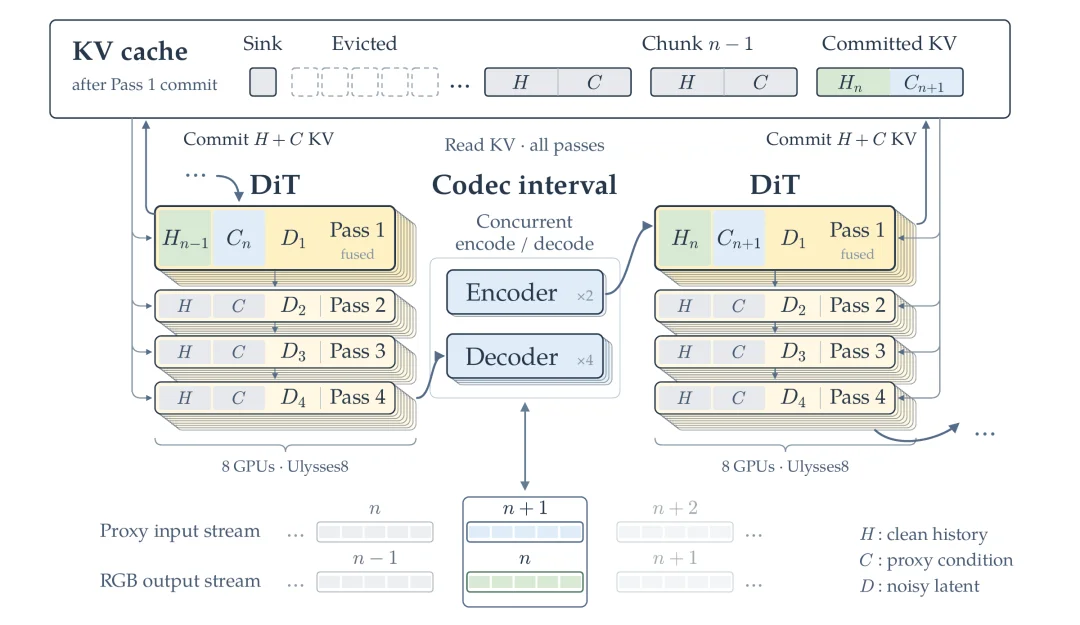
CWM 2.0 八卡流式推理架构示意。通过 KV Cache 复用历史上下文,并利用流水线调度,让 Proxy 编码、模型生成与视频解码能够部分并行。
配套代码仓库还提供 WebSocket 会话服务、文件推理客户端,以及支持手柄交互的浏览器前端。
因此,这次发布不只是提供一组模型权重。开发者还可以获得与模型配套的流式推理实现和交互工具,进一步降低体验和部署这套技术的门槛。
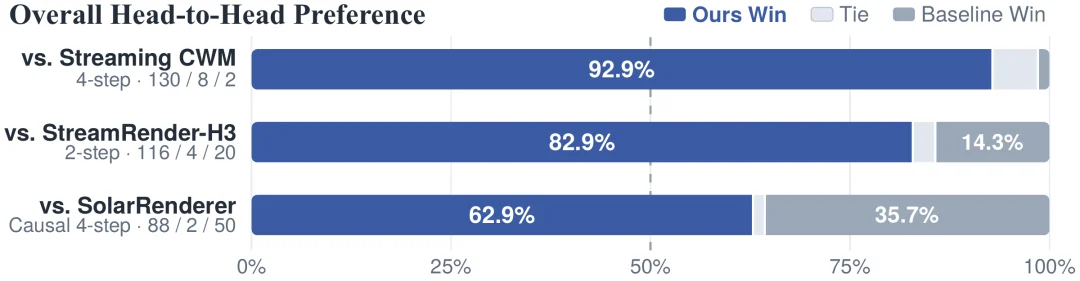
团队设计了 140 组留出测试序列,对 Invoker-Render 与三款近期流式渲染模型进行对比。
这些测试覆盖不同三维环境、多主体交互和不同 Proxy 表示方式。评测采用 Gemini 3.8 Flash 进行匿名两两比较,再通过 Bradley–Terry 模型拟合 Elo 分数。
具体分为四个维度:画面质量、结构与运动、参考外观保持,以及综合偏好。
在这些测试中,Invoker-Render 四项指标均排名第一:
● 画面质量 Elo:1336.4
● 结构与运动 Elo:1309.0
● 参考外观保持 Elo:1214.1
● 综合偏好 Elo:1343.2
在与三种流式渲染基线的对比中,Invoker-Render 均取得了更高的综合偏好,胜率分别达到 92.9%、82.9% 和 62.9%。其中,面对最具竞争力的 Other Work-3,综合偏好 Elo 领先 97.9 分。
在七组流式生成对比中,其他方法出现了明显的结构和外观漂移。
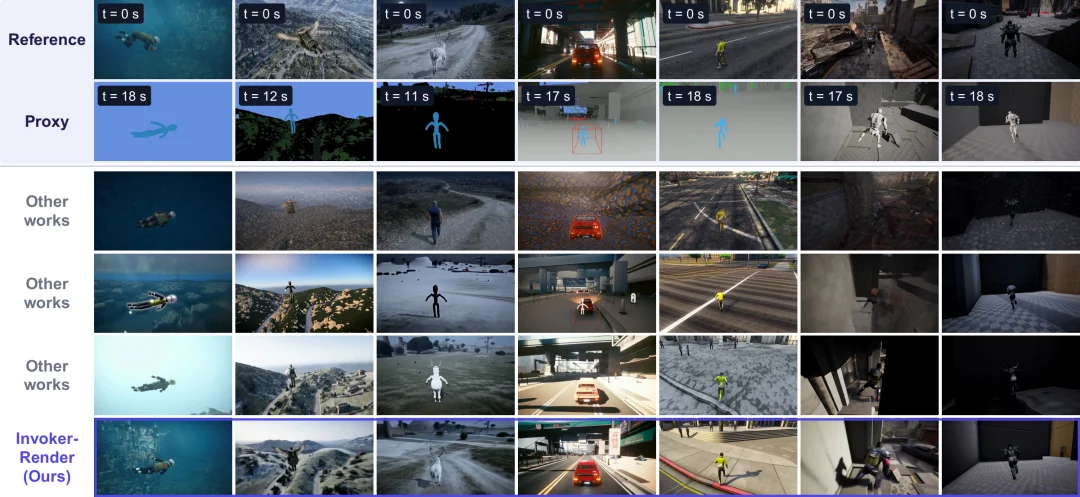
七组留出序列的流式生成结果对比。相较于其他方法,Invoker-Render 在主体外观、场景结构和运动表现上更接近参考画面。
例如,在水下场景中,其他方法生成的环境逐渐偏离原本的水下礁石,甚至变成明亮的天空;奔跑的鹿失去了鹿角,带翅膀的角色丢失了翅膀,原本鲜红的跑车也逐渐褪成米白色。还有一些场景出现明显的道路纹理退化,甚至整片区域逐渐变黑。
这些变化说明,流式世界渲染需要同时维持多种约束:物体运动要遵循结构输入,主体还必须在不同时间保持原有外观。
当世界模型不仅能够完成生成,还能够精确控制和持续修改,它的应用场景就不再只是生成一个供人观看的画面,而有机会成为新的创作与交互空间。
在 Akina 赛车演示中,用户通过手柄改变车辆的运动状态,左下角的 Proxy 随之变化,主画面则同步呈现车辆转向和赛道环境的变化。这种方式为游戏原型、交互式虚拟环境等场景提供了一种新的实现思路,开发者不必完全依赖传统图形管线生成所有视觉细节,也可以将结构化控制与生成式渲染结合起来。
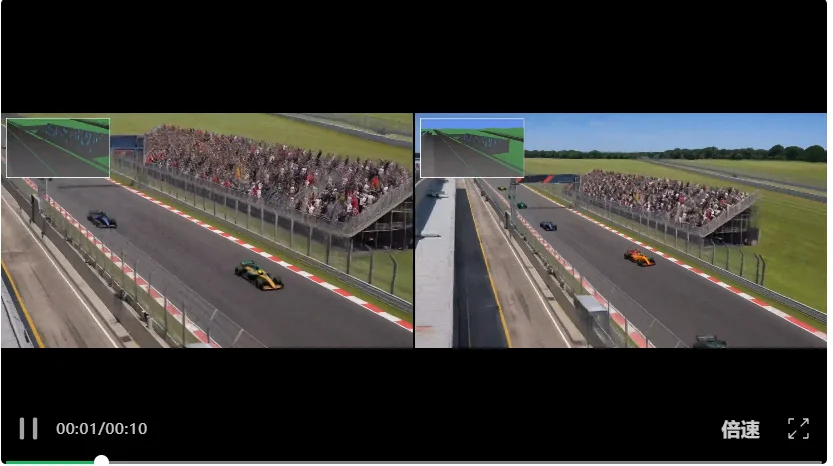
影视创作则是另一个值得关注的方向。在赛车超车的双镜头演示中,创作者可以通过调整摄影机路径,生成同一事件的不同视角画面,这也为影视创作中的镜头预演和分镜设计提供了新的工具。
从 CWM 1.0 提出的 Coding Agent as World Brain,到 CWM 2.0 对生成式渲染能力的进一步完善,这条路线正在逐步补齐从世界构建、规则控制到实时视觉呈现的关键环节。
未来,世界模型或许不再只是根据一句提示词生成一段视频,而是一个能够通过代码定义规则、通过交互改变状态,再由生成模型持续呈现的世界。让生成的世界真正「听话」,正在从技术设想逐步变为现实。
文章来自于"机器之心",作者 "山辉"。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
