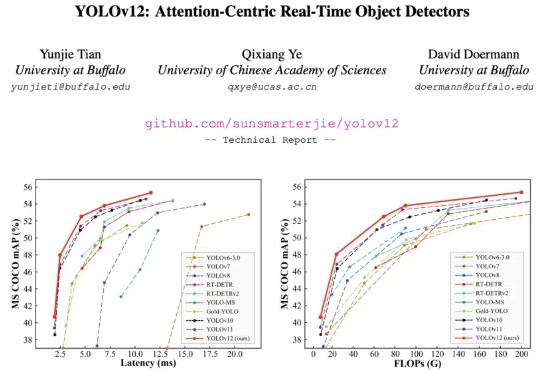
YOLO已经悄悄来到v12,首个以Attention为核心的YOLO框架问世
YOLO已经悄悄来到v12,首个以Attention为核心的YOLO框架问世YOLO 系列模型的结构创新一直围绕 CNN 展开,而让 transformer 具有统治优势的 attention 机制一直不是 YOLO 系列网络结构改进的重点。这主要的原因是 attention 机制的速度无法满足 YOLO 实时性的要求。
来自主题: AI技术研报
10742 点击 2025-02-22 14:14

 搜索
YOLO 系列模型的结构创新一直围绕 CNN 展开,而让 transformer 具有统治优势的 attention 机制一直不是 YOLO 系列网络结构改进的重点。这主要的原因是 attention 机制的速度无法满足 YOLO 实时性的要求。
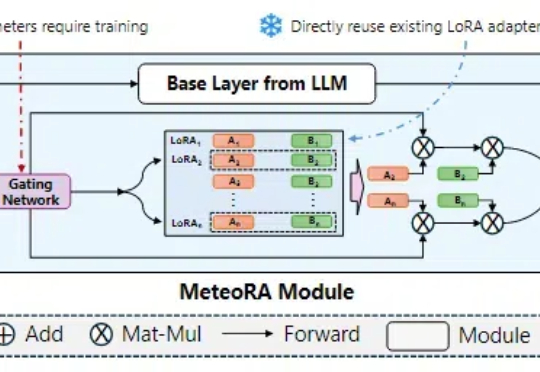
在大语言模型领域中,预训练 + 微调范式已经成为了部署各类下游应用的重要基础。在该框架下,通过使用搭低秩自适应(LoRA)方法的大模型参数高效微调(PEFT)技术,已经产生了大量针对特定任务、可重用的 LoRA 适配器。
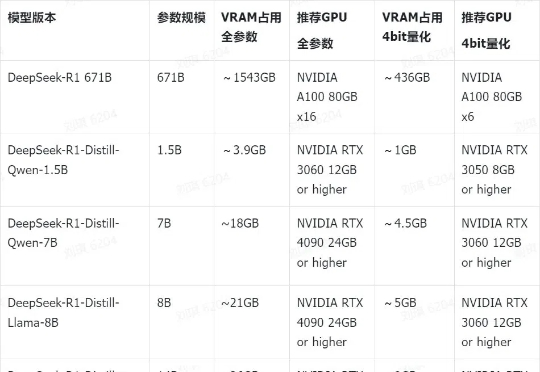
DeepSeek-R1及其蒸馏版本模型突破了AI Reasoning和大规模AI性能的新基准,其中DeepSeek-R1-Zero和DeepSeek-R1,已经在推理和问题求解上树立了新的标准。本次研究聚焦于如何利用已有的机器进行模型部署,使用这些先进的模型进行开发和研究。
随着人工智能的加速发展,我们常常担心AI会突然失控、超越人类控制。然而,最新研究指出,这种「突然失控」的场景或许并非最令人担忧的;AI在各个领域逐步取代人类,导致人类权力和影响力的缓慢流失,可能才是更隐蔽、更难以应对的渐变式风险。
官宣免费后,Grok火速登顶美区App Store榜首,同时,xAI也放出官方博文,秀了一把模型的数学、代码、ASCII Art演示。最引人瞩目的两位C位华人,均来自多伦多大学,分别和Hinton、Bengio有交集。
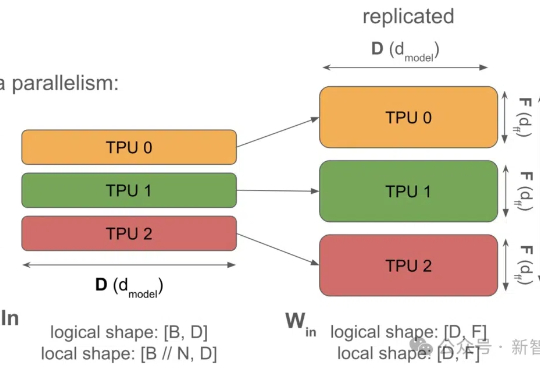
谷歌团队发布LLM硬核技术教科书,从「系统视图」揭秘LLM Scaling的神秘面纱。Jeff Dean强调书中藏着谷歌最强AI模型Gemini训练的更多信息。
近年来, Scaling Up 指导下的 AI 基础模型取得了多项突破。从早期的 AlexNet、BERT 到如今的 GPT-4,模型规模从数百万参数扩展到数千亿参数,显著提升了 AI 的语言理解和生成等能力。然而,随着模型规模的不断扩大,AI 基础模型的发展也面临瓶颈:高质量数据的获取和处理成本越来越高,单纯依靠 Scaling Up 已难以持续推动 AI 基础模型的进步。
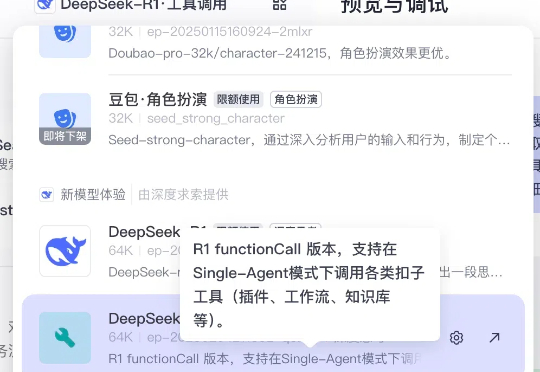
众所周知,目前 DeepSeek R1 有一个很大的痛点是不支持 Function Call 的。GitHub 上有许多开发者都表达了这一诉求。
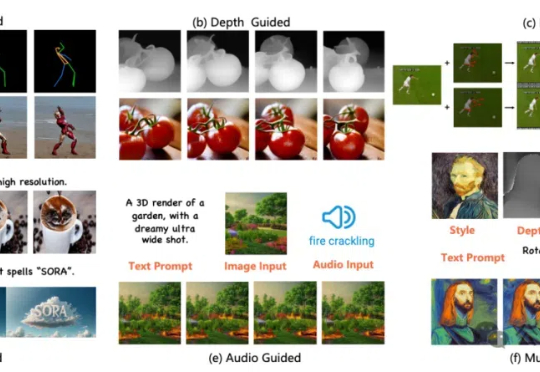
视频扩散模型新综述来了,覆盖300+文献的那种。
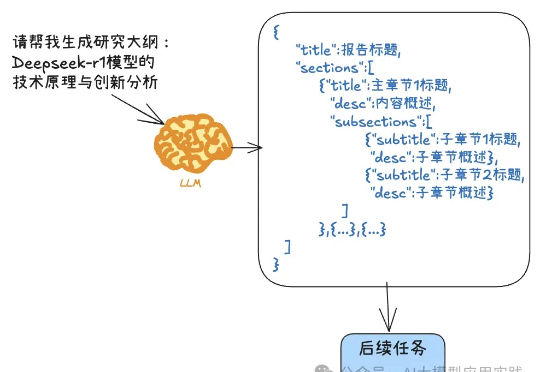
DeepSeek-R1这样的推理模型有着强大的深度思考能力,但也有着一些不同于通用模型的特点与用法,比如不支持函数调用,不支持结构化输出,o1甚至不支持系统提示(System Prompt)等。尽管这和它们的使用场景有关,但有时也会带来不便。今天我们就来说说结构化输出这个常见的问题。
AlphaFold 3 获得诺贝尔奖是 AI 智能重要的里程碑,让我们有信心类似 AlphaFold 的模型能为接下来十年的科学和生物结构发现起到关键作用。
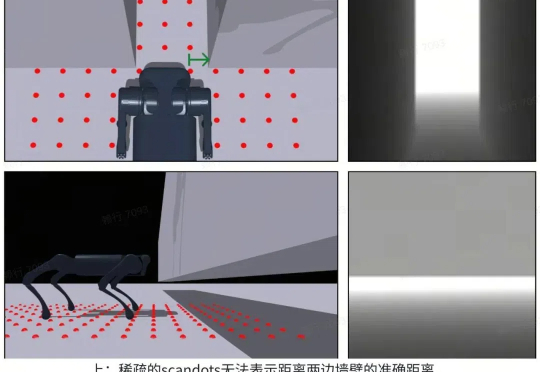
世界模型(World Model)作为近年来机器学习和强化学习的研究热点,通过建立智能体对其所处环境的一种内部表征和模拟,能够加强智能体对于世界的理解,进而更好地进行规划和决策。
Transformer论文八位作者之一Llion Jones创立的Sakana AI发布重磅成果——全球首个「AI CUDA工程师」!它能将PyTorch代码自动转换为高度优化的CUDA内核,速度比PyTorch原生实现快10-100倍。
AI虚拟细胞,在计算机中代谢的生命体。2024年12月,斯坦福大学、基因泰克制药公司和陈-扎克伯格基金会的研究团队在《Cell》杂志上发表论文[1],呼吁全球科学界利用AI技术制造这一“数据细胞”。听起来像是科幻电影里的情节,但它正在悄然发生,并即将改变生物医学界的未来。
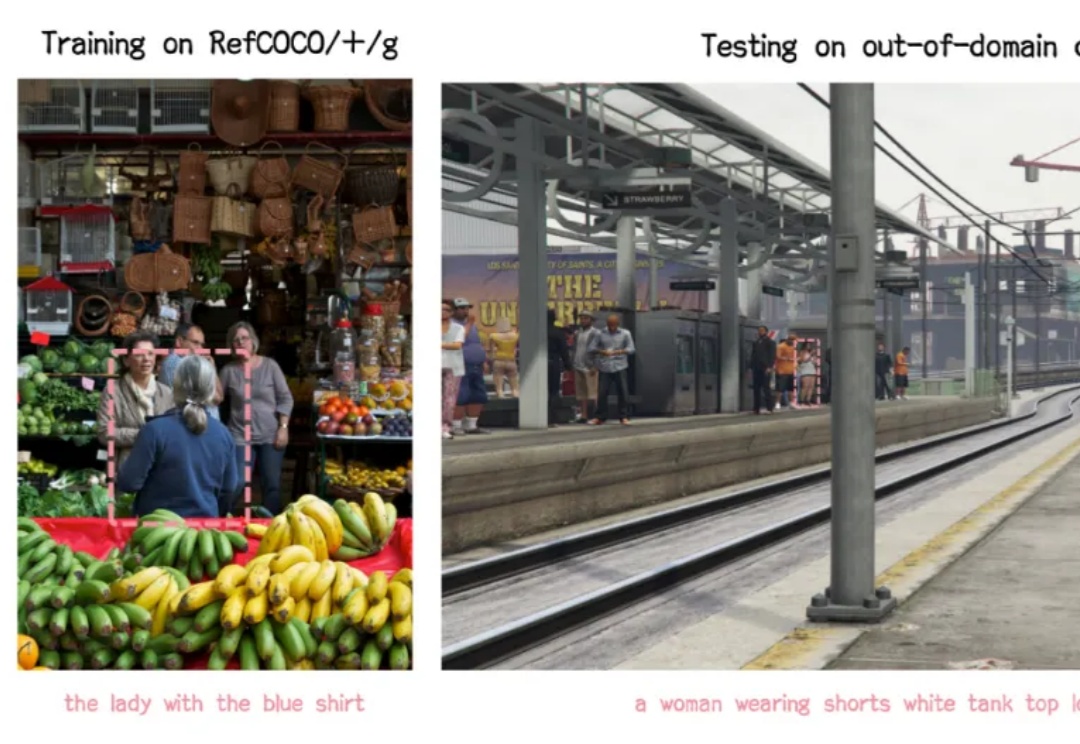
嘿,各位开发小伙伴,今天要给大家安利一个全新的开源项目 ——VLM-R1!它将 DeepSeek 的 R1 方法从纯文本领域成功迁移到了视觉语言领域,这意味着打开了对于多模态领域的想象空间!
在今年1月《Journal of Supercomputing》上开源的「开源类脑芯片」二代(Polaris 23)完整版本源代码,基于RISC-V架构,支持脉冲神经网络(SNN)和反向传播STDP。该芯片通过并行架构显著提升神经元和突触处理能力,带宽和能效大幅提升,MNIST数据集准确率达91%。
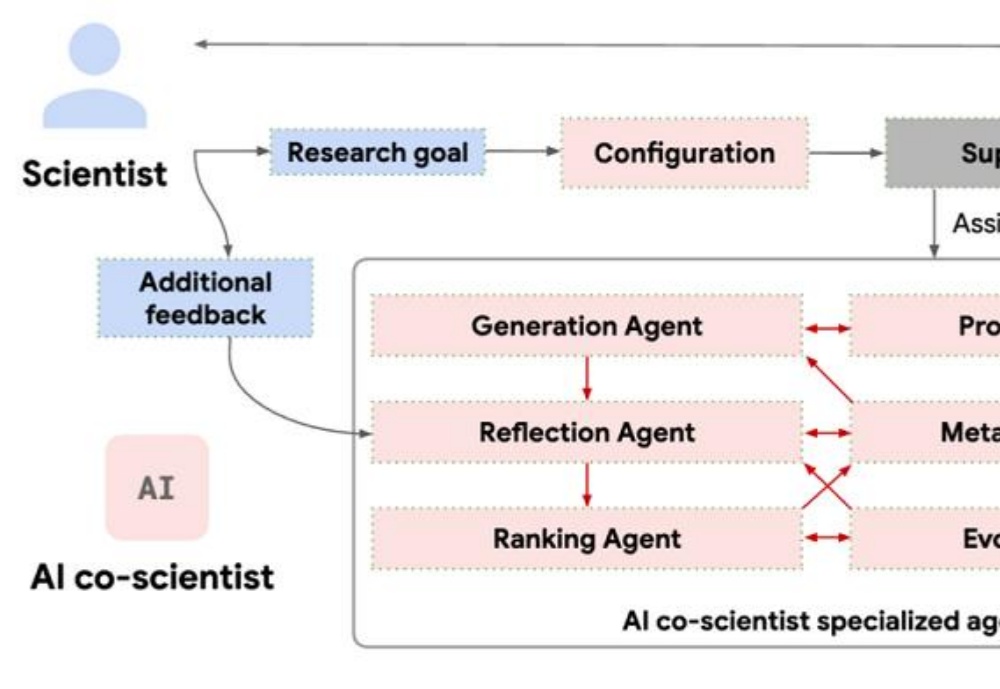
AI协作科学家在测试中提供了新颖的见解。
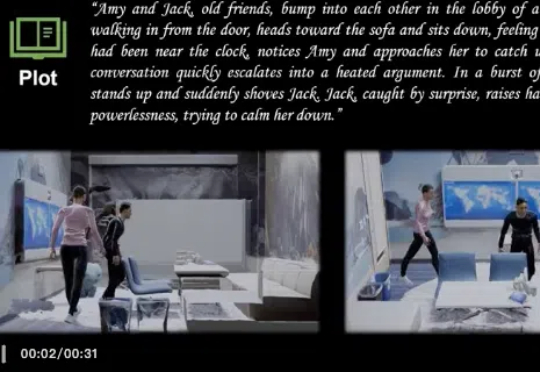
设定一个3D场景,你便可以用文字编织你的剧情。一句话,就能让两个人激烈争吵。来自北京航空航天大学、香港中文大学(深圳)、悉尼科技大学、中山大学等高校的研究者提出Sitcom-Crafter。成果已被ICLR 2025会议接收。
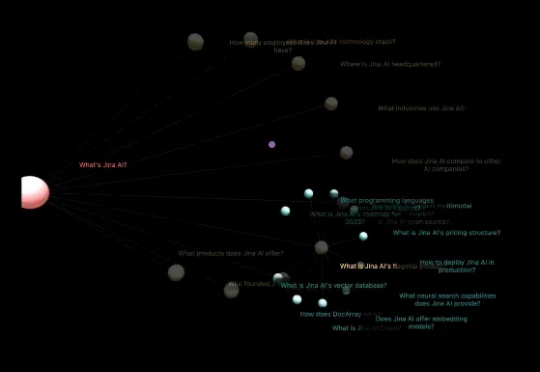
最初,查询扩展是为那些靠关键词匹配来判断相关性的搜索系统设计的,比如 tf-idf 或其他稀疏向量方案。这类方法有些天然的缺陷:词语稍微变个形式,像 "ran" 和 "running",或者 "optimise" 和 "optimize",都会影响匹配结果。虽然可以用语言预处理来解决一部分问题,但远远不够。技术术语、同义词和相关词就更难处理了。
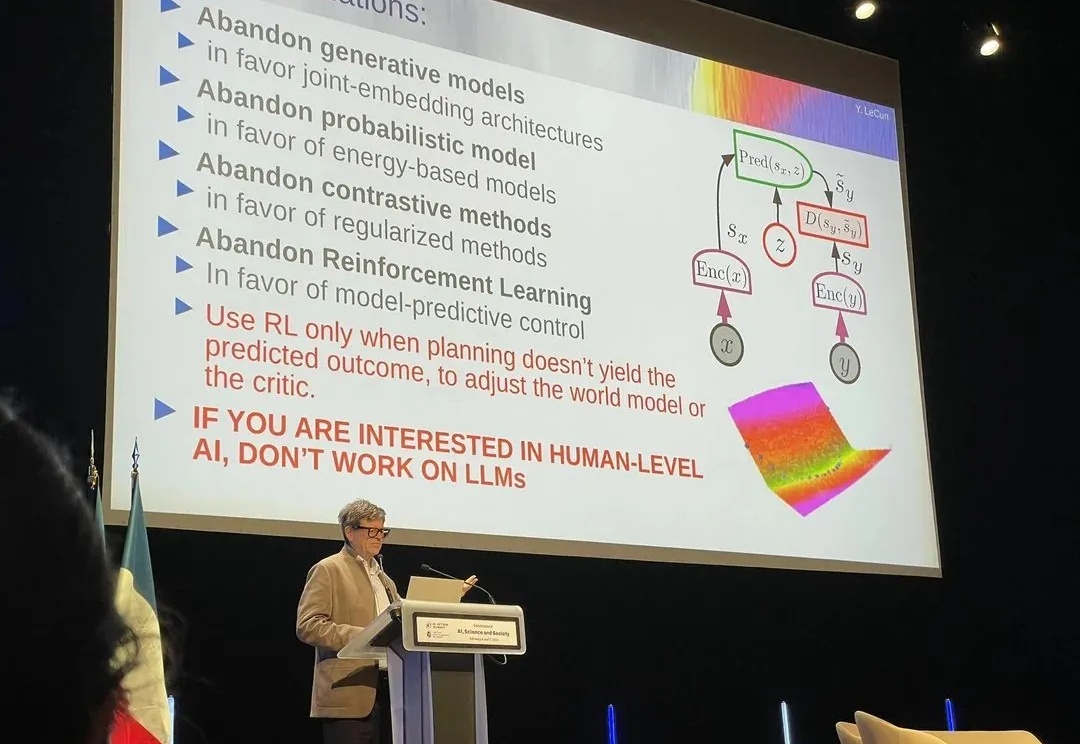
在当今的 AI 领域,图灵奖得主 Yann LeCun 算是一个另类。即便眼见着自回归 LLM 的能力越来越强大,能解决的任务也越来越多,他也依然坚持自己的看法:自回归 LLM 没有光明的未来。
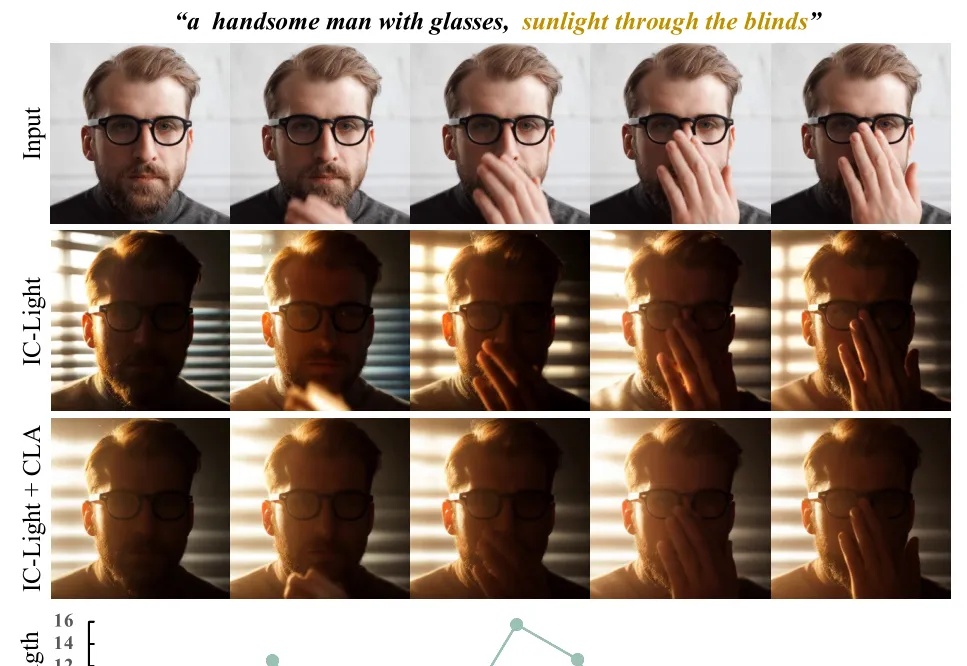
数字化时代,视频内容的创作与编辑需求日益增长。从电影制作到社交媒体,高质量的视频编辑技术成为了行业的核心竞争力之一。然而,视频重打光(video relighting)—— 即对视频中的光照条件进行调整和优化,一直是这一领域的技术瓶颈。传统的视频重打光方法面临着高昂的训练成本和数据稀缺的双重挑战,导致其难以广泛应用。
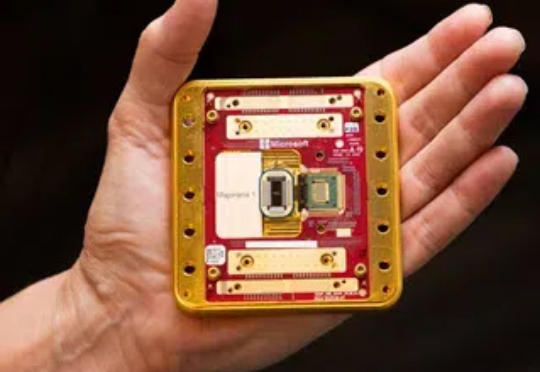
想象一下,一个放在手掌上的芯片,能解决当今地球上所有计算机加起来都无法解决的问题。
AI生成内容已深度渗透至生活的方方面面,从艺术创作到设计领域,再到信息传播与版权保护,其影响力无处不在。

CEO皮猜亲自站台,谷歌的最新研究狠狠火了——
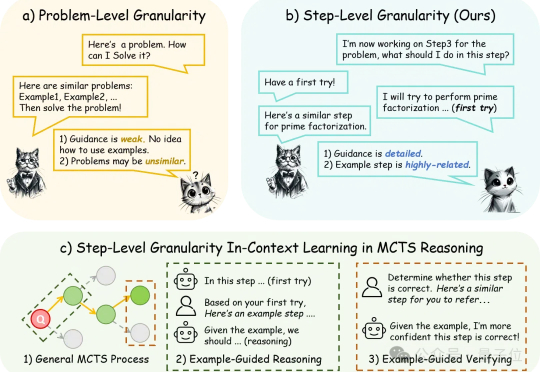
仅需简单提示,满血版DeepSeek-R1美国数学邀请赛AIME分数再提高。
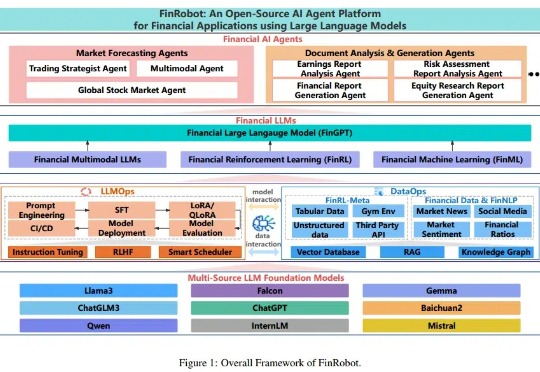
随着金融机构和专业人士越来越多地将大语言模型(LLMs)纳入其工作流程中,金融领域与人工智能社区之间依然存在显著障碍,包括专有数据和专业知识的壁垒。本文提出了 FinRobot,一种支持多个金融专业化人工智能智能体的新型开源 AI 智能体平台,每个代理均由 LLM 提供动力。

DeepSeek爆火甚至引发API低价内卷……
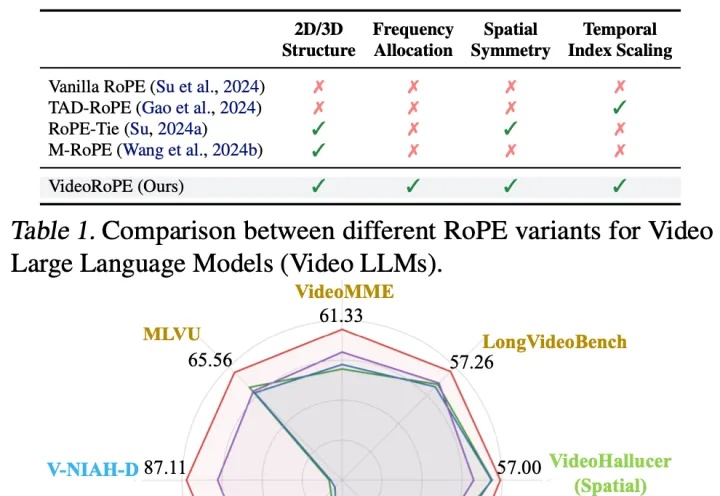
Llama都在用的RoPE(旋转位置嵌入)被扩展到视频领域,长视频理解和检索更强了。
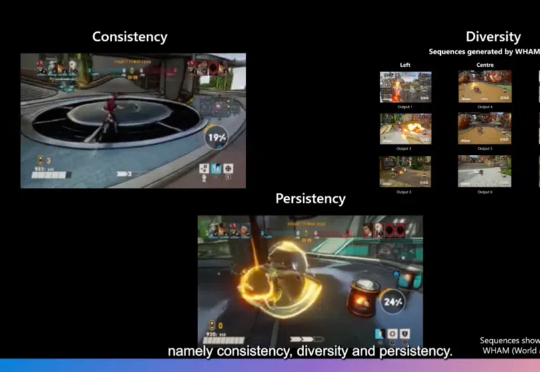
游戏开发不仅需要生成新颖的内容,更需要在保持游戏世界一致性、多样性和用户修改持续性方面达到高度平衡。近日,一篇发表在Nature上的研究论文World and Human Action Models towards Gameplay Ideation揭示了如何利用生成式AI模型推动游戏玩法创意的生成。

OpenAI刚刚发布SWE-Lancer编码基准测试,直接让AI模型挑战真实外包任务!这些任务总价值高达100万美元。有趣的是,测试结果显示,Anthropic的Claude 3.5 Sonnet在「赚钱」能力上竟然超越了OpenAI自家的GPT-4o和o1模型。