
这个国庆,智谱悄咪咪打起了第二轮价格战
这个国庆,智谱悄咪咪打起了第二轮价格战近一个月来,全面对标 OpenAI 的智谱大小动作不断,GLM-4-Flash 免费,推出极致性价比的 FlashX,旗舰模型升级到 Plus 系列... 其中最为关注的就是 Plus 系列,模型性能越来越强的同时,价格也越来越低。
来自主题: AI资讯
6809 点击 2024-10-01 14:37

 搜索
近一个月来,全面对标 OpenAI 的智谱大小动作不断,GLM-4-Flash 免费,推出极致性价比的 FlashX,旗舰模型升级到 Plus 系列... 其中最为关注的就是 Plus 系列,模型性能越来越强的同时,价格也越来越低。
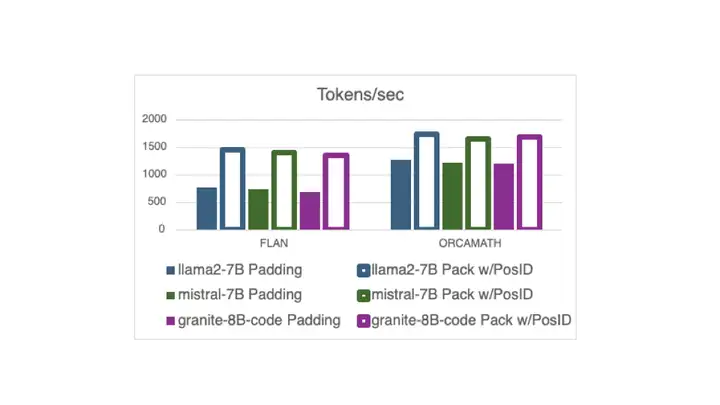
现在,在 Hugging Face 中,使用打包的指令调整示例 (无需填充) 进行训练已与 Flash Attention 2 兼容,这要归功于一个 最近的 PR 以及新的 DataCollatorWithFlattening。 它可以在保持收敛质量的同时,将训练吞吐量提高多达 2 倍。继续阅读以了解详细信息!

比LoRA更高效的模型微调方法来了——
大模型API,正式进入Flash时代。

用 FlexAttention 尝试一种新的注意力模式。
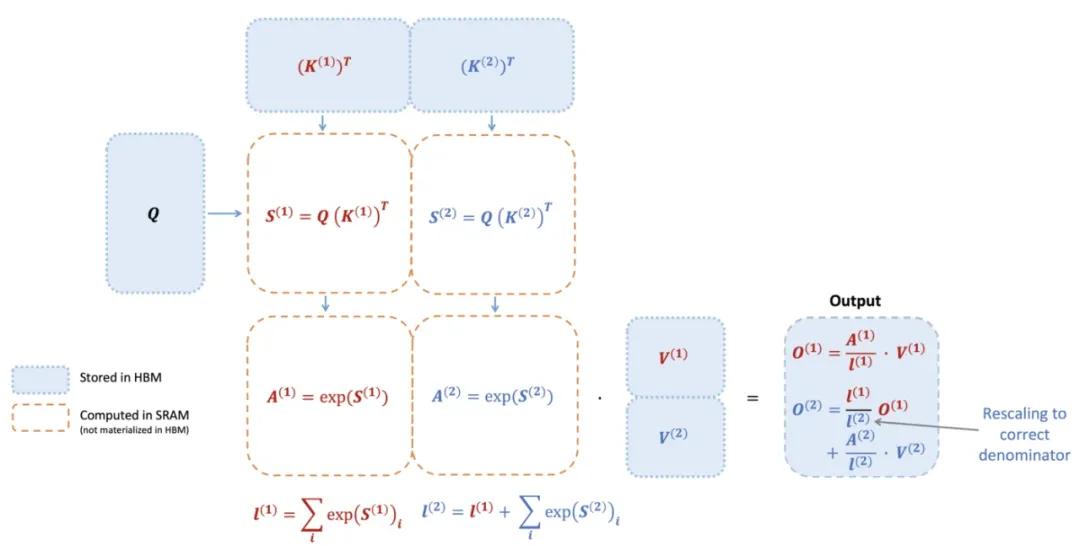
740 TFLOPS!迄今最强 FlashAttention 来了。
时隔一年,FlashAttention又推出了第三代更新,专门针对H100 GPU的新特性进行优化,在之前的基础上又实现了1.5~2倍的速度提升。
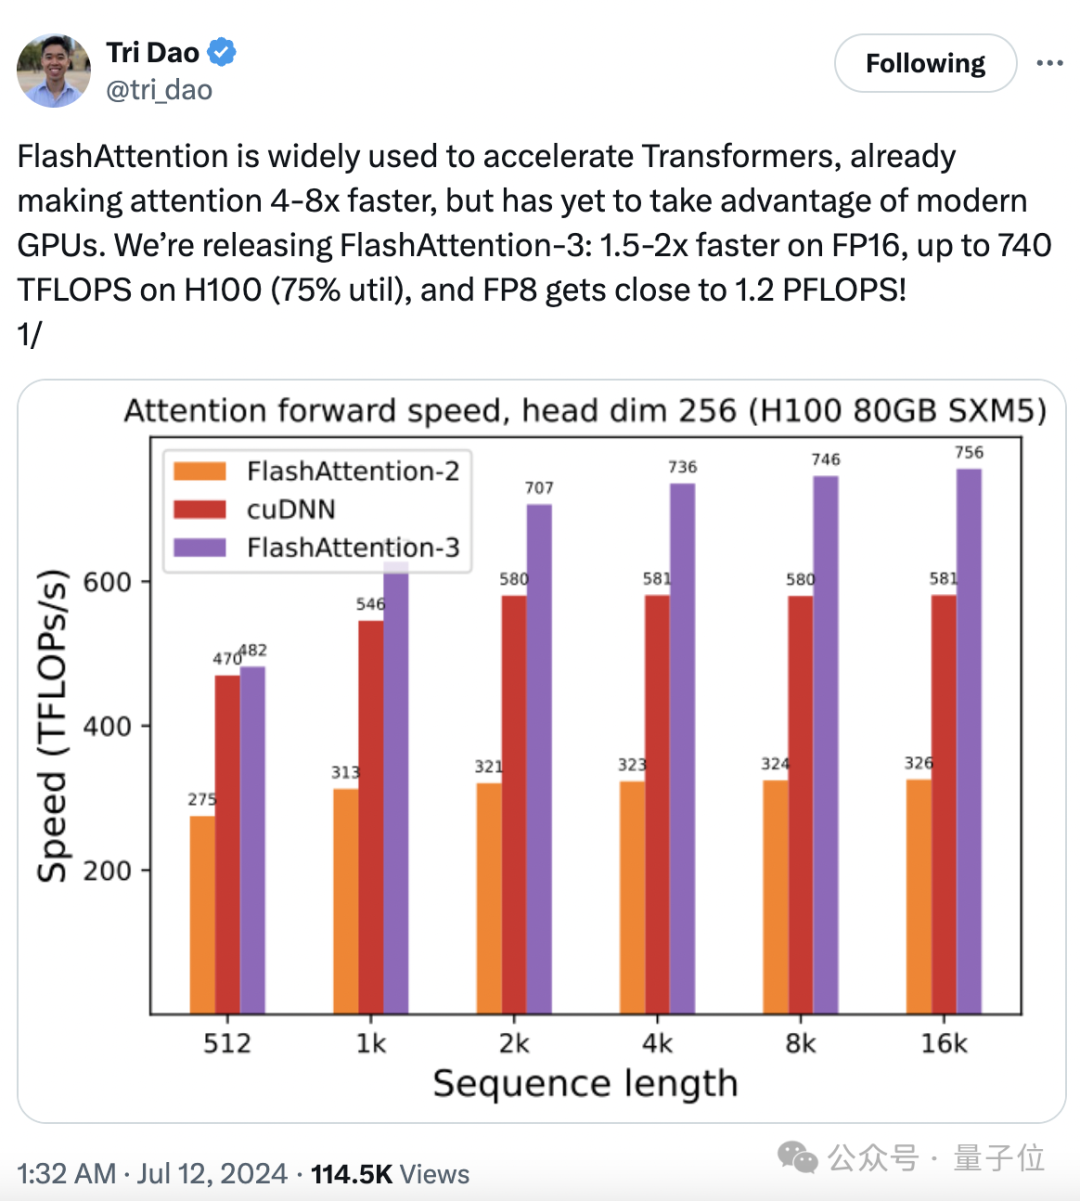
大模型训练推理神作,又更新了!
AI算力资源越发紧张的当下,斯坦福新研究将GPU运行效率再提升一波——

大模型价格战,这匹国产黑马又破纪录了!最低的GLM-4 Flash版本,百万token价格已经低至0.1元,可以说是击穿地心。MaaS 2.0大升级,让企业训练私有模型的成本无限降低。