最强代码模型刷新:Mistral新品上线即登顶,上下文窗口增至256k
最强代码模型刷新:Mistral新品上线即登顶,上下文窗口增至256k“欧洲版 OpenAI” Mistral 的代码模型 CodeStral,又上新了! 而且与 DeepSeek V2.5 和 Claude 3.5 平起平坐,共同位列 Copilot 竞技场第一名。
来自主题: AI资讯
10221 点击 2025-01-14 15:42

 搜索
“欧洲版 OpenAI” Mistral 的代码模型 CodeStral,又上新了! 而且与 DeepSeek V2.5 和 Claude 3.5 平起平坐,共同位列 Copilot 竞技场第一名。

太好了!DeepSeek有App了,我们有救了!(doge) 现在,官方应用上线App Store,背后正是由此前火爆全网的“国产之光”DeepSeek V3模型提供支持。

谷歌推出的FACTS Grounding基准测试,能评估AI模型在特定上下文中生成准确文本的能力,有助于提升模型的可靠性;通过去除不满足用户需求的回复,确保了评分的准确性和模型排名的公正性。

新年新气象!谷歌内部AI人才来了个大迁移—— 统一归拢到DeepMind旗下,归诺奖得主哈萨比斯领导。
因为 V3 版本开源模型的发布,DeepSeek 又火了一把,而且这一次,是外网刷屏。 训练成本估计只有 Llama 3.1 405B 模型的 11 分之一,后者的效果还不如它。

年度盘点第二弹:关于DeepSeek。
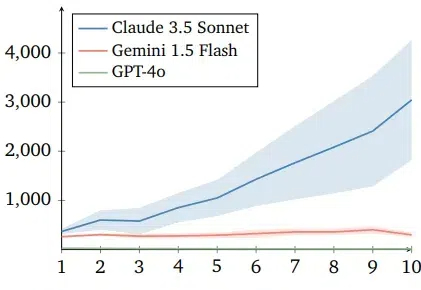
智能体在模拟人类合作行为的捐赠者游戏中表现出不同策略,其中Claude 3.5智能体展现出更有效的合作和惩罚搭便车行为的能力,而Gemini 1.5 Flash和GPT-4o则表现得更自私,结果揭示了不同LLM智能体在合作任务中的道德和行为差异,对未来人机协同社会具有重要意义。
在人工智能领域,大语言模型(LLMs)展现出了令人惊叹的能力,但在因果推理这一人类智能的核心能力上仍面临重大挑战。特别是在从相关性信息推断因果关系这一任务上,现有的大语言模型表现出明显的不足。

Argil采用SOTA deepfake模型的AI数字人技术,专为当今以视频为中心的环境而量身定制,旨在推广视频创作大众化,可满足创作者满足不断提高的质量标准的需求,而无需传统的时间和成本障碍。

DeepSeek-v3大模型横空出世,以1/11算力训练出超过Llama 3的开源模型,震撼了整个AI圈。