AI资讯新闻榜单内容搜索-Ema

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Ema
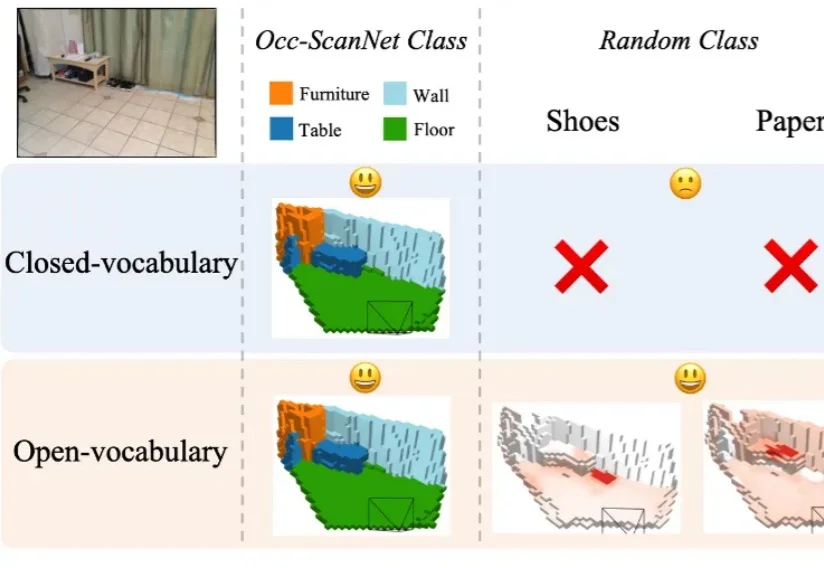
CVPR 2026 Oral|横扫室内3D场景,港科大(广州)打造单目开放词汇占据预测新SOTA

CVPR 2026 Oral|横扫室内3D场景,港科大(广州)打造单目开放词汇占据预测新SOTA

CVPR 2026 Oral|横扫室内3D场景,港科大(广州)打造单目开放词汇占据预测新SOTA

在具身智能研究中,如何让智能体精准理解周围环境的精细几何结构与开放语义信息,始终是具身感知的核心难题。近年来,语义占据预测(Semantic Occupancy Prediction) 将稠密几何与语义信息统一到三维体素网格中,用于构建 3D 语义占据地图,为机器人的空间推理、导航与交互操作提供了场景表达基础。

来自主题: AI技术研报
11213 点击    2026-05-06 09:07
谢邀,人在路口画8字,谷歌Gemini突然对着我耳边:往红房子走,铁憨憨

谢邀,人在路口画8字,谷歌Gemini突然对着我耳边:往红房子走,铁憨憨

谢邀,人在路口画8字,谷歌Gemini突然对着我耳边:往红房子走,铁憨憨

GoogleMaps核弹更新:Gemini接管步行骑行导航!问厕所咖啡馆?问EV充电剩几个坑?问街区Vibe?Gemini秒懂人话、懂物理世界。路痴起立,再也不用举手机转圈自闭了!

来自主题: AI资讯
11085 点击    2026-03-30 16:06
这年头学不会数理化,只能怪自己懒,谷歌NotebookLM上新,秒出科普视频

这年头学不会数理化,只能怪自己懒,谷歌NotebookLM上新,秒出科普视频

这年头学不会数理化,只能怪自己懒,谷歌NotebookLM上新,秒出科普视频

最近,谷歌 NotebookLM 又出了个好玩好用的小功能:Cinematic Video Overviews(电影级视频概览)。与普通模板不同,这项功能可以根据我们上传的资料,自动生成定制化、沉浸式的视频讲解。

来自主题: AI资讯
8670 点击    2026-03-15 08:48
AAAI 2026 Oral | SplatSSC:解耦深度引导的高斯泼溅,开启单目语义场景补全高效新范式

AAAI 2026 Oral | SplatSSC:解耦深度引导的高斯泼溅,开启单目语义场景补全高效新范式

AAAI 2026 Oral | SplatSSC:解耦深度引导的高斯泼溅,开启单目语义场景补全高效新范式

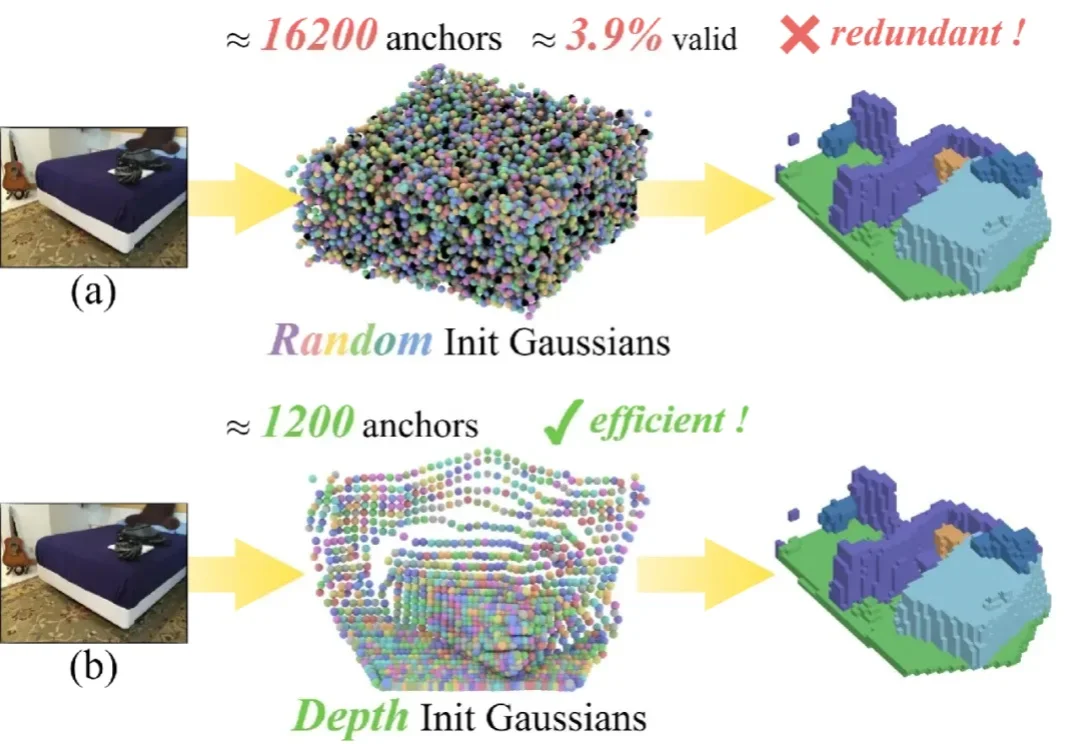
单目 3D 语义场景补全 (Semantic Scene Completion, SSC) 是具身智能与自动驾驶领域的一项核心技术,其目标是仅通过单幅图像预测出场景的密集几何结构与语义标签。

来自主题: AI技术研报
10221 点击    2026-01-28 14:58
一张图生成任意场景3D模型,部分遮挡也不怕|IDEA x 光影焕像联合开源

一张图生成任意场景3D模型,部分遮挡也不怕|IDEA x 光影焕像联合开源

一张图生成任意场景3D模型,部分遮挡也不怕|IDEA x 光影焕像联合开源

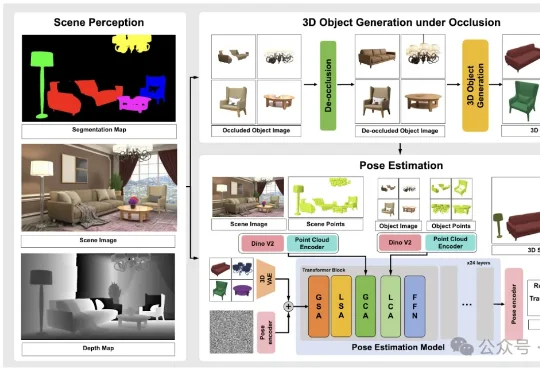
IDEA研究院张磊团队与香港科技大学谭平团队联合推出SceneMaker框架,有望攻克这一问题。 它以视启未来的万物检测模型DINO-X与光影焕像的万物3D生成模型Triverse为基础,实现了从任意开放世界图像(室内/室外/合成图等)到带Mesh的3D场景的完整重建。

来自主题: AI技术研报
9519 点击    2026-01-26 10:16
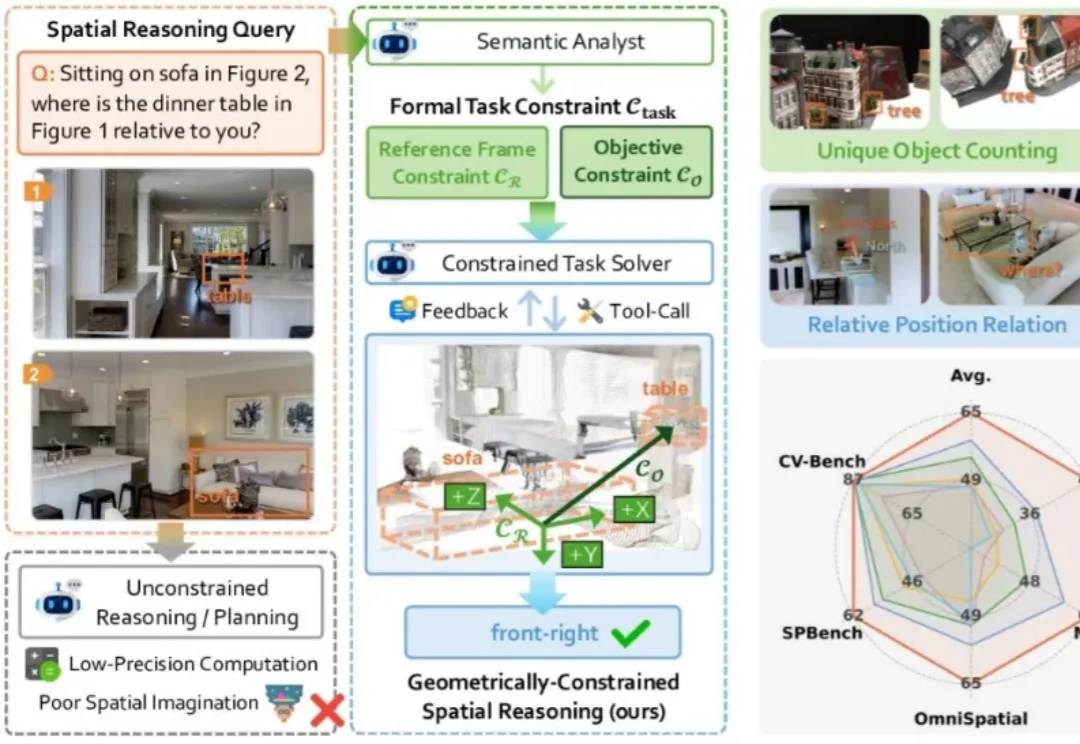
引入几何约束后,VLM跨越了「空间推理」的认知鸿沟

引入几何约束后,VLM跨越了「空间推理」的认知鸿沟

引入几何约束后,VLM跨越了「空间推理」的认知鸿沟

现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。

来自主题: AI技术研报
7547 点击    2026-01-13 10:20
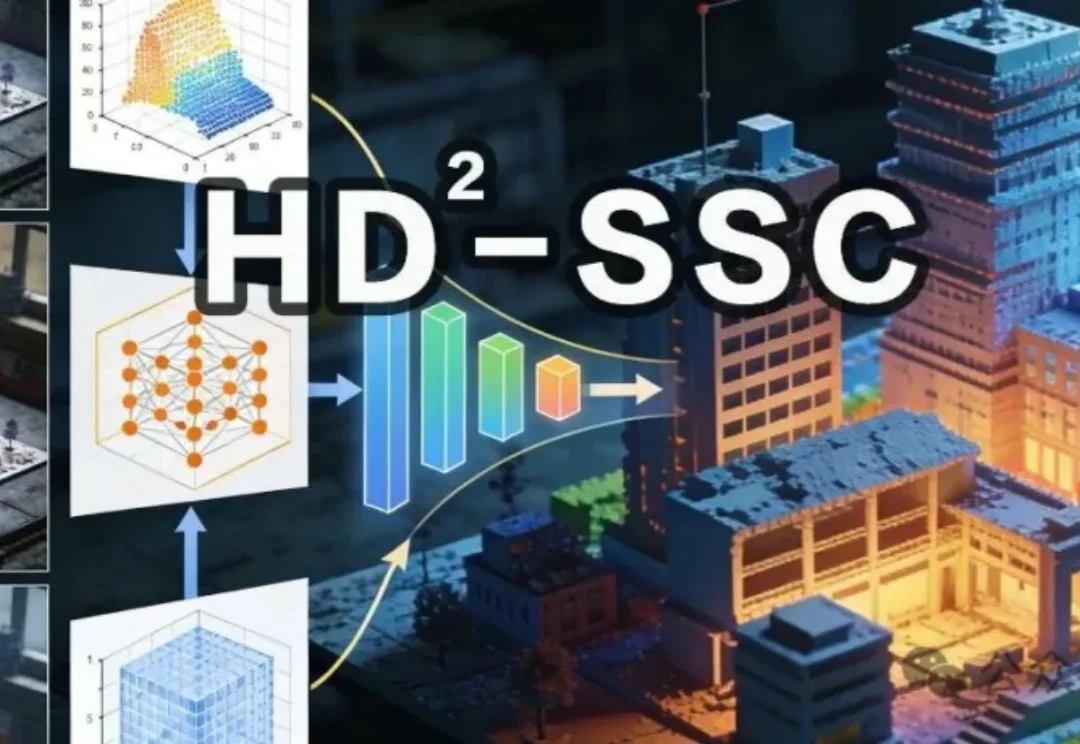
刷榜自动驾驶语义场景补全!北大新作:高维度、高密度 | AAAI'26

刷榜自动驾驶语义场景补全!北大新作:高维度、高密度 | AAAI'26

刷榜自动驾驶语义场景补全!北大新作:高维度、高密度 | AAAI'26

北京大学团队提出了一种新的视觉语义场景补全方法HD²-SSC,用于从多视角图像重建三维语义场景。该方法通过高维度语义解耦和高密度占用优化,解决了现有技术中二维输入与三维输出之间的维度差异,以及人工标注与真实场景密度差异的问题,从而实现更准确的语义场景补全。

来自主题: AI技术研报
7302 点击    2025-12-18 09:14