AI资讯新闻榜单内容搜索-MOE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: MOE
Z Tech|对话Andrew Dai:14年DeepMind生涯,见证PaLM到Gemini,下一站押注视觉推理

Z Tech|对话Andrew Dai:14年DeepMind生涯,见证PaLM到Gemini,下一站押注视觉推理

Z Tech|对话Andrew Dai:14年DeepMind生涯,见证PaLM到Gemini,下一站押注视觉推理

过去十年,大模型世界里很多最关键的技术路线背后,都能看到Andrew Dai的身影。从早期预训练与监督微调,到后来主流的MoE(Mixture of Experts)架构;从Google Brain最初只有几十人的研究时代,到后来支撑Gemini的大规模数据体系,这位在 Google 工作超过14年的研究科学家,几乎站在了大模型时代每一次关键转折的现场。

来自主题: AI资讯
10231 点击    2026-05-27 16:31
ICML 2026 | 打破「回音室」效应!人大孟澄团队&华为提出集成剪枝视角下的MoE新架构

ICML 2026 | 打破「回音室」效应!人大孟澄团队&华为提出集成剪枝视角下的MoE新架构

ICML 2026 | 打破「回音室」效应!人大孟澄团队&华为提出集成剪枝视角下的MoE新架构

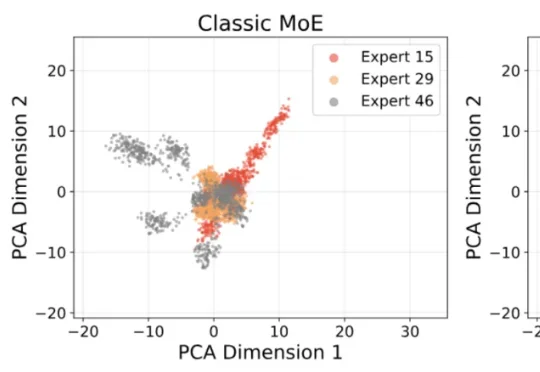
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。

来自主题: AI技术研报
8816 点击    2026-05-23 09:56
20岁写出Transformer的人,真开源2180亿大模型Command A+

20岁写出Transformer的人,真开源2180亿大模型Command A+

20岁写出Transformer的人,真开源2180亿大模型Command A+

刚刚,Cohere放出2180亿参数的MoE大模型Command A+,单张B200可跑,支持48种语言,还带原生引用能力。但这次发布最炸的,不在参数表上,而在那一个许可证:Apache 2.0。

来自主题: AI资讯
9970 点击    2026-05-22 16:01
独家|字节迎战阿里快乐马:开源多模统一模型Mamoda2.5,推理速度快18倍

独家|字节迎战阿里快乐马:开源多模统一模型Mamoda2.5,推理速度快18倍

独家|字节迎战阿里快乐马:开源多模统一模型Mamoda2.5,推理速度快18倍

独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。

来自主题: AI资讯
11065 点击    2026-05-06 10:44
DeepSeek做大→Mega MoE,Tri Dao团队加快→SonicMoE

DeepSeek做大→Mega MoE,Tri Dao团队加快→SonicMoE

DeepSeek做大→Mega MoE,Tri Dao团队加快→SonicMoE

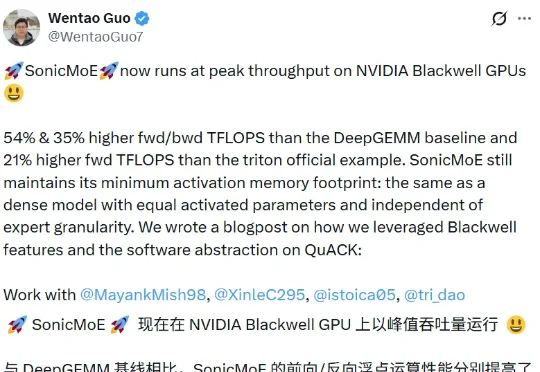
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。

来自主题: AI技术研报
8773 点击    2026-05-04 10:17
不可思议!400B大模型在iPhone上跑起来了

不可思议!400B大模型在iPhone上跑起来了

不可思议!400B大模型在iPhone上跑起来了

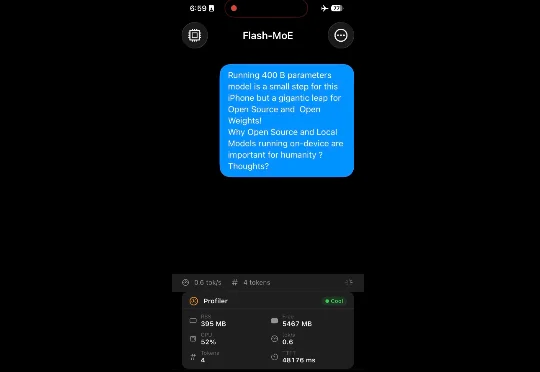
刚看到这个 Demo 的时候着实有些想笑,很久没有见过吐词如此之慢的大模型了。观感上就像「闪电」老师。尽管只有每秒 0.6 个 tokens 的输出速率,这依旧是一个令人不可思议的工作。因为这是一个跑在 iPhone 17 Pro 上的 400B 大模型!

来自主题: AI资讯
10870 点击    2026-05-02 11:02
不换GPU,性能飙升2.8倍!英伟达用软件暴打摩尔定律

不换GPU,性能飙升2.8倍!英伟达用软件暴打摩尔定律

不换GPU,性能飙升2.8倍!英伟达用软件暴打摩尔定律

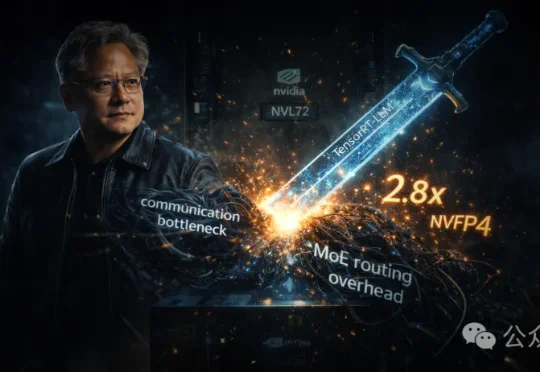
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。

来自主题: AI技术研报
10137 点击    2026-04-28 10:09
刚刚,DeepSeek开始频繁更新:Tile Kernels、DeepEP V2

刚刚,DeepSeek开始频繁更新:Tile Kernels、DeepEP V2

刚刚,DeepSeek开始频繁更新:Tile Kernels、DeepEP V2

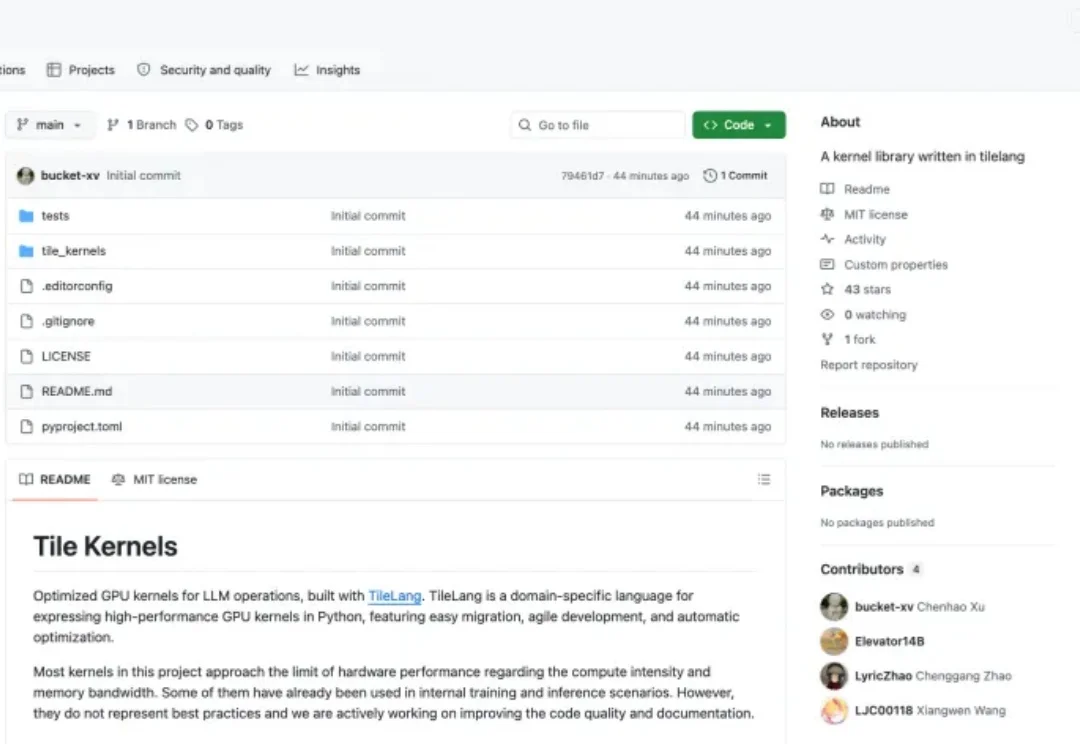
就在刚刚,DeepSeek 的 GitHub 开始了频繁更新,上线开源了一个新的代码库 Tile Kernels,同时并对 DeepEP 代码库进行了更新,上线了 DeepEP V2。距离上次 DeepSeek 悄悄更新 Mega MoE、FP4 Indexer 还不到一周。

来自主题: AI资讯
10122 点击    2026-04-24 10:09
都是你能部署的:Qwen3.6和Gemma4,谁更适合作为你的下一代本地MoE模型?

都是你能部署的:Qwen3.6和Gemma4,谁更适合作为你的下一代本地MoE模型?

都是你能部署的:Qwen3.6和Gemma4,谁更适合作为你的下一代本地MoE模型?

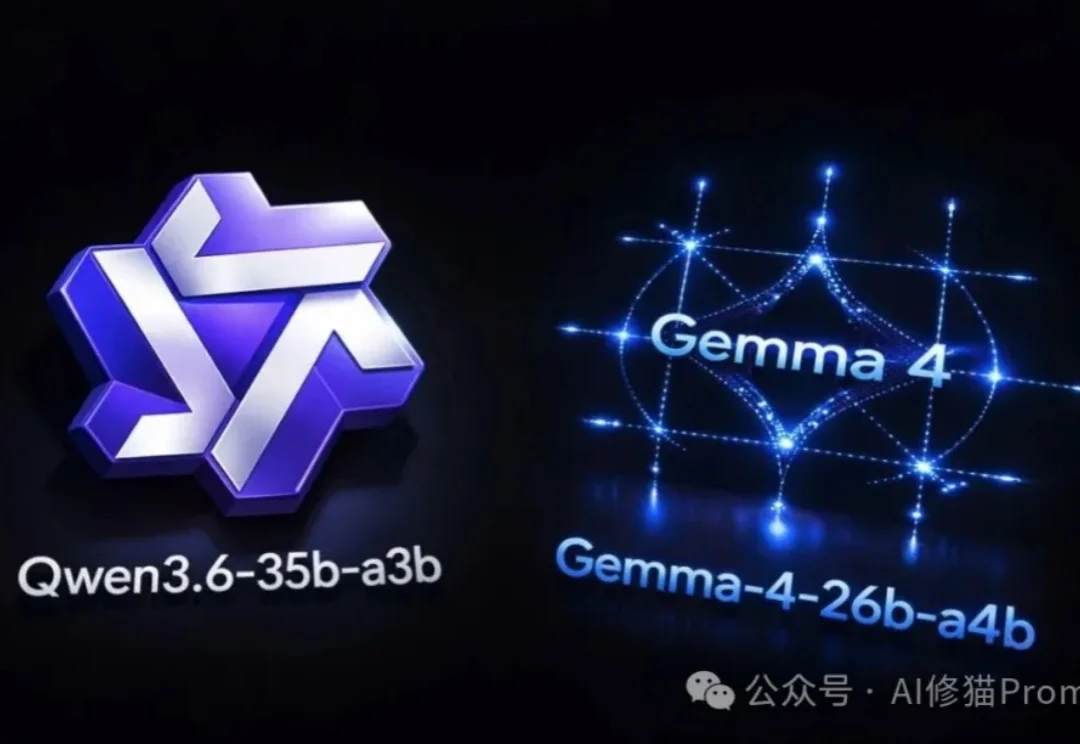
阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。

来自主题: AI技术研报
13308 点击    2026-04-23 09:23