微软开放3.1T token高质量数据!通用/代码/数学/问答,全领域超越开源
微软开放3.1T token高质量数据!通用/代码/数学/问答,全领域超越开源RedStone是一个高效构建大规模指定领域数据的处理管道,通过优化数据处理流程,从Common Crawl中提取了RedStone-Web、RedStone-Code、RedStone-Math和RedStone-QA等数据集,在多项任务中超越了现有开源数据集,显著提升了模型性能。
搜索
RedStone是一个高效构建大规模指定领域数据的处理管道,通过优化数据处理流程,从Common Crawl中提取了RedStone-Web、RedStone-Code、RedStone-Math和RedStone-QA等数据集,在多项任务中超越了现有开源数据集,显著提升了模型性能。
DeepSeek团队最新力作一上线,就获得Ai2研究所大牛推荐,和DeepSeek铁粉们的热情研读!他们提出的CodeI/O全新方法,通过代码提取了LLM推理模式,在逻辑、数学等推理任务上得到显著改进。
一个简单的笑脸😀可能远不止这么简单?最近,AI大神Karpathy发现,一个😀竟然占用了多达53个token!这背后隐藏着Unicode编码的哪些秘密?如何利用这些「隐形字符」在文本中嵌入、传递甚至「隐藏」任意数据。更有趣的是,这种「数据隐藏术」甚至能对AI模型进行「提示注入」!
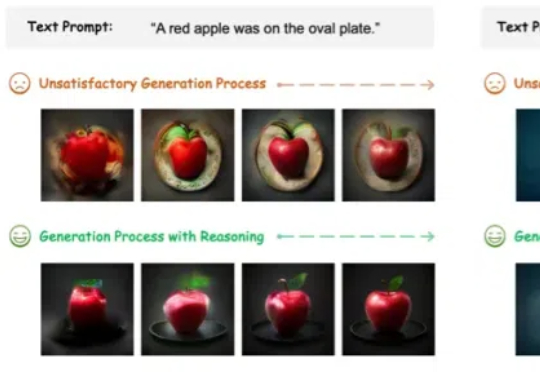
图像生成模型,也用上思维链(CoT)了!此外,作者还提出了两种专门针对该任务的新型奖励模型——潜力评估奖励模型。(Potential Assessment Reward Model,PARM)及其增强版本PARM++。
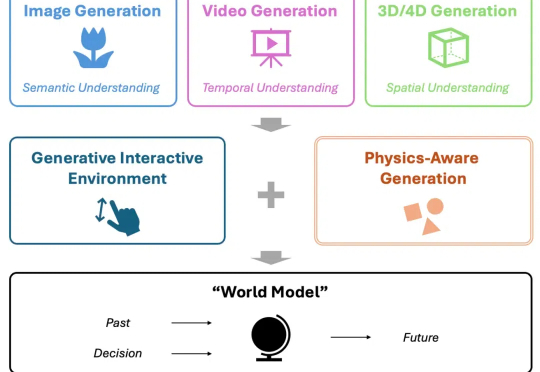
当下,视频生成备受关注,有望成为处理物理知识的 “世界模型” (World Model),助力自动驾驶、机器人等下游任务。然而,当前模型在从 “生成” 迈向世界建模的过程中,存在关键短板 —— 对真实世界物理规律的刻画能力不足。
当谷歌在 2018 年推出 BERT 模型时,恐怕没有料到这个 3.4 亿参数的模型会成为自然语言处理领域的奠基之作。
在过去的两年里,城市场景生成技术迎来了飞速发展,一个全新的概念 ——世界模型(World Model)也随之崛起。当前的世界模型大多依赖 Video Diffusion Models(视频扩散模型)强大的生成能力,在城市场景合成方面取得了令人瞩目的突破。然而,这些方法始终面临一个关键挑战:如何在视频生成过程中保持多视角一致性?
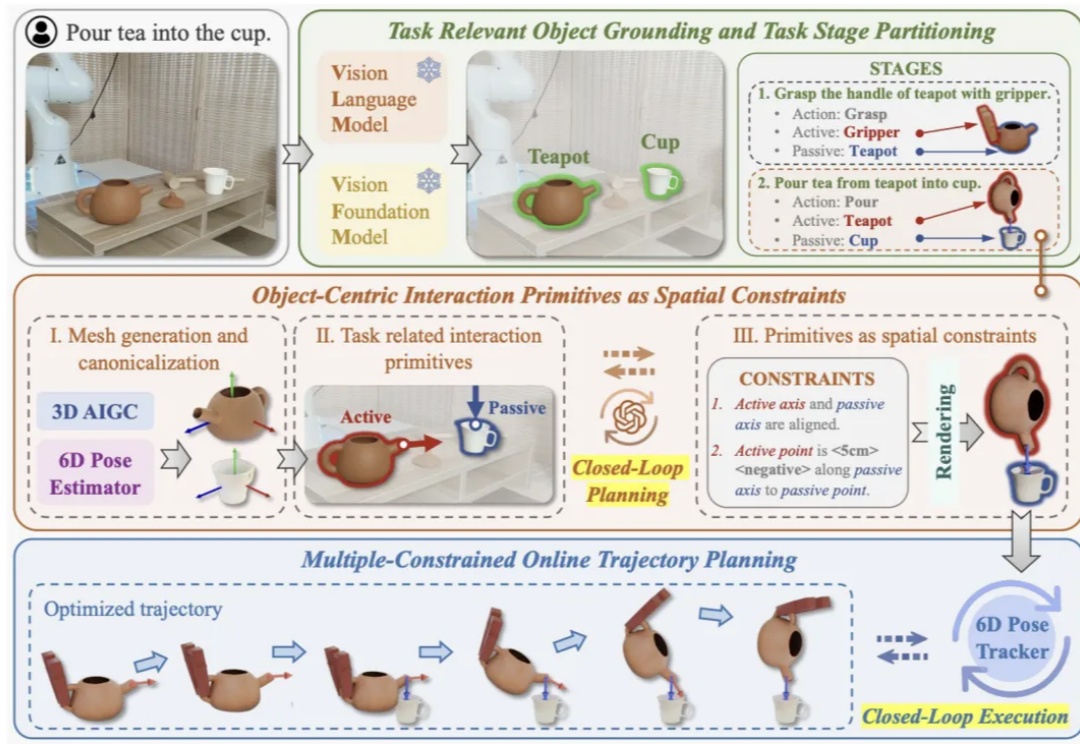
近年来视觉语⾔基础模型(Vision Language Models, VLMs)在多模态理解和⾼层次常识推理上⼤放异彩,如何将其应⽤于机器⼈以实现通⽤操作是具身智能领域的⼀个核⼼问题。这⼀⽬标的实现受两⼤关键挑战制约:
人类仅剩2-3年时间了!Anthropic首席执行官Dario Amodei独家采访,一口气爆料一连串AI重磅消息,并在最后给出了对于职场年轻人的建议。
AI 编程工具的发展令人目不暇接。从年初 Devin 这款被称为“首个真正的 AI工程师”的产品发布,到年中 Anthropic 在 Claude 3.5 Sonnet 模型推出「Artifacts」功能的重大突破,再到 Cursor、Windsurf 等新一代 IDE 的崛起,AI 正在重塑程序员的工作方式。