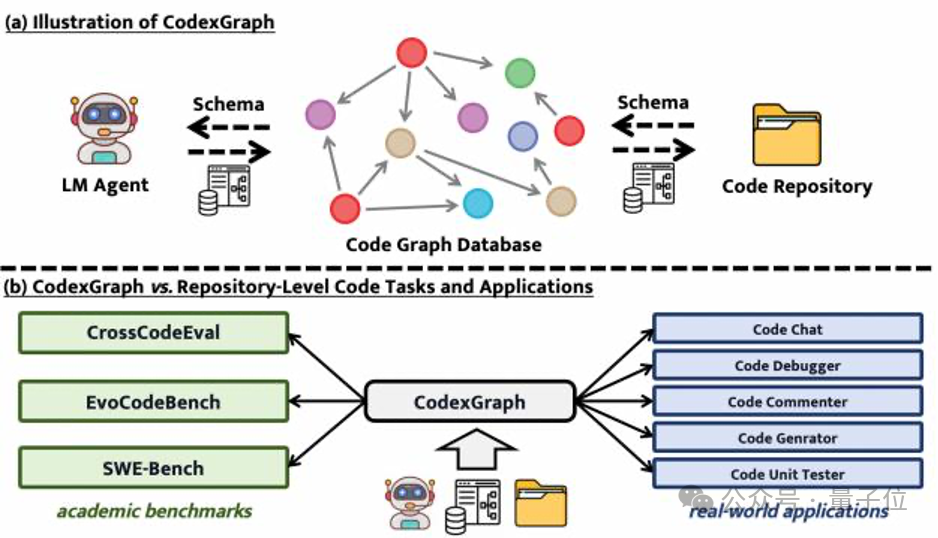
让AI管理大型代码库,开发者福音来了 | 阿里/新加坡国立/西安交大联合出品
让AI管理大型代码库,开发者福音来了 | 阿里/新加坡国立/西安交大联合出品代码生成和补全任务做不完了?!
来自主题: AI资讯
11429 点击 2024-08-11 17:18

 搜索
代码生成和补全任务做不完了?!
在过去的几年中,大型语言模型(Large Language Models, LLMs)在自然语言处理(NLP)领域取得了突破性的进展。这些模型不仅能够理解复杂的语境,还能够生成连贯且逻辑严谨的文本。
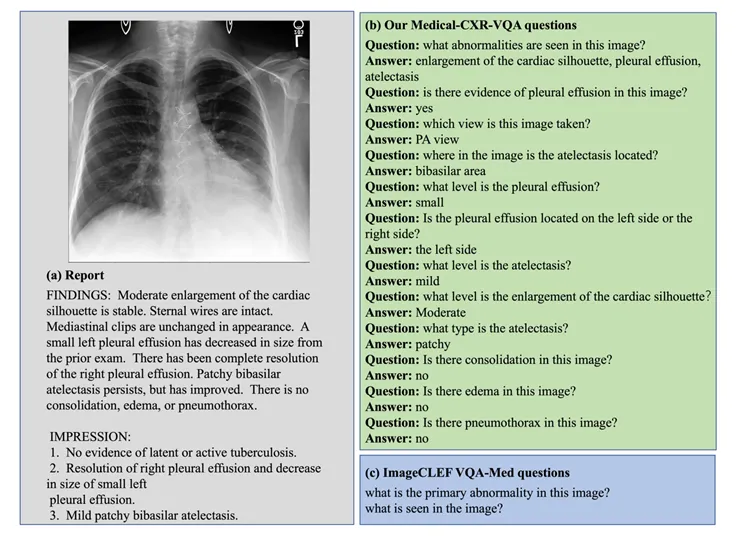
多模态大语言模型 (Multimodal Large Language Moodel, MLLM) 以其强大的语言理解能力和生成能力,在各个领域取得了巨大成功。
不开颅,把 ChatGPT 装进脑子里?
从前两年的百模大战到大语言模型 LLM(Large Language Model)的逐步落地应用,端侧AI始终是人工智能技术发展中至关重要的一环。 所谓的端侧AI,即用户在使用过程中不依赖云服务器,直接在终端设备本地使用AI服务。相比于ChatGPT4.0和最新推出的Llama3.1等依赖于云端接口的主流大语言模型,设备端边缘应用的紧凑模型有较强的私密性,也具有个性化操作和节省成本等诸多优势。

GitHub 推出的全新功能「GitHub Models」将有望加快 AI 工程师时代的到来。

为了解决这个问题,一些研究尝试通过强大的 Teacher Model 生成训练数据,来增强 Student Model 在特定任务上的性能。然而,这种方法在成本、可扩展性和法律合规性方面仍面临诸多挑战。在无法持续获得高质量人类监督信号的情况下,如何持续迭代模型的能力,成为了亟待解决的问题。
上线仅仅一天,GPT-4o的高级语音功能(Advanced Voice Mode)简直要被玩疯了。无数网友脑洞大开的疯狂测试,GPT-4o这边呢,不仅各种奇葩任务全盘接收,表现好到更是让不少人连连惊呼“Blow my mind”。

多模态大模型(Multimodal Large Language Models,MLLMs)在不同的任务中表现出了令人印象深刻的能力,尽管如此,这些模型在检测任务中的潜力仍被低估。
前谷歌科学家Yi Tay重磅推出「LLM时代的模型架构」系列博客,首篇博文的话题关于:基于encoder-only架构的BERT是如何被基于encoder-decoder架构的T5所取代的,分析了BERT灭绝的始末以及不同架构模型的优缺点,以史为鉴,对于未来的创新具有重要意义。