一手实测!文心X1/4.5 Turbo推理和多模态双双变强,还把模型成本降了6成?!
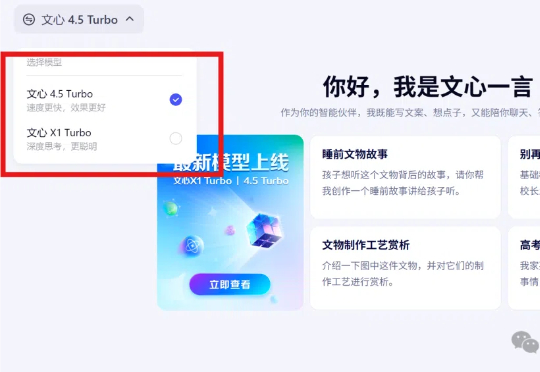
一手实测!文心X1/4.5 Turbo推理和多模态双双变强,还把模型成本降了6成?!就在刚刚,在Create 2025百度AI开发者大会上,李彦宏又一口气官宣了两款新模型:分别是主打深度思考和多模态的X1 Turbo/4.5 Turbo。据介绍,它们是百度在3月发布的旗舰模型X1、4.5的升级版,推理和多模态能力双双更跃Level。
搜索
就在刚刚,在Create 2025百度AI开发者大会上,李彦宏又一口气官宣了两款新模型:分别是主打深度思考和多模态的X1 Turbo/4.5 Turbo。据介绍,它们是百度在3月发布的旗舰模型X1、4.5的升级版,推理和多模态能力双双更跃Level。
「真格十问」是一个快问快答栏目。我们希望用十个问题,拆解可实操的产品成长方法,力求呈现「非共识但正确」的真知灼见。
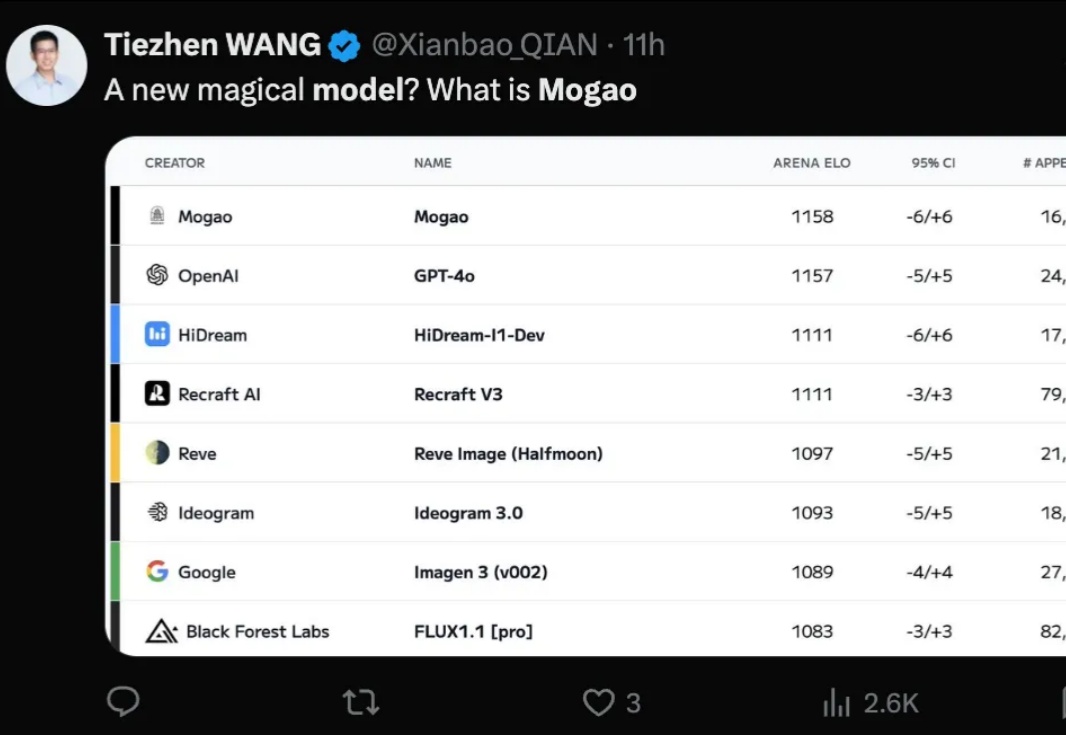
霸榜数天的神秘文生图模型 Mogao,什么来头?
近年来,大模型(Large Language Models, LLMs)在数学、编程等复杂任务上取得突破,OpenAI-o1、DeepSeek-R1 等推理大模型(Reasoning Large Language Models,RLLMs)表现尤为亮眼。但它们为何如此强大呢?
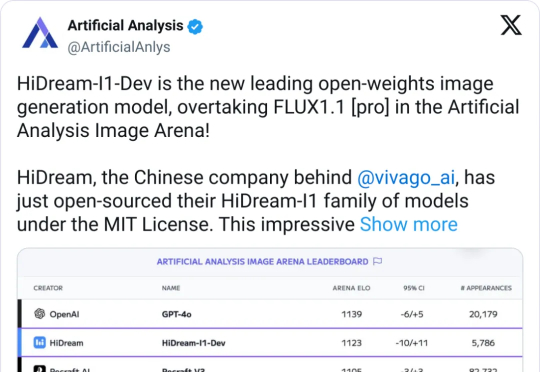
刚出道的 HiDream-I1,拿下了 Hugging Face 趋势榜第二(图像榜第一),Artificial Analysis 文生图第二,排在Midjourney、Google Imagen、FLUX、SDXL 之前,仅次于 GPT-4o 。
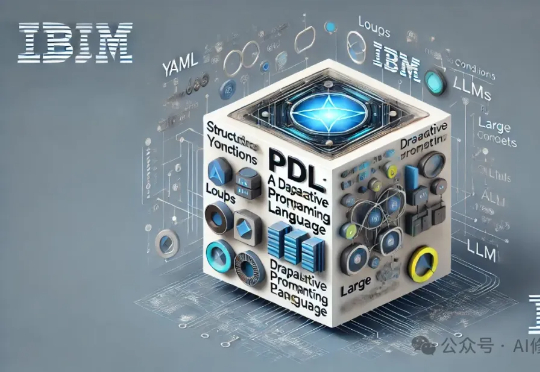
早在去年10月底IBM推出了PDL声明式提示编程语言,本篇是基于PDL的一种对Agent的自动优化方法,是工业界前沿的解决方案。当你在开发基于大语言模型的Agent产品时,是否曾经在提示模式选择和优化上浪费了大量时间?在各种提示模式(Zero-Shot、CoT、ReAct、ReWOO等)中选择最佳方案,再逐字斟酌提示内容,这一过程不仅耗时,而且常常依赖经验和直觉而非数据驱动的决策。
前段时间,GPT-4o 火出了圈,其断崖式提升的生图、改图能力让每个人都想尝试一下。虽然 OpenAI 后来宣布免费用户也可以用,但出图慢、次数受限仍然困扰着没有订阅 ChatGPT 的普通人。
前些天,GPT-4o的多模态生图上线之后,引发全球AI社区广泛的关注,吉卜力图画全网风靡。
千亿参数内最强推理大模型,刚刚易主了。32B——DeepSeek-R1的1/20参数量;免费商用;且全面开源——模型权重、训练数据集和完整训练代码,都开源了。这就是刚刚亮相的Skywork-OR1 (Open Reasoner 1)系列模型——
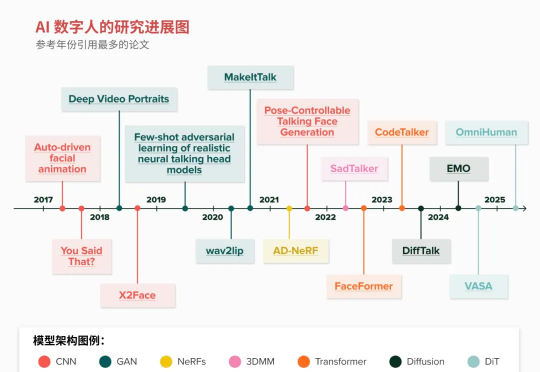
过去几年,AI 已经能生成逼真的图片、视频和声音,悄然通过视觉和听觉的图灵测试。但 2025 年最令人激动的突破之一,毫无疑问将是把这些方案集于一体的 AI 数字人(Al Avatar)。