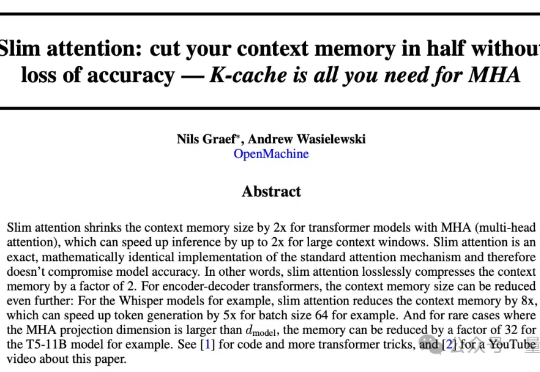
新注意力让大模型上下文内存占用砍半!精度不减还能加速2倍
新注意力让大模型上下文内存占用砍半!精度不减还能加速2倍大模型同样的上下文窗口,只需一半内存就能实现,而且精度无损? 前苹果ASIC架构师Nils Graef,和一名UC伯克利在读本科生一起提出了新的注意力机制Slim Attention。
来自主题: AI资讯
8880 点击 2025-03-17 19:52

 搜索
大模型同样的上下文窗口,只需一半内存就能实现,而且精度无损? 前苹果ASIC架构师Nils Graef,和一名UC伯克利在读本科生一起提出了新的注意力机制Slim Attention。
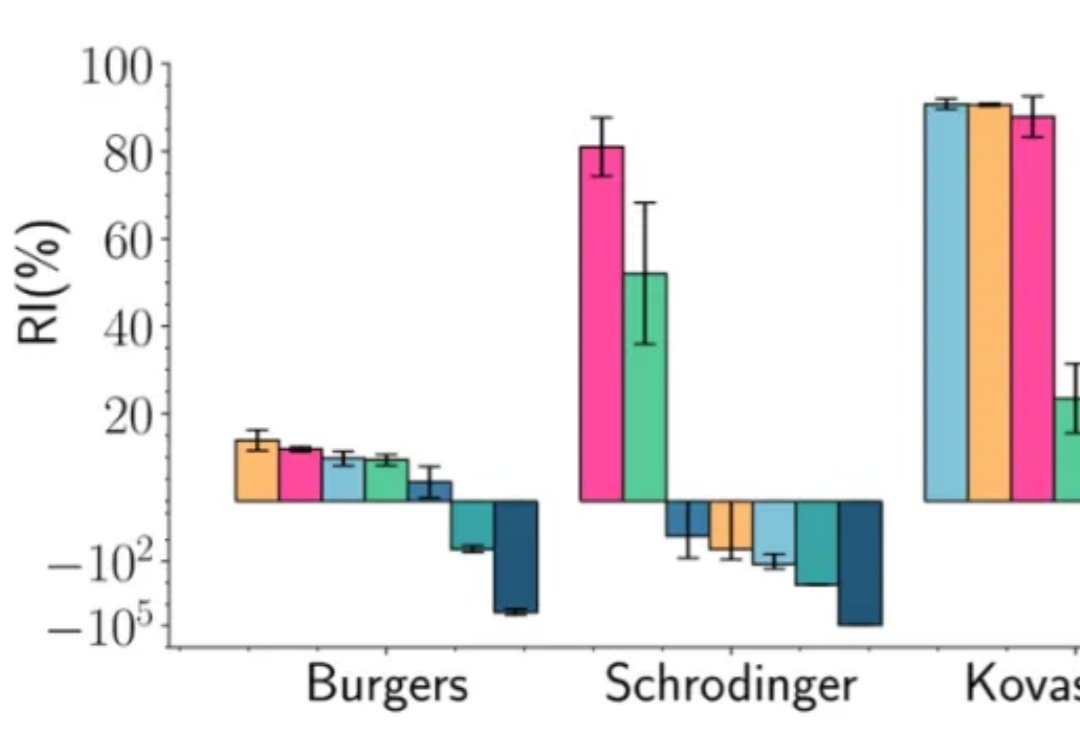
在深度学习的多个应用场景中,联合优化多个损失项是一个普遍的问题。典型的例子包括物理信息神经网络(Physics-Informed Neural Networks, PINNs)、多任务学习(Multi-Task Learning, MTL)和连续学习(Continual Learning, CL)。然而,不同损失项的梯度方向往往相互冲突,导致优化过程陷入局部最优甚至训练失败。
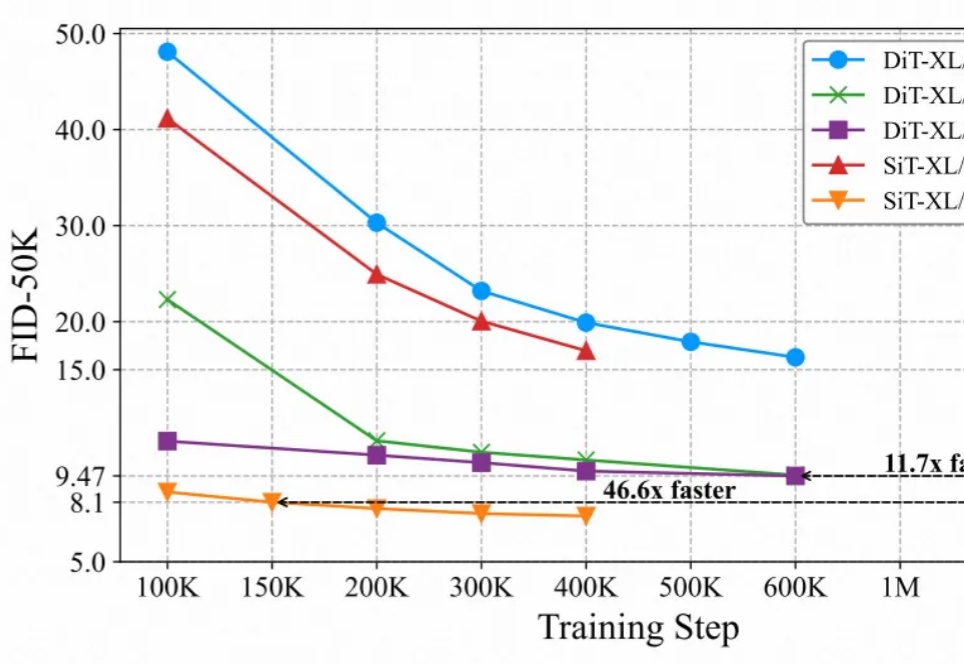
最近的研究强调了扩散模型与表征学习之间的相互作用。扩散模型的中间表征可用于下游视觉任务,同时视觉模型表征能够提升扩散模型的收敛速度和生成质量。然而,由于输入不匹配和 VAE 潜在空间的使用,将视觉模型的预训练权重迁移到扩散模型中仍然具有挑战性。
「压缩即智能」。这并不是一个新想法,著名 AI 研究科学家、OpenAI 与 SSI 联合创始人 Ilya Sutskever 就曾表达过类似的观点。

语音Agent市场在2024年下半年迎来爆发式增长。据Cartesia统计,在最新一届YC中,构建语音相关产品的公司占比达22%。

AI工业3D设计领域,还存在着无限的想象空间。
DiffRhythm是一款新型AI音乐生成模型,能在10秒内生成长达4分45秒的完整歌曲,包含人声和伴奏。它采用简单高效的全diffusion架构,仅需歌词和风格提示即可创作,还支持本地部署,最低只需8G显存。
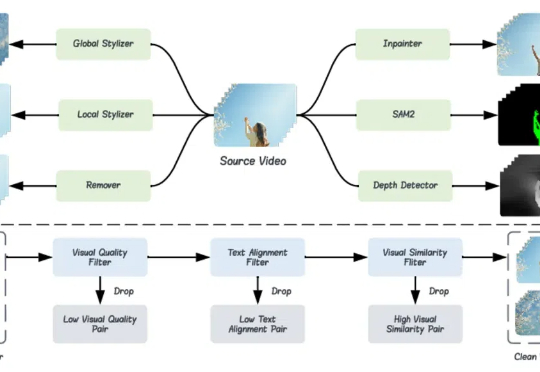
为了解决视频编辑模型缺乏训练数据的问题,本文作者(来自香港中文大学、香港理工大学、清华大学等高校和云天励飞)提出了一个名为 Señorita-2M 的数据集。该数据集包含 200 万高质量的视频编辑对,囊括了 18 种视频编辑任务。
我总是对工具保持警惕。真正有价值的工具应该像好的助手一样,它们存在于背景中,却能显著提升你的能力。对我来说,Obsidian和Claude就是这样的存在——重剑无锋,大巧不工。
从随机残基分布开始,逐步生成新的蛋白质结构