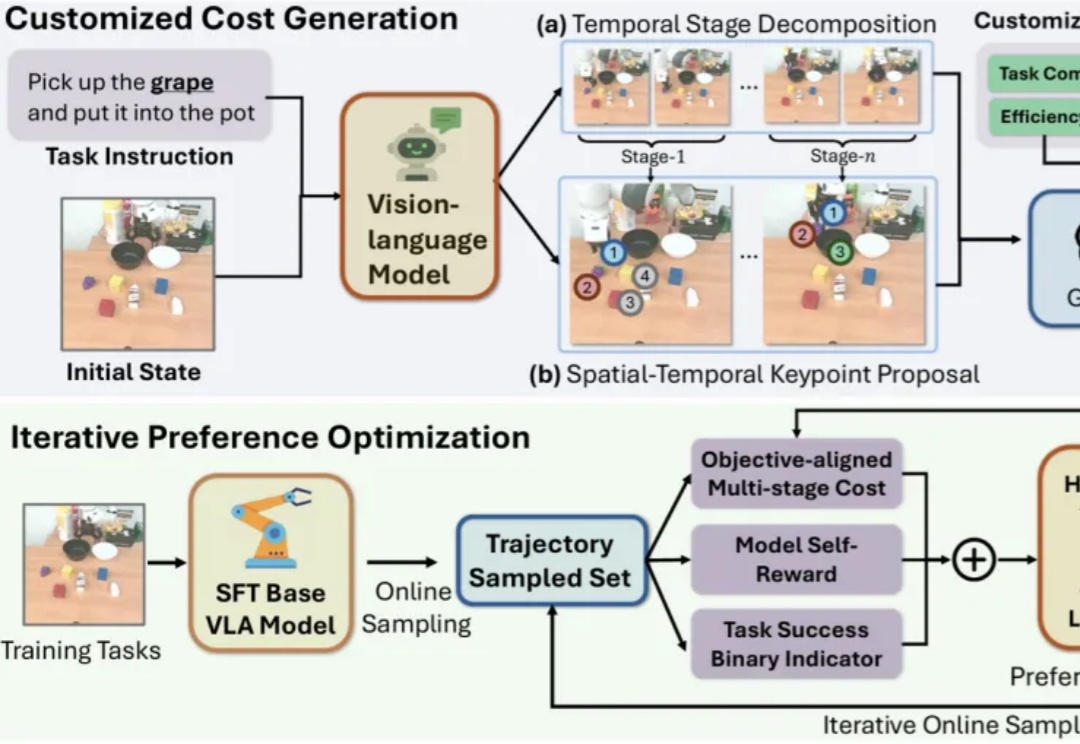
把RLHF带给VLA模型!通过偏好对齐来优化机器人策略,代码已开源
把RLHF带给VLA模型!通过偏好对齐来优化机器人策略,代码已开源近年来,视觉-语言-动作模型(Vision-Language-Action, VLA)在诸多机器人任务上取得了显著的进展,但它们仍面临一些关键问题,例如由于仅依赖从成功的执行轨迹中进行行为克隆,导致对新任务的泛化能力较差。
来自主题: AI技术研报
9808 点击 2024-12-28 11:41

 搜索
近年来,视觉-语言-动作模型(Vision-Language-Action, VLA)在诸多机器人任务上取得了显著的进展,但它们仍面临一些关键问题,例如由于仅依赖从成功的执行轨迹中进行行为克隆,导致对新任务的泛化能力较差。
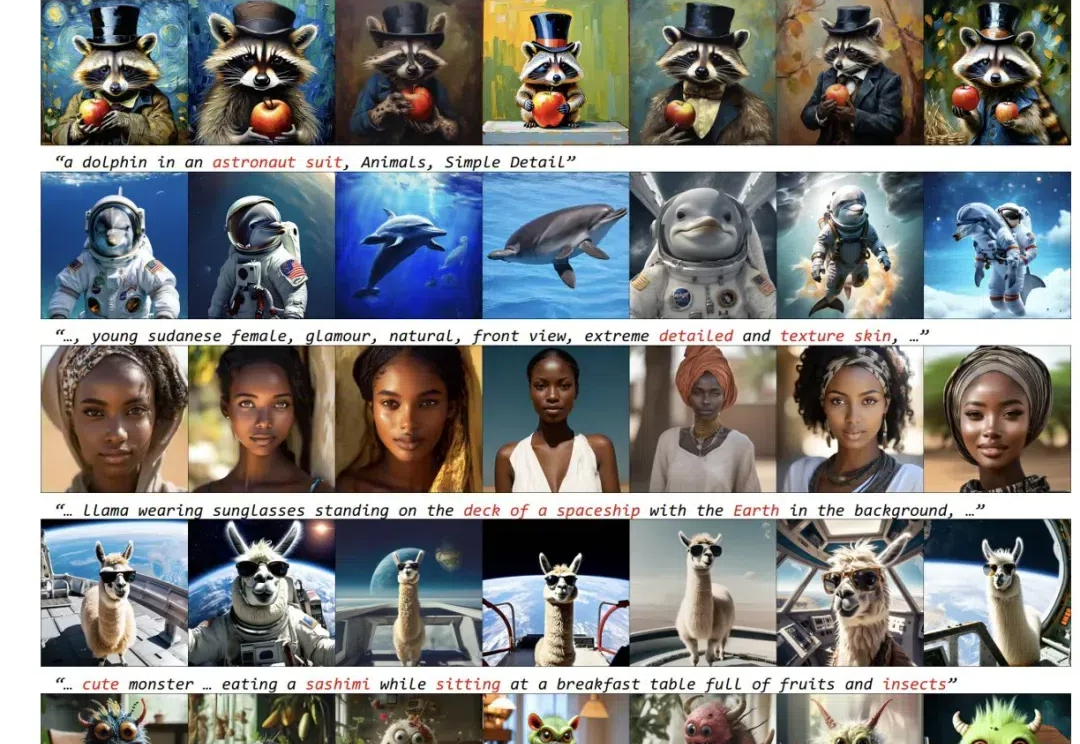
近些年来,以 Stable Diffusion 为代表的扩散模型为文生图(T2I)任务树立了新的标准,PixArt,LUMINA,Hunyuan-DiT 以及 Sana 等工作进一步提高了图像生成的质量和效率。然而,目前的这些文生图(T2I)扩散模型受限于模型尺寸和运行时间,仍然很难直接部署到移动设备上。
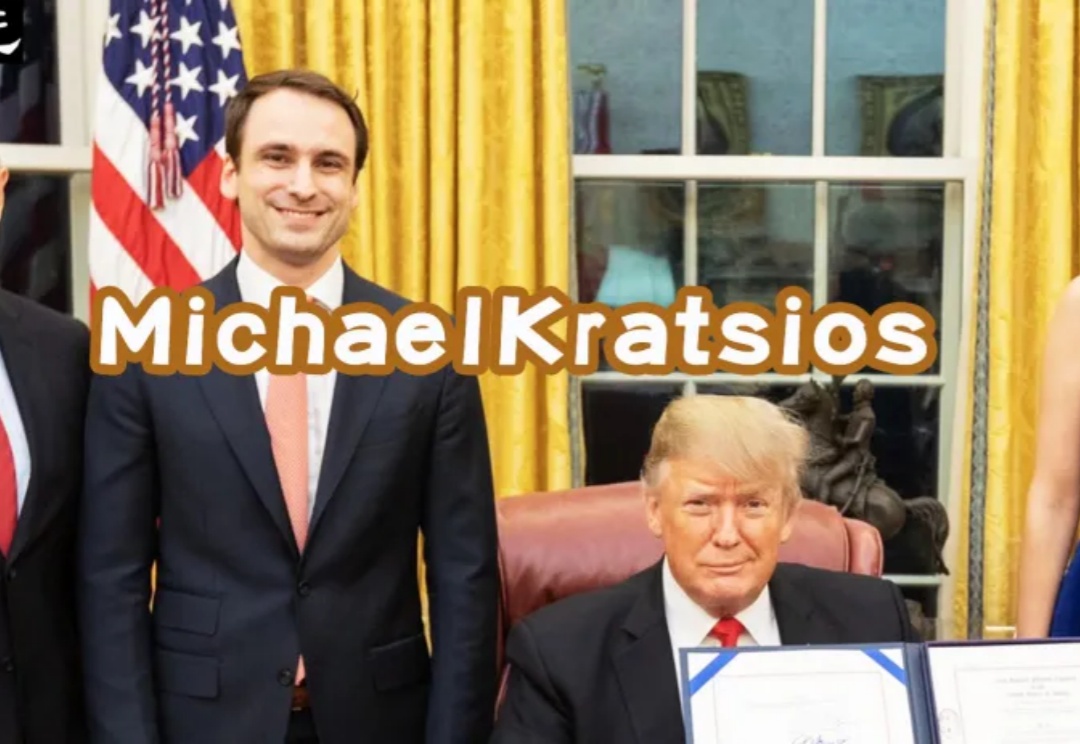
斯坦福HAI的研究员Michael Kratsios,被任命为白宫科技政策办公室主任,及特朗普政府的总统科技助理。从马斯克、AI沙皇到HAI研究员,这几轮任命彰显出:美国开始在国家层面推动科技政策发展,大力发展AI。
近年来,日本动漫的全球领导地位正遭遇挑战。有数据显示韩国的Line Manga和Piccoma已经超越Jump+,占据了亚太地区60%以上的数字漫画市场份额。日本动漫这个曾被誉为动漫界“珠穆朗玛峰”的存在,正受到移动端平台和AIGC带来的生产力突破而发生巨大的变化。
老iPhone又能再战一年。

12 月 22 日消息,据《南华早报》今日报道,香港中文大学(CUHK)的研究人员开发了一种新的基础人工智能模型,能够帮助解决眼科临床任务,特别是在疾病筛查和诊断方面。随着生成式 AI 在医学领域的应用逐步增多,这一技术有望带来更广泛的影响。
用户的模糊意图通过会话的方式来逐步与 AI 对焦、拆解,而用户的各项操作指令通常也以交互式卡片的形式贯穿于会话流之中。
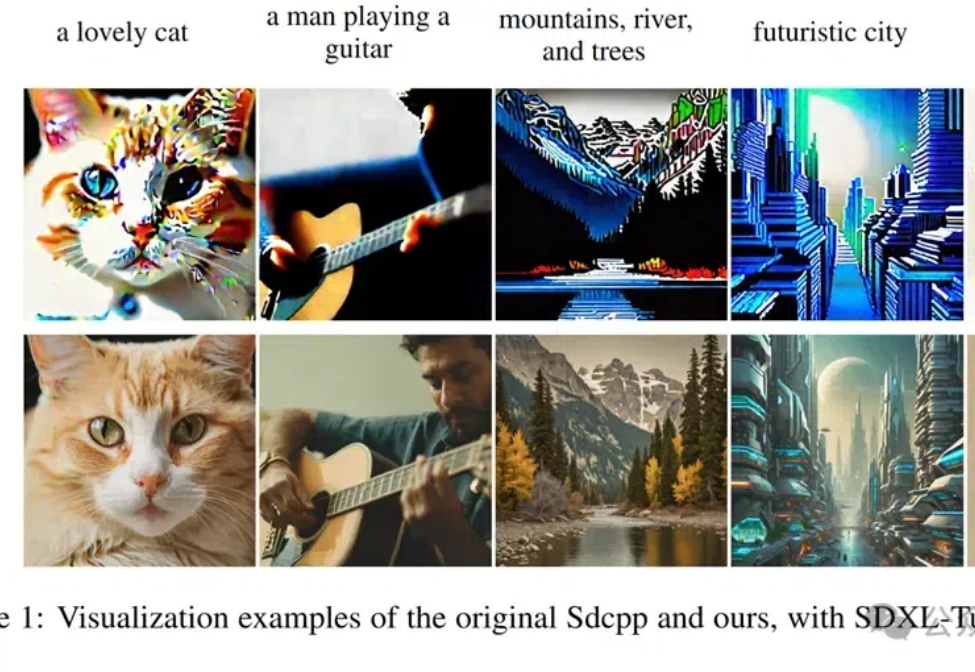
北京大学等研究团队优化了Sdcpp框架,通过引入Winograd算法和多项策略,显著提升了图像生成速度和内存效率,最高可提速4.79倍。
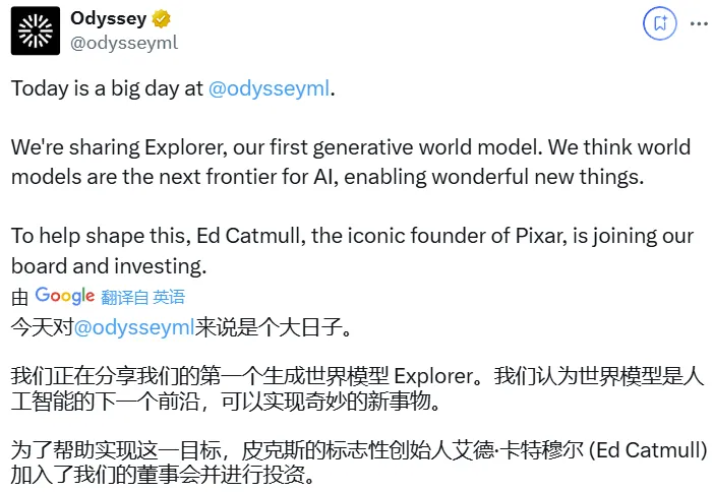
近段时间,世界模型的相关研究成果正如雨后春笋版不断涌现,光是我们报道过的就已有南大周志华团队的世界模型 Whale、Yann LeCun 团队的世界模型研究、李飞飞 World Labs 的空间智能研究、谷歌的强大世界模型 Genie 2 以及刚刚开源的像是能模拟万物的生成式物理引擎 Genesis。
豆包的“眼睛”升级了,现在让它看一眼APP截图,就能直接给你生成代码!