不用微调训练?不用参考图像?英伟达开源ConsiStory直接输出一致性图片
不用微调训练?不用参考图像?英伟达开源ConsiStory直接输出一致性图片文本到图像的生成模型让创作更加灵活,用户可以用自然语言引导生成图像。
来自主题: AI技术研报
6801 点击 2024-11-15 10:29

 搜索
文本到图像的生成模型让创作更加灵活,用户可以用自然语言引导生成图像。

今日凌晨,Stability AI 发布了 Stable Diffusion 3.5 的提示指南。该指南提供了 Stable Diffusion 3.5 的实用提示技巧,让使用者能够快速准确地完善图像概念,更好地使用 Stable Diffusion 3.5 这一在可定制性、高效性能、多样化输出和多功能风格方面均表现出色的模型。
Ilya终于承认,自己关于Scaling的说法错了!现在训练模型已经不是「越大越好」,而是找出Scaling的对象究竟应该是什么。他自曝,SSI在用全新方法扩展预训练。而各方巨头改变训练范式后,英伟达GPU的垄断地位或许也要打破了。
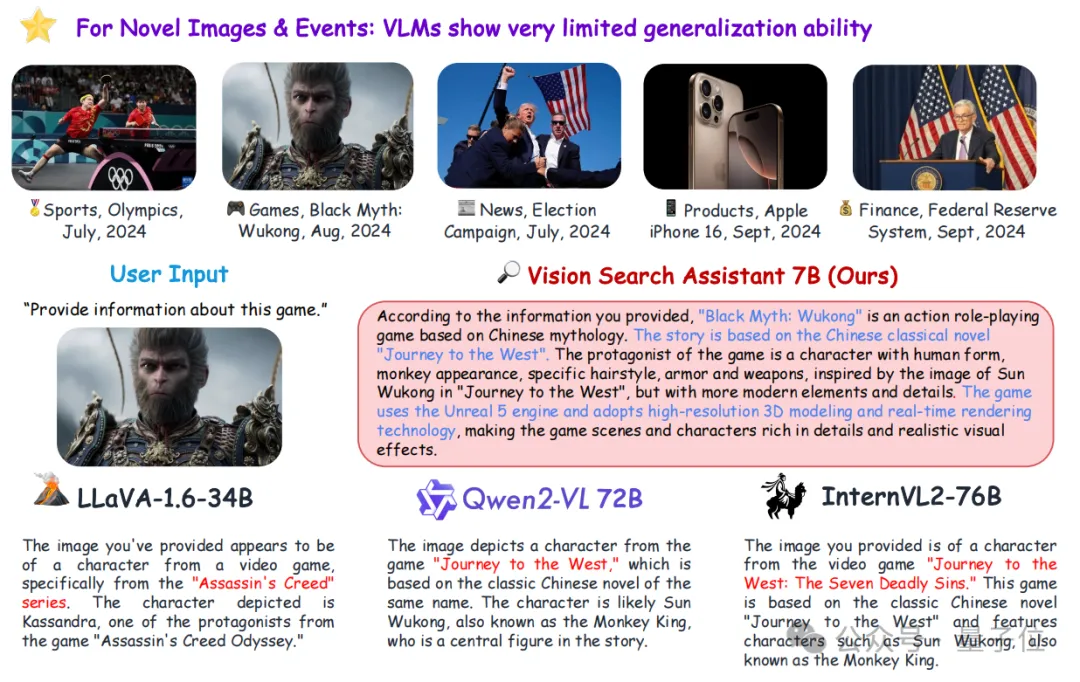
OpenAI推出SearchGPT没几天,开源版本也来了。 港中文MMLab、上海AI Lab、腾讯团队简易实现了Vision Search Assistant,模型设计简单,只要两张RTX3090就可复现。
在全球科技市场的前沿浪潮中,AI 与硬件的融合正成为企业创新的关键路径。从苹果的 Vision Pro 到 Meta 的智能拍摄眼镜,众多科技巨头纷纷投身于将大模型、多模态 AI 等顶尖技术与消费级硬件相结合的探索之旅。
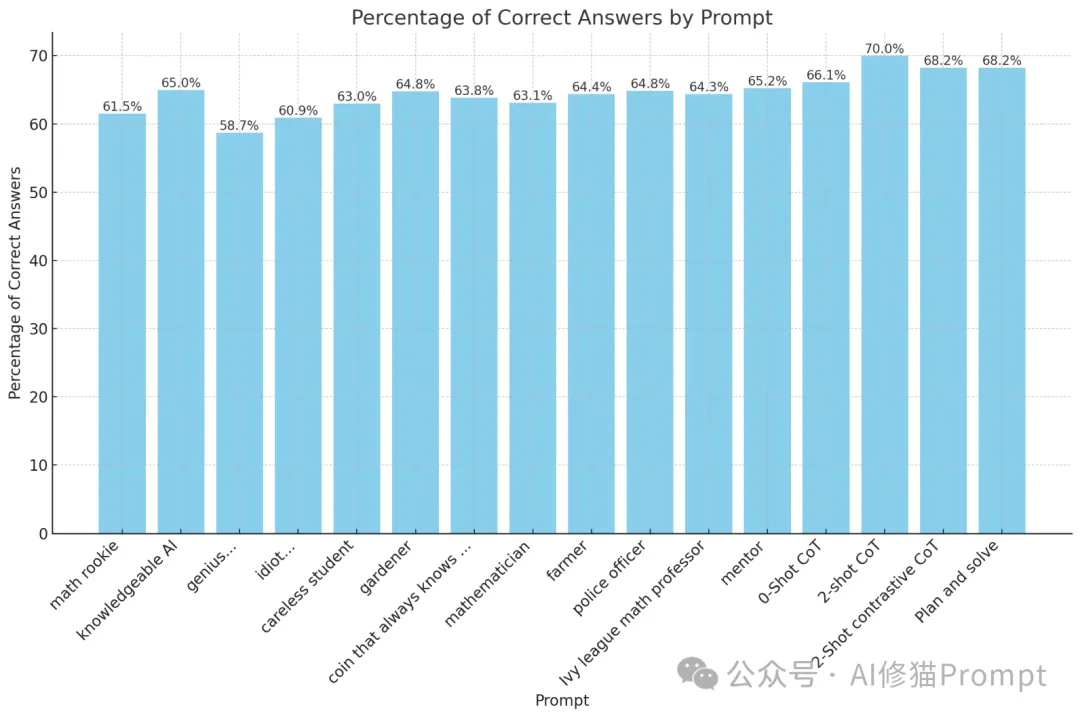
在Prompt工程领域,角色扮演提示是否能够有效提高大型语言模型(LLM)的性能一直是一个备受关注的话题。
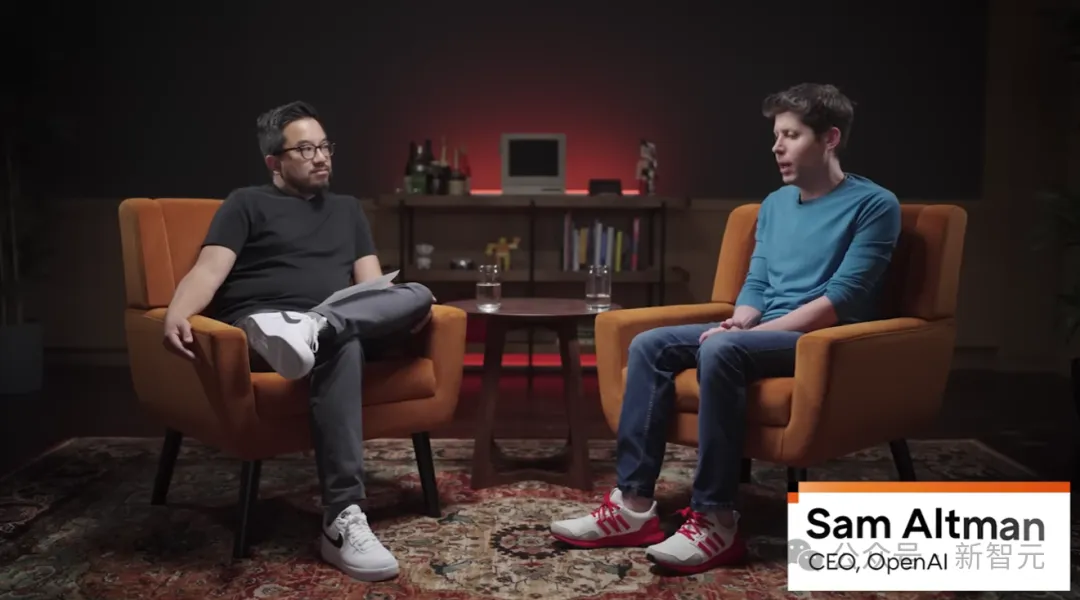
AGI 2025年到来,ASI几千天内降临,奥特曼在最新专访中金句频出。不仅如此,他的话还得到了德扑之父、自家员工的证实。
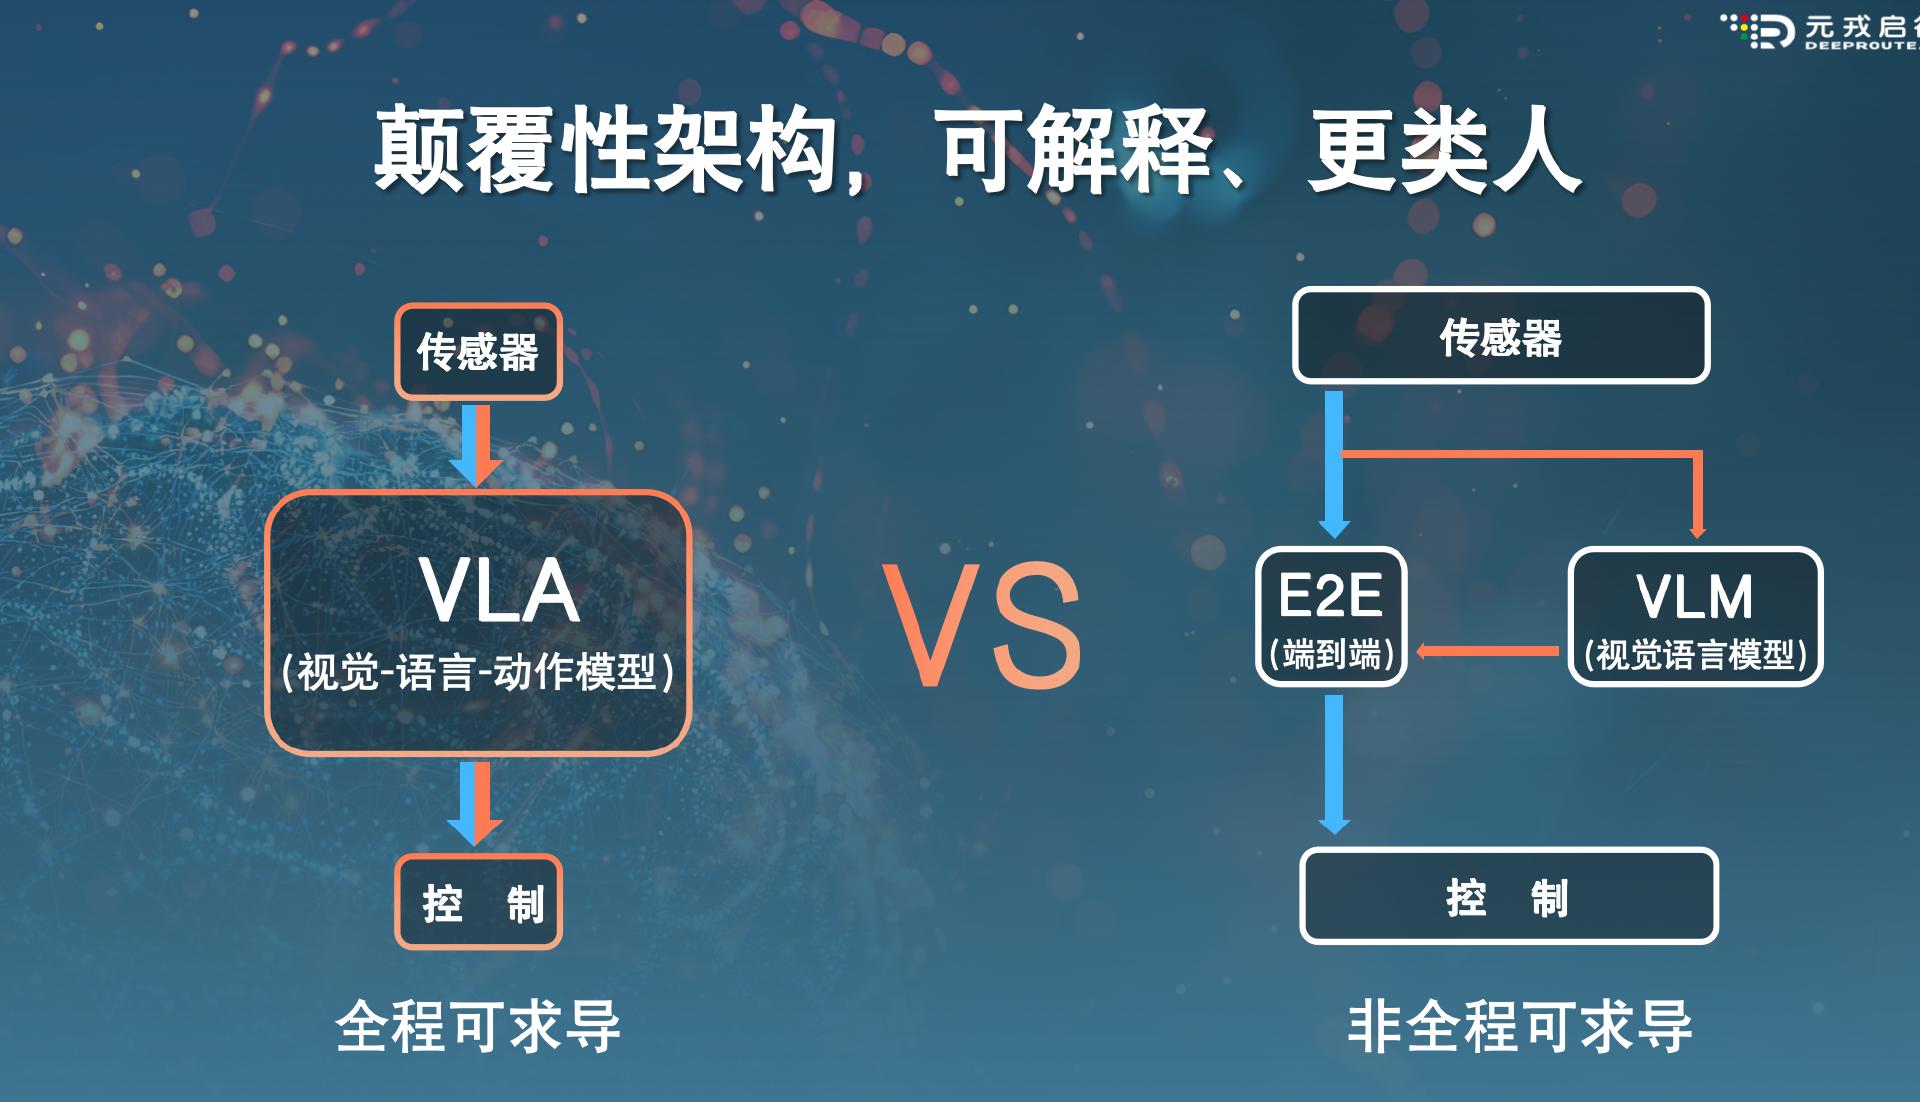
近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
计算机视觉(Computer Vision)的工作原理与人类视觉类似,但需要机器依靠摄像头、数据和算法在很短的时间内完成任务。
近日,关于 Open AI 被投企业 Physical Intelligence (PI) 的一系列报道,让人们关注到具身智能大模型引发的机器人时代变革。