大规模、动态「语音增强/分离」新基准!清华发布移动音源仿真平台SonicSim,含950+小时训练数据
大规模、动态「语音增强/分离」新基准!清华发布移动音源仿真平台SonicSim,含950+小时训练数据清华大学推出的SonicSim平台和SonicSet数据集针对动态声源的语音处理研究提供了强有力的工具和数据支持,有效降低了数据采集成本,实验证明这些工具能有效提升模型在真实环境中的性能。
来自主题: AI技术研报
5780 点击 2024-10-31 14:41

 搜索
清华大学推出的SonicSim平台和SonicSet数据集针对动态声源的语音处理研究提供了强有力的工具和数据支持,有效降低了数据采集成本,实验证明这些工具能有效提升模型在真实环境中的性能。
据 TechCrunch 报道,Sierra 由 OpenAI 主席布雷特·泰勒共同创办的人工智能初创公司,在一轮融资中筹集了 1.75 亿美元,估值为 45 亿美元。
前几天在对战平台Artificial Analysis出现了一个神秘的文生图模型"red_panda",而且排行位列第一,超过之前火爆的Flux 1.1 [pro]模型。
有了 TEN(Transformative Extensions Network,变革性扩展网络),开发者们终于不用再「绞尽脑汁」了!TEN 是全球首个真正实现实时多模态智能体的框架,不仅能减少开发痛点,还让你轻松从头开始构建下一代 AI 应用。
最近,在全球人工智能模型竞技场(Artificial Analysis)文生图模型排行榜中,一个名叫Red_panda的新模型突然杀出重围,以9%的胜率超越了原榜一大哥Flux1.1Pro成为新王!
人工智能领域的开源问题一直存在,其中最大的争议点是到底什么样的人工智能可以称之为“开源”。开放源代码倡议(OSI)作为业内公认的开源仲裁机构,二十五年来一直负责管理开放源代码定义 (OSD)。在过去两三年中,OSI 致力于为开源 AI 制定定义和标准,以构建可供任何人用于研究、修改和共享的 AI 系统。
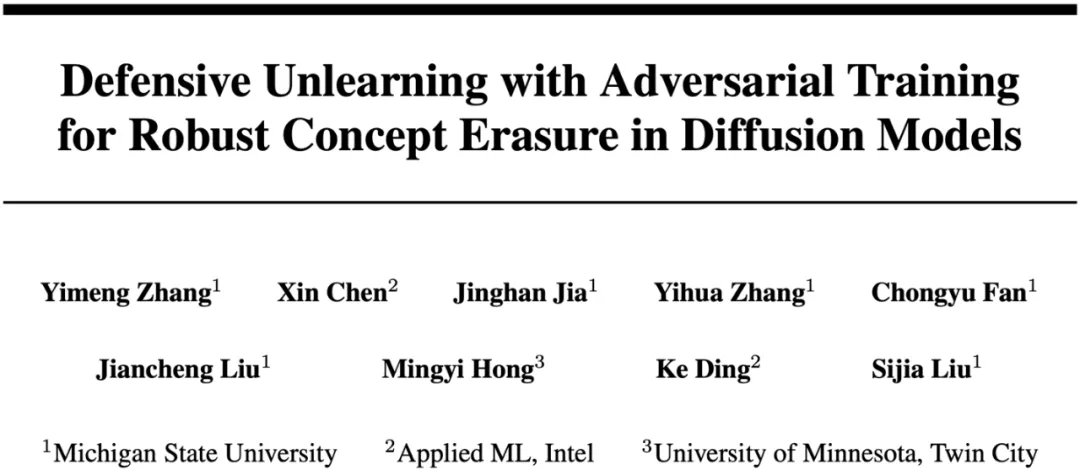
扩散模型(Diffusion Models, DMs)已经成为文本到图像生成领域的核心技术之一。凭借其卓越的性能,这些模型可以生成高质量的图像,广泛应用于各类创作场景,如艺术设计、广告生成等。
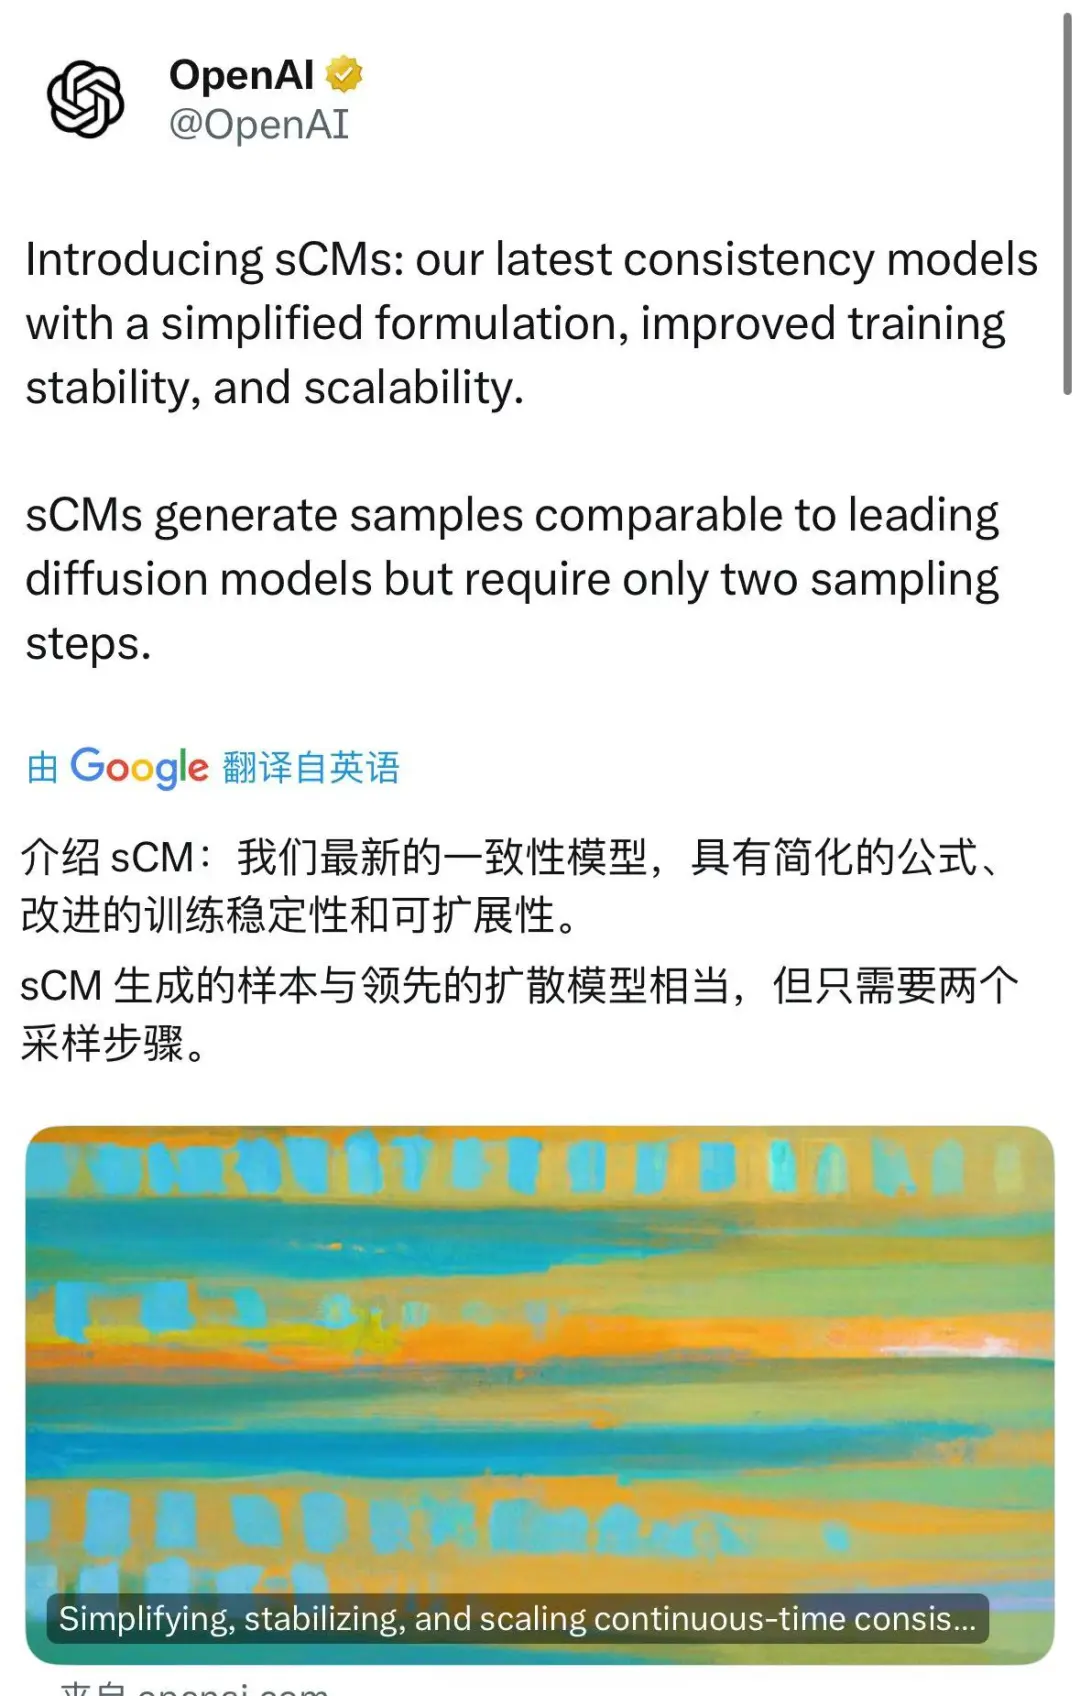
家人们,OpenAI 又上新了!推出了全新的生成式模型sCM(Simplifying Continuous-Time Consistency Models),支持视频、图像、三维模型和音频的生成。
没错,就是CPU——Central Processing Unit,中央处理器。
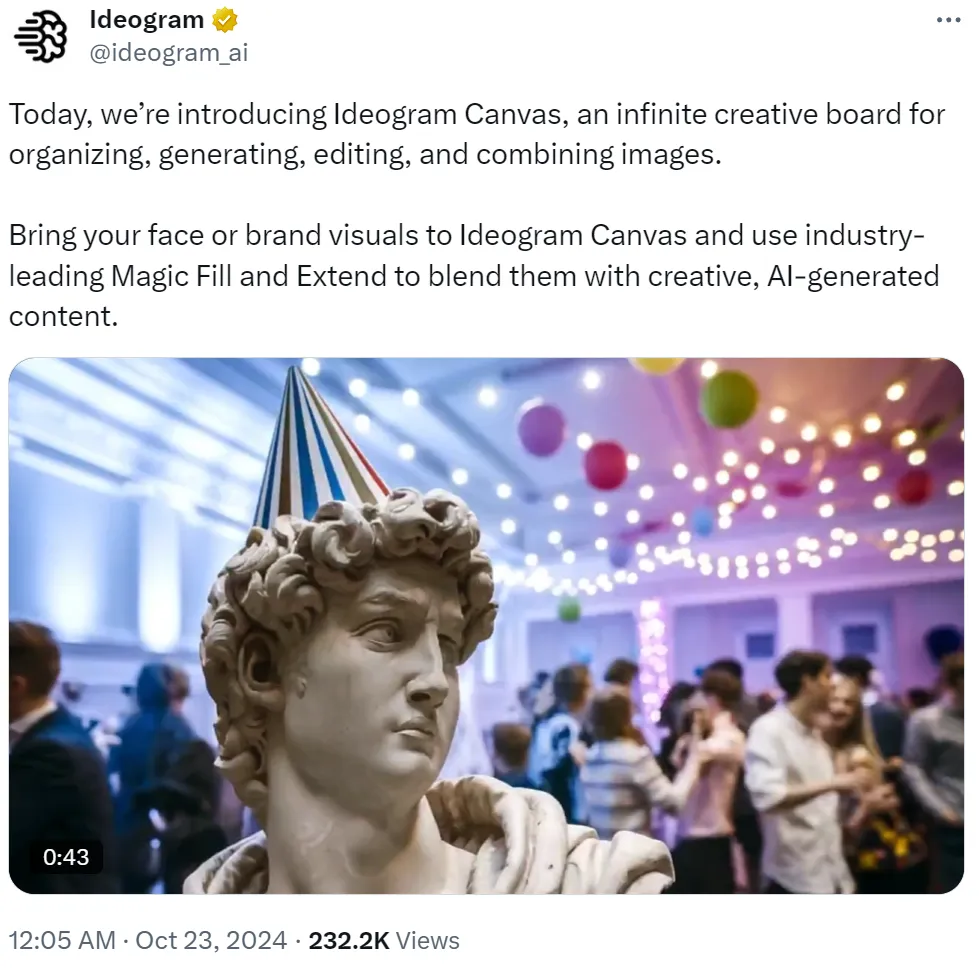
过去 24 小时内发布或更新的 AI 服务包括但不限于 Stable Diffusion 3.5 最强模型全家桶、能操作用户电脑的 Claude 3.5 Sonnet、Genmo 开源的可商用的 Mochi 1 DiT、Runway 推出的一款生成式角色表演工具…… 以及我们这里要介绍 Ideogram Canvas,一款基于 AI 的无限创意画板服务,可用于组织、生成、编辑和组合图像。