陈丹琦团队新作:微调8B模型超越Claude3 Opus,背后是RLHF新平替
陈丹琦团队新作:微调8B模型超越Claude3 Opus,背后是RLHF新平替比斯坦福DPO(直接偏好优化)更简单的RLHF平替来了,来自陈丹琦团队。 该方式在多项测试中性能都远超DPO,还能让8B模型战胜Claude 3的超大杯Opus。 而且与DPO相比,训练时间和GPU消耗也都大幅减少。
来自主题: AI资讯
11273 点击 2024-05-27 16:39

 搜索
比斯坦福DPO(直接偏好优化)更简单的RLHF平替来了,来自陈丹琦团队。 该方式在多项测试中性能都远超DPO,还能让8B模型战胜Claude 3的超大杯Opus。 而且与DPO相比,训练时间和GPU消耗也都大幅减少。
TinyLLaVA 项目由清华大学电子系多媒体信号与智能信息处理实验室 (MSIIP) 吴及教授团队和北京航空航天大学人工智能学院黄雷老师团队联袂打造。清华大学 MSIIP 实验室长期致力于智慧医疗、自然语言处理与知识发现、多模态等研究领域。北航团队长期致力于深度学习、多模态、计算机视觉等研究领域。

为了将大型语言模型(LLM)与人类的价值和意图对齐,学习人类反馈至关重要,这能确保它们是有用的、诚实的和无害的。在对齐 LLM 方面,一种有效的方法是根据人类反馈的强化学习(RLHF)。尽管经典 RLHF 方法的结果很出色,但其多阶段的过程依然带来了一些优化难题,其中涉及到训练一个奖励模型,然后优化一个策略模型来最大化该奖励。
大模型公司洗牌期开始了。 突然之间,几家明星初创纷纷传出消息,寻求收购。都是大家熟悉的名字、过往战绩也都不错:Adept,估值超10亿美元,由Transformer作者创立;Humane,估值7.5-10亿美元,打造出爆火AI新硬件AI Pin;Stability AI,Stable Diffusion打造者,最早一批AI独角兽。

只需上传一张照片,就能瞬间变换身份,获得高精度个人写真! 或是科幻电影中的超级英雄,或是穿越时空的复古角色…… 李飞飞在家做饭的样子有了,还有让斯嘉丽一键带圣诞帽。
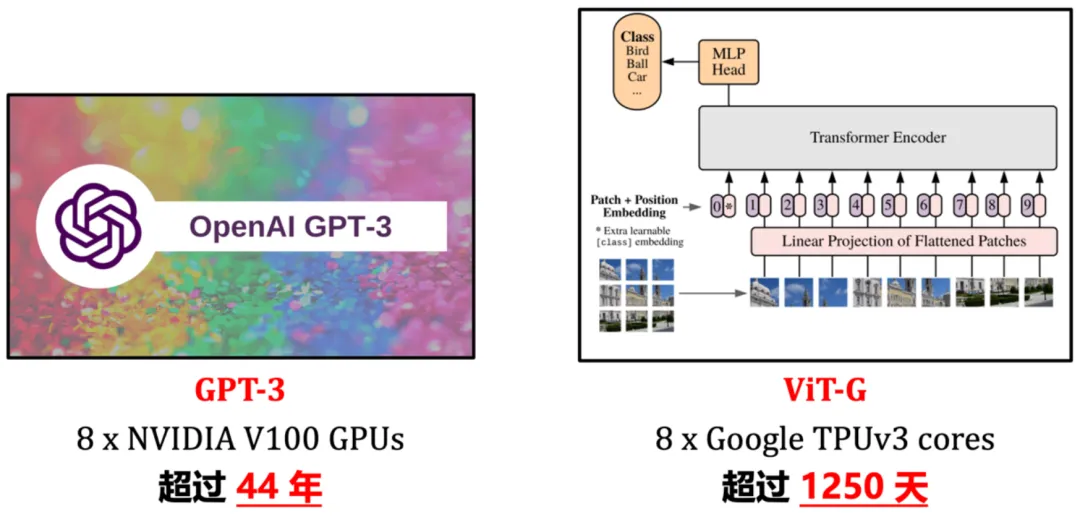
近年来,「scaling」是计算机视觉研究的主角之一。随着模型尺寸和训练数据规模的增大、学习算法的进步以及正则化和数据增强等技术的广泛应用,通过大规模训练得到的视觉基础网络(如 ImageNet1K/22K 上训得的 Vision Transformer、MAE、DINOv2 等)已在视觉识别、目标检测、语义分割等诸多重要视觉任务上取得了令人惊艳的性能。
大语言模型可谓是迄今为止对人类行为最大的建模,如何借助大语言模型工具,让科技发展更好地应用到真实人类社会中去?从哈佛物理系到大语言模型结合社会学和经济学的研究,朱科航的思考路径,聚焦在对人类行为的深度学习和理解。在开始今天阅读之前,大家不妨先猜一猜,大语言模型之前人类应用最广的 TOP2 机器学习是什么?Enjoy
曾经创造出Stable Diffusion系列模型的Stability AI,目前面临前所未有的财务危机。
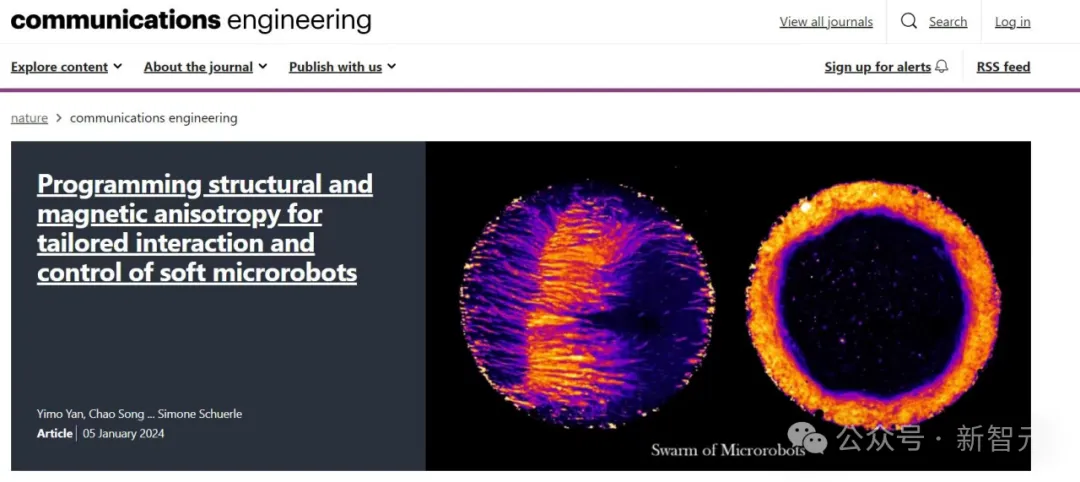
日前,北京大学智能学院可视计算与学习实验室陈宝权教授团队与苏黎世联邦理工学院健康科技系转化医学研究所Simone Schürle-Finke教授团队展开合作,首次使用物理模拟技术辅助可编程磁性微米级机器人的制造。
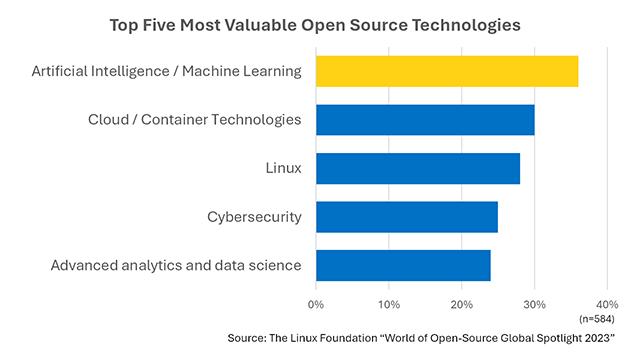
开源TinyML好处多