1分钱9张图!DeepSeek视觉模型连夜实测
1分钱9张图!DeepSeek视觉模型连夜实测等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
来自主题: AI产品测评
10835 点击 2026-08-22 14:27

 搜索
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
DeepSeek 终于「开眼」了。就在刚刚,DeepSeek 推出了一款面向 Agent 时代的多模态模型:deepseek-v4-flash-vision-exp。目前,该模型已经上线 DeepSeek API 平台上,用户可以通过设置 model='deepseek-v4-flash-vision-exp' 访问该模型。
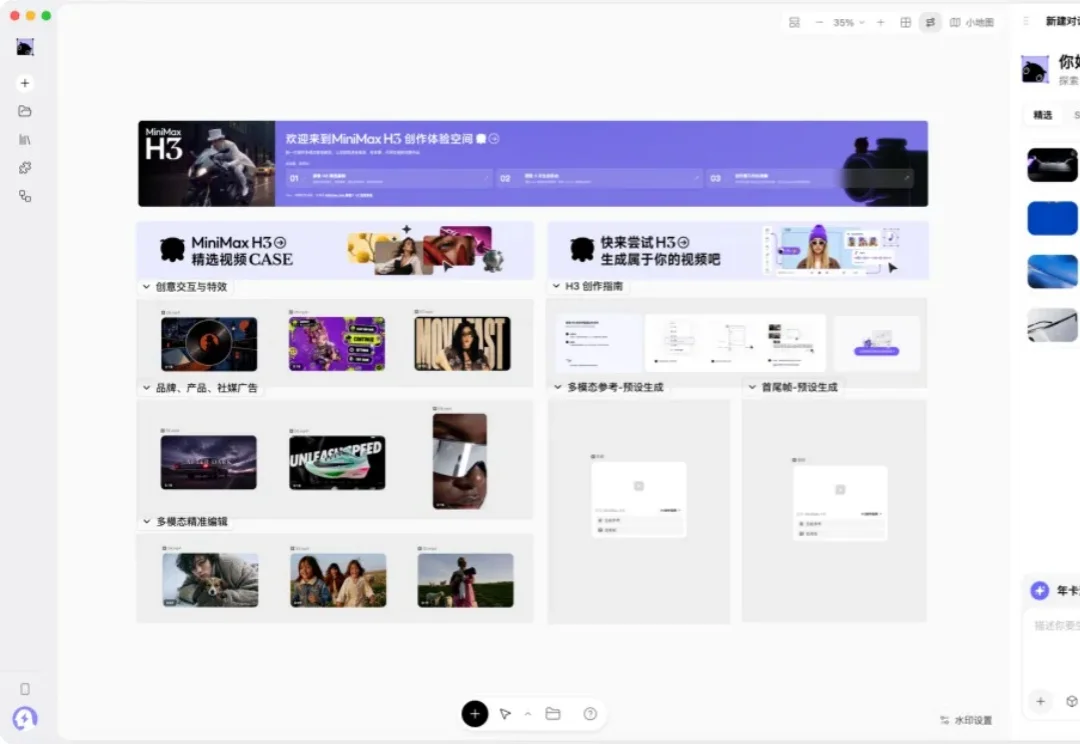
当一个视频模型和 Seedance 2.5 同一天发布,似乎大概率要成炮灰,但 MiniMax H3 却成了一个例外。而现在 MiniMax 也开始把这种模型的能力,放到了具体的产品上,正式推出了 MiniMax Design,进一步把 H3 视频模型的能力放大,同时也让我们少折腾一些,可以更高效地制作各种商业化内容。
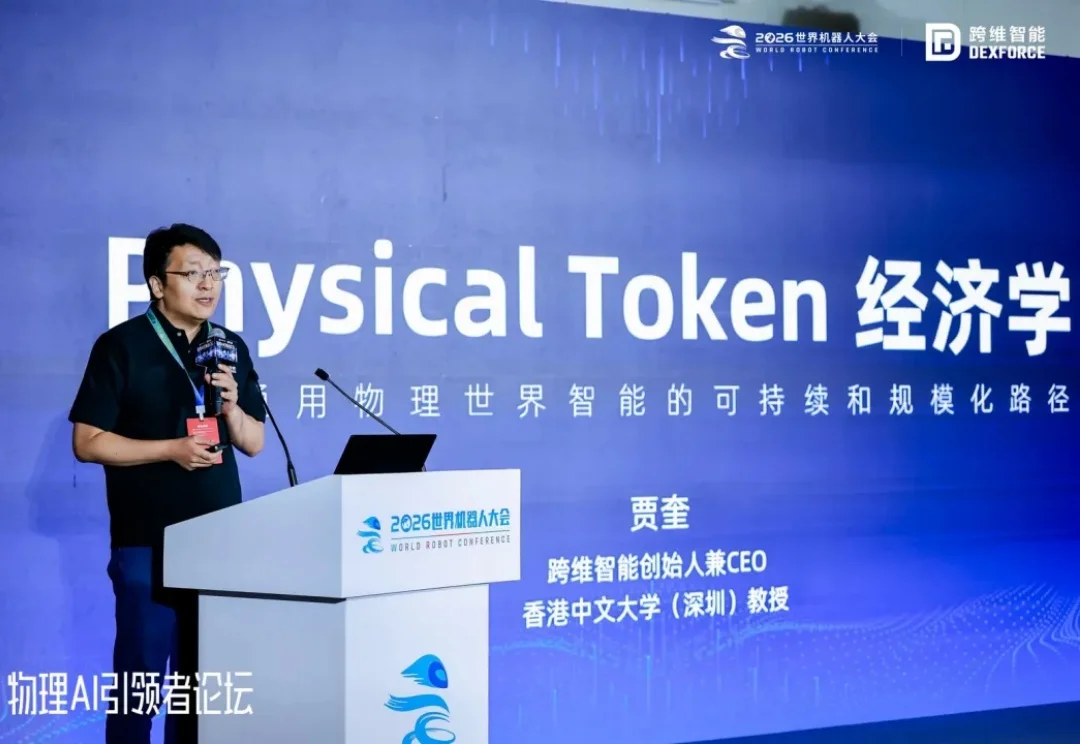
8 月 19 日,WRC 2026 期间,由跨维智能主办的「物理 AI 引领者论坛」在北京举行。
Pixel 擅长表达 appearance,Code 擅长表达 structure;未来会进入 Pixel-Code 联合的视觉表达。
今天,Symbiosis Robotics(共生知行)放出了一段新演示。
AI竞争的焦点,变了。
就在刚刚,SemiAnalysis的一个内部播客,曝出了不少猛料。据悉,Anthropic新模型Mythos 2已经训练完成,但惨遭雪藏。现在,Anthropic正用Mythos 2生成的数据,去全力冲刺Mythos 3!
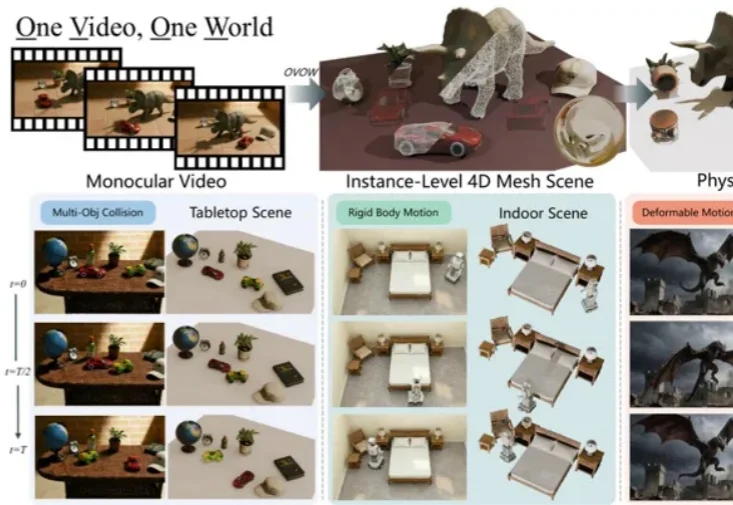
机器人走出实验室后,训练数据不再只是 “多不多” 的问题:环境能否覆盖真实世界的尺度、遮挡、接触和运动,直接决定策略能否落地。Real2Sim 因此重新受到关注 —— 如果普通视频也能变成可交互的仿真场景,采集成本会比人工建模或专用设备低得多。
刚刚,闭源RSI的钦点严父来了!