别再吹AI生图了,不能图层编辑的AI都是“画饼”
别再吹AI生图了,不能图层编辑的AI都是“画饼”面向设计生产场景,兔展智能研发了UniWorld-Design,进一步强化了视觉生成与编辑能力的结合,并基于此打造了产模一体战略的重要产品——RabbitVis。AI正在从通用能力竞争,进入场景能力竞争
来自主题: AI资讯
8880 点击 2026-08-06 10:47

 搜索
面向设计生产场景,兔展智能研发了UniWorld-Design,进一步强化了视觉生成与编辑能力的结合,并基于此打造了产模一体战略的重要产品——RabbitVis。AI正在从通用能力竞争,进入场景能力竞争
随着 AI 生图能力不断提升,如何让 AI 真正进入创作流程成为新的行业问题。兔展智能基于 UniWorld-Design 视觉 AI 大模型推出 RabbitVis,尝试推动视觉 AI 从图片生成走向可编辑、可交付的创作流程。
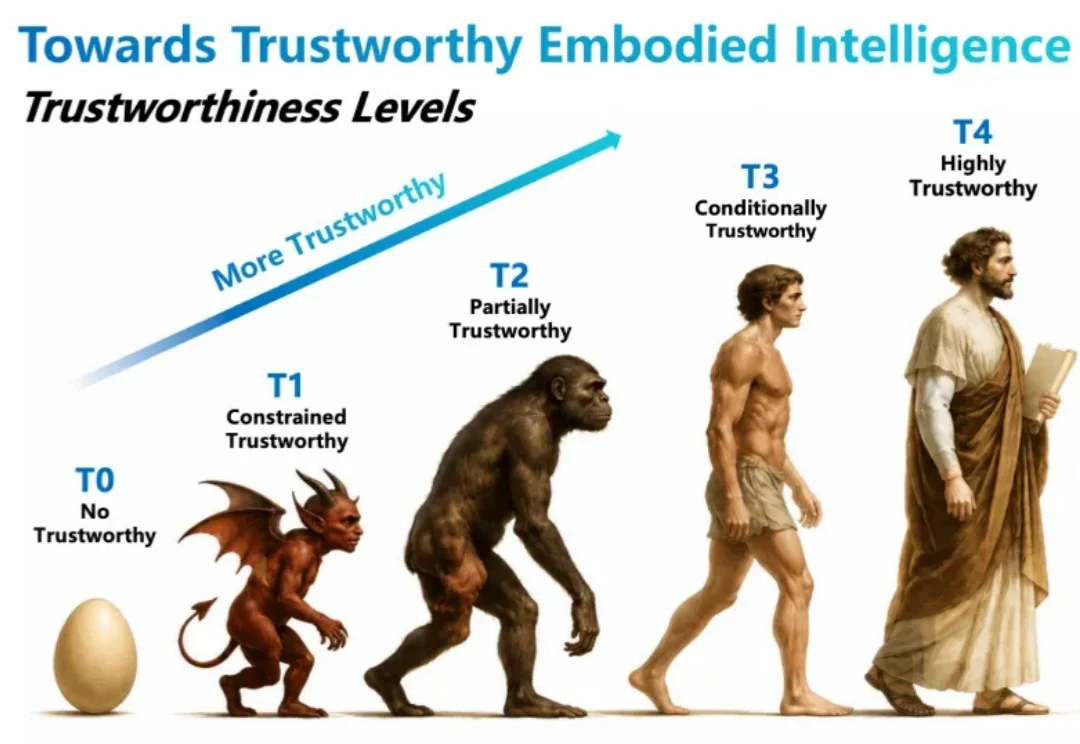
刚刚落幕的2026世界人工智能大会(WAIC)针对人工智能安全的讨论被推到了前所未有的高度。大会《主席声明》明确提出,"要筑牢安全底线、防范滥用恶用,确保人工智能始终处于人类控制之下"。
2026 年 7 月 31 日,迪士尼公司公布了旗下加速器项目(Disney Accelerator)第 12 期名单,入选的 5 家公司都和 AI 密切相关,其中包括具身智能公司 FieldAI、Physical Intelligence(简称 PI),以及 3 家生成式 AI 公司。
无论是李飞飞教授持续强调的空间智能,还是黄仁勋在演讲与行业峰会中反复描绘的Physical AI,2026年的科技产业正在传递一个无比明确且强烈的信号:AI正在跨越纯软件与数字比特的边界,全面走向真实的物理世界。
刚刚,杭州大模型公司西湖心辰宣布,公司近日完成数亿元人民币B+轮融资。该公司创始人蓝振忠,是卡耐基梅隆大学AI博士、自然语言处理预训练语言模型“ALBERT”第一作者,曾任谷歌人工智能研究院科学家,研究成果已被应用于Google News、Google Assistant 等数亿级用户产品中。他于2020年6月受聘于西湖大学,创办深度学习实验室并担任博士生导师。
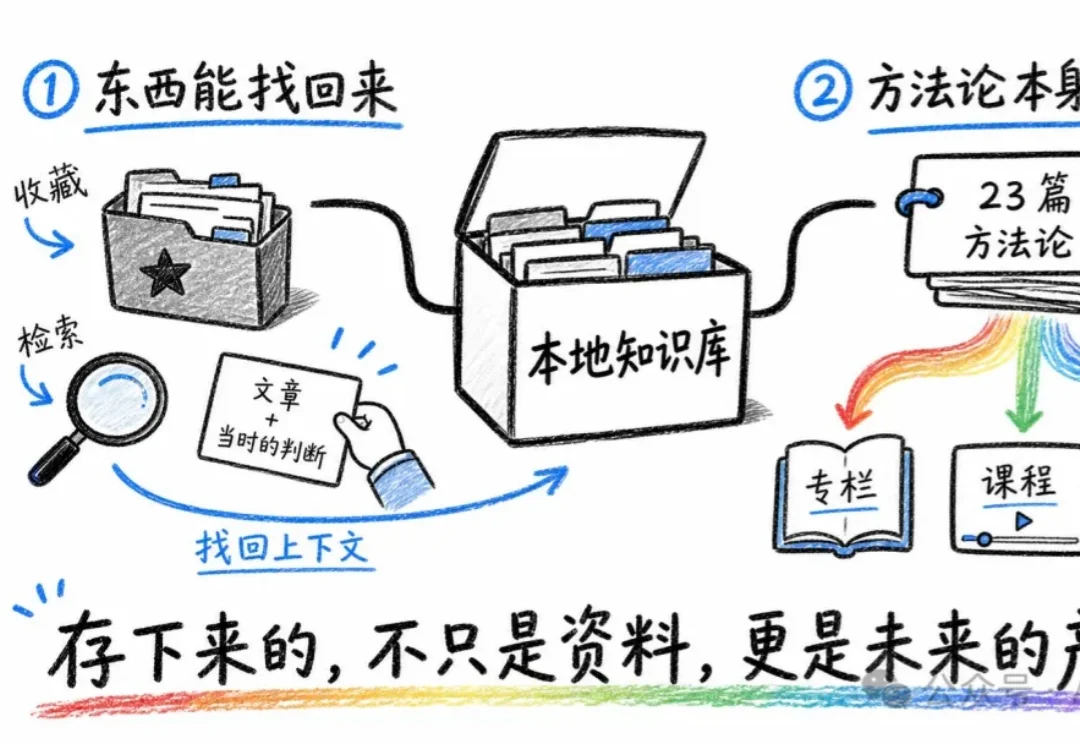
7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
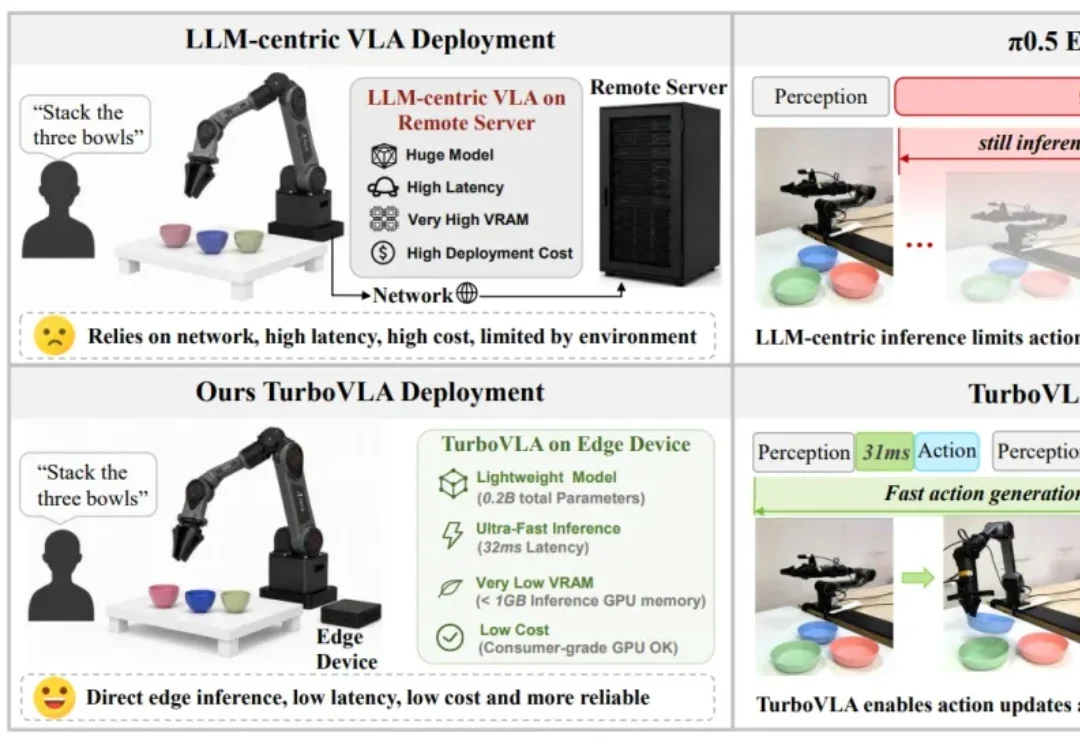
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
又一家AI初创公司加入了这场狂飙突进的独角兽俱乐部:Simile。据该初创公司透露,就在结束隐身状态、宣布完成由Index Ventures领投的1亿美元A轮融资仅仅五个月后,公司已完成2亿美元B轮融资,估值达到20亿美元。
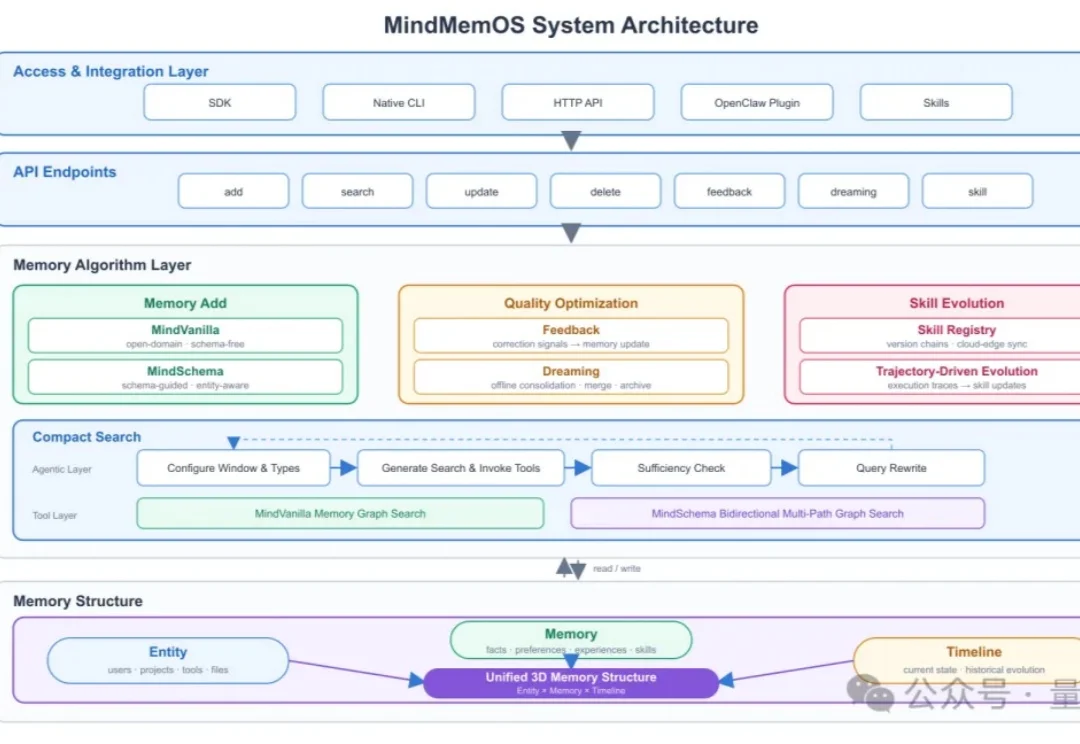
Agent的能力越来越强,但使用体验仍有一个尴尬之处: 每换一个Agent甚至换一个session,就像换了一个完全不了解你的新员工。