o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」
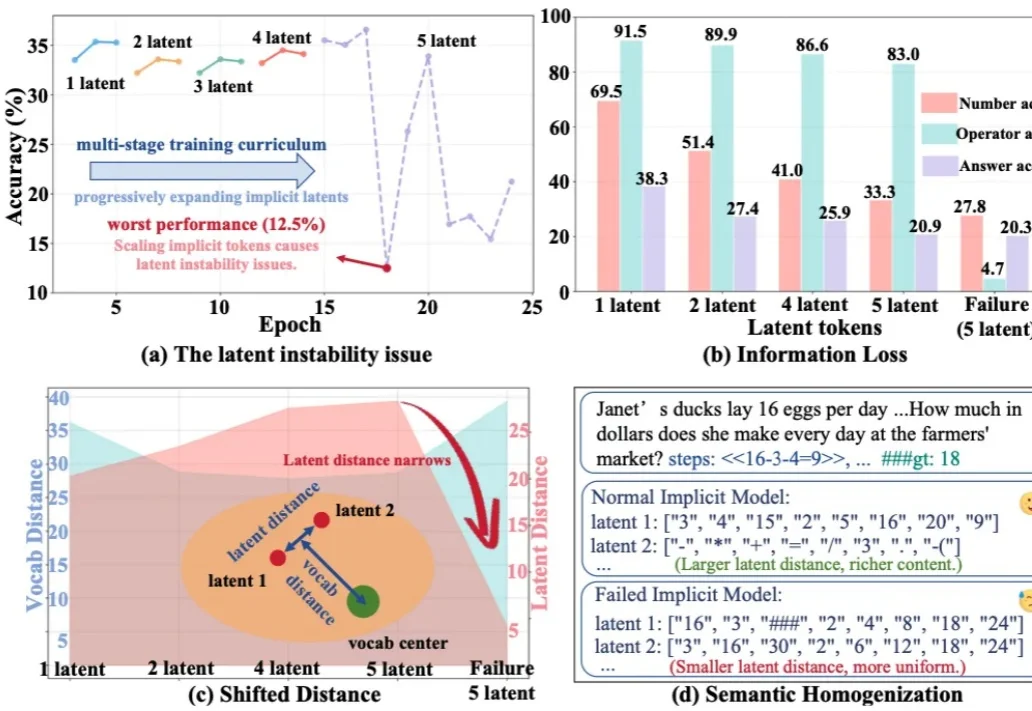
o1之后下一个范式?隐式CoT大突破,让推理不再「碎碎念」今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
搜索
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
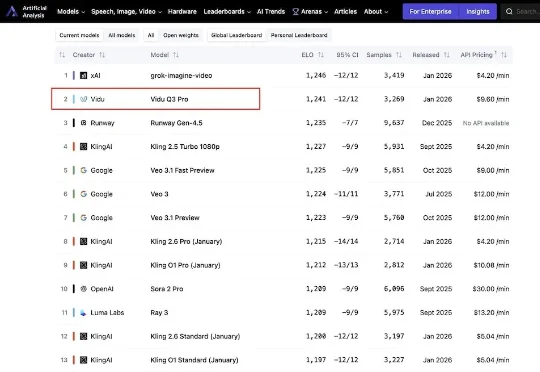
今日,来自生数科技的AI视频模型Vidu Q3 Pro登上国际权威AI基准平台Artificial Analysis榜单,位列中国第一,全球第二。这是最新榜单内,首个打入国际第一梯队的国产视频生成模型。
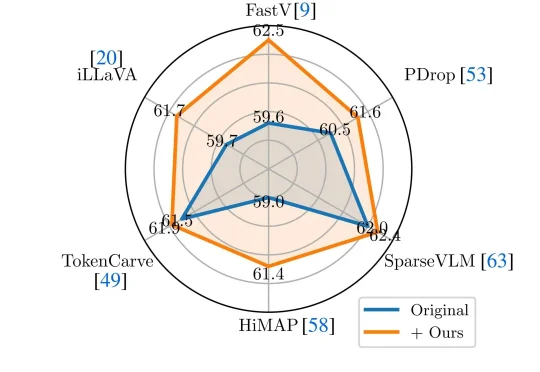
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
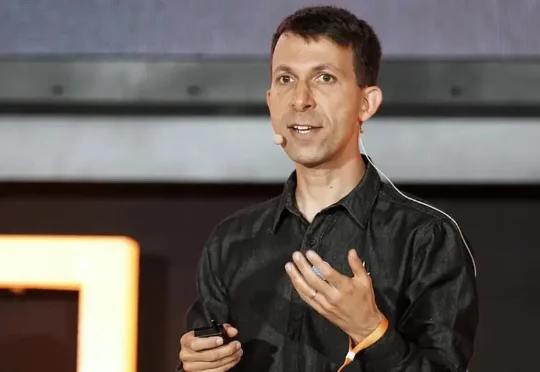
Google DeepMind 已于本月初向员工宣布了 Silver 的离职消息。Silver 在离职前的几个月里一直处于休假状态,并未正式返回 DeepMind 工作岗位。Google DeepMind 的一位发言人在电子邮件声明中证实了 Silver 离职的信息,表示:「Dave 的贡献是无价的,我们非常感谢他对 Google DeepMind 工作所做出的贡献。」
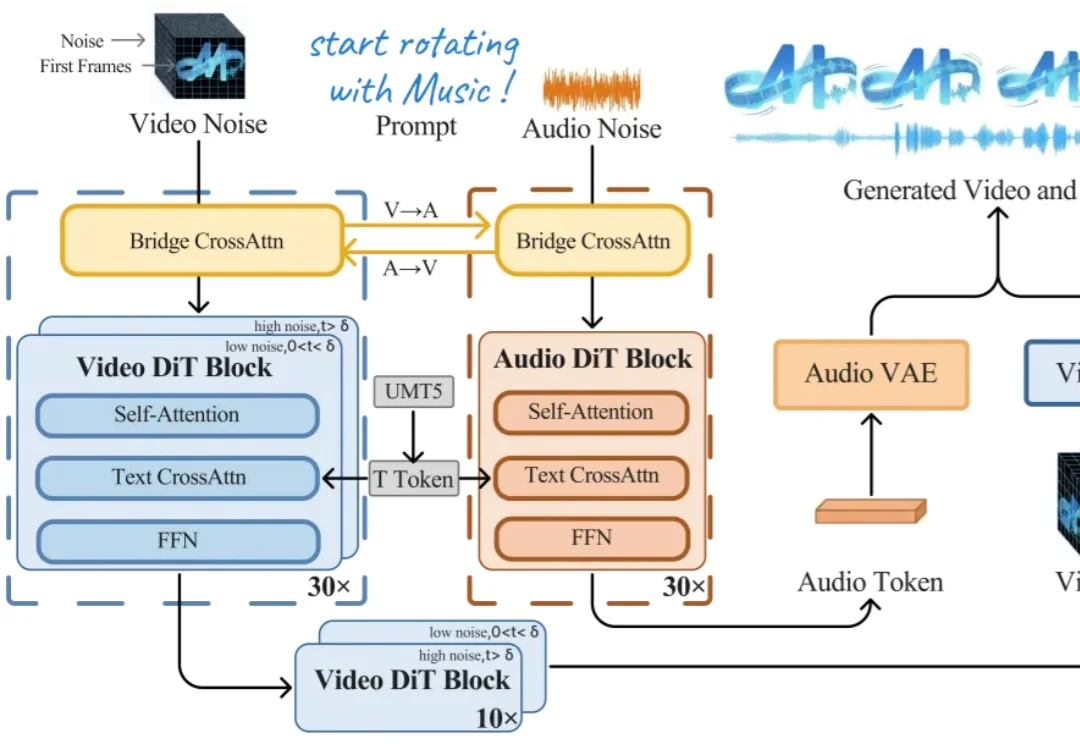
今天上午,上海创智学院 OpenMOSS 团队联合初创公司模思智能(MOSI),正式发布了端到端音视频生成模型 —— MOVA(MOSS-Video-and-Audio)。
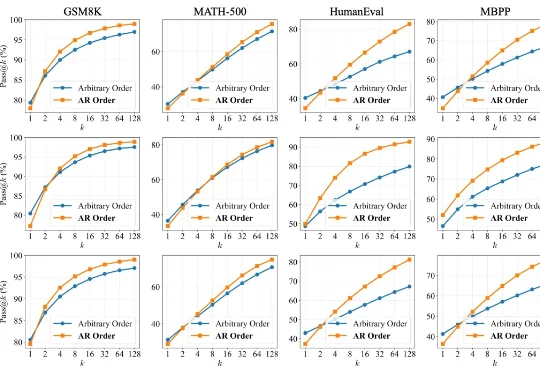
扩散语言模型(Diffusion LLMs, dLLMs)因支持「任意顺序生成」和并行解码而备受瞩目。直觉上,打破传统自回归(AR)「从左到右」的束缚,理应赋予模型更广阔的解空间,从而在数学、代码等复杂任务上解锁更强的推理潜力。
OpenAI 11位联创只剩3人,Ilya出走创办SSI,John Schulman跳槽Anthropic……而Anthropic的7位创始人至今无人离队。稳定,才是最大的竞争力。
今天,我们正式发布 MiniMax Music 2.5:全维度突破,指挥细节,定义真实。AI 音乐始终面对两个挑战:可控性与真实度。前者决定了创作者能否表达真实意图,后者决定了作品是否具备专业质感。
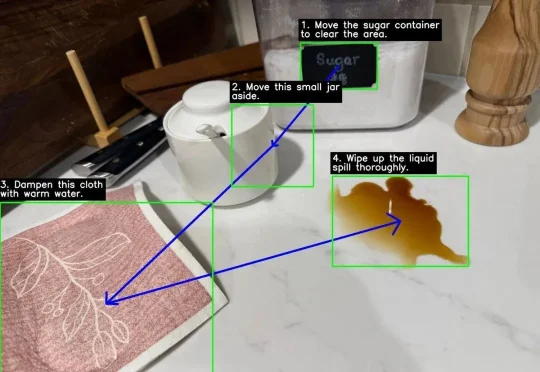
没想到吧,Google DeepMind刚刚为Gemini 3 Flash推出了一个重量级新能力:Agentic Vision(智能体视觉)。(难道是被DeepSeek-OCR2给刺激到了?)
我们都在System Prompt里写过无数次 You are a helpful assistant,但你是否想过:这行文字在模型的残差流(Residual Stream)中究竟对应着怎样的几何结构?