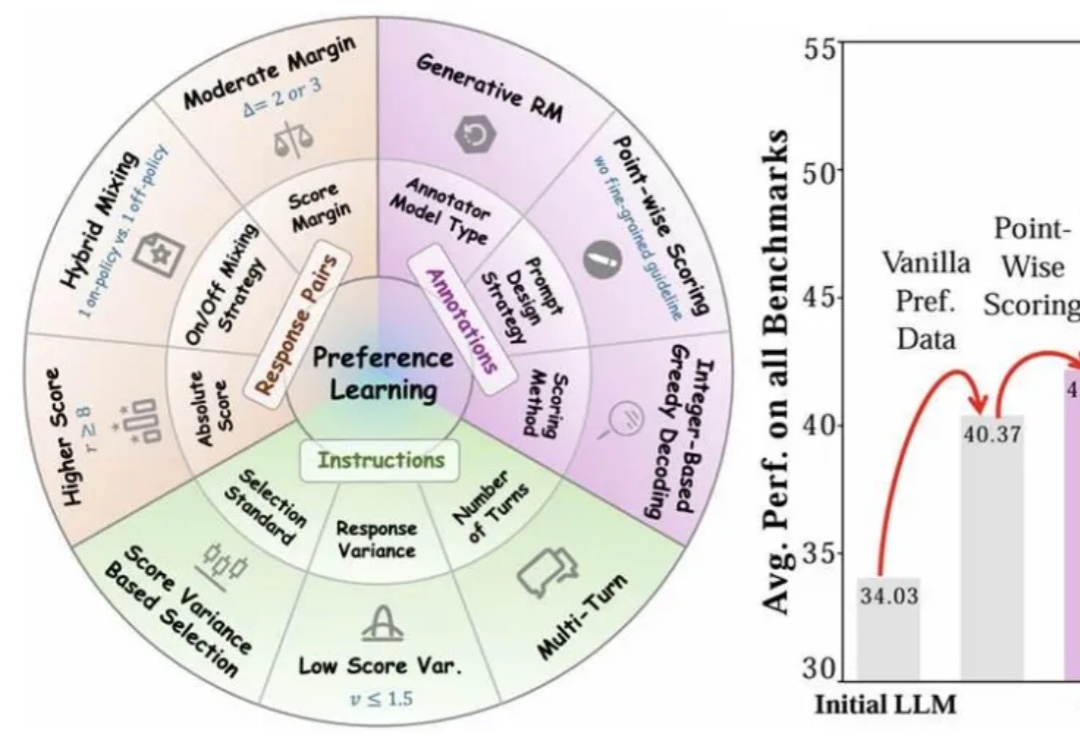
什么样的偏好,才叫好的偏好?——揭秘偏好对齐数据的「三驾马车」
什么样的偏好,才叫好的偏好?——揭秘偏好对齐数据的「三驾马车」近年来,大语言模型(LLMs)的对齐研究成为人工智能领域的核心挑战之一,而偏好数据集的质量直接决定了对齐的效果。无论是通过人类反馈的强化学习(RLHF),还是基于「RL-Free」的各类直接偏好优化方法(例如 DPO),都离不开高质量偏好数据集的构建。
来自主题: AI技术研报
10250 点击 2025-04-15 14:29

 搜索
近年来,大语言模型(LLMs)的对齐研究成为人工智能领域的核心挑战之一,而偏好数据集的质量直接决定了对齐的效果。无论是通过人类反馈的强化学习(RLHF),还是基于「RL-Free」的各类直接偏好优化方法(例如 DPO),都离不开高质量偏好数据集的构建。
今天凌晨,OpenAI 的新系列模型 GPT-4.1 如约而至。
一切为了「多终端一致体验」和「用户数据闭环」。
就在刚刚,智谱一口气上线并开源了三大类最新的GLM模型:沉思模型GLM-Z1-Rumination 推理模型GLM-Z1-Air 基座模型GLM-4-Air-0414

虽然扩散模型在视频生成领域展现出了卓越的性能,但是视频扩散模型通常需要大量的推理步骤对高斯噪声进行去噪才能生成一个视频。这个过程既耗时又耗计算资源。例如,HunyuanVideo [1] 需要 3234 秒才能在单张 A100 上生成 5 秒、720×1280、24fps 的视频。
开发Agent的工程师们都曾面临同一个棘手问题:当任务步骤增多,你的Agent就像患上"数字健忘症",忘记之前做过什么,无法处理用户的修改请求,甚至在多轮对话中迷失自我。不仅用户体验受损,token开销也居高不下。TME树状记忆引擎通过结构化状态管理方案,彻底解决了这一痛点,让你的Agent像拥有完美记忆力的助手,在复杂任务中游刃有余,同时将token消耗降低26%。

“AI是一次改变我们所知一切的历史性机会。”美国当地时间2025年4月10日,全球电商平台亚马逊CEO安迪·贾西(Andy Jassy)在发布2024年度致股东信时,不遗余力地盛赞AI。
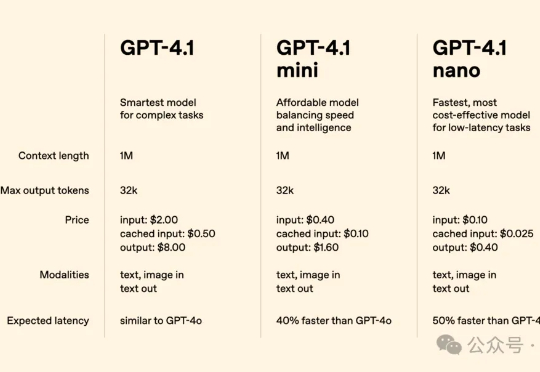
OpenAI重磅发布的GPT-4.1系列模型,带来了编程、指令跟随和长上下文处理能力的全面飞跃!由中科大校友Jiahui Yu领衔的团队打造。与此同时,备受争议的GPT-4.5将在三个月后停用,GPT-4.1 nano则以最小、最快、最便宜的姿态强势登场。
最近,Netflix 正在悄悄测试一项黑科技功能——由 ChatGPT 背后的 OpenAI 提供支持的智能搜索服务。这不仅仅是搜索条那么简单,它可能会彻底改变你跟内容平台“对话”的方式。
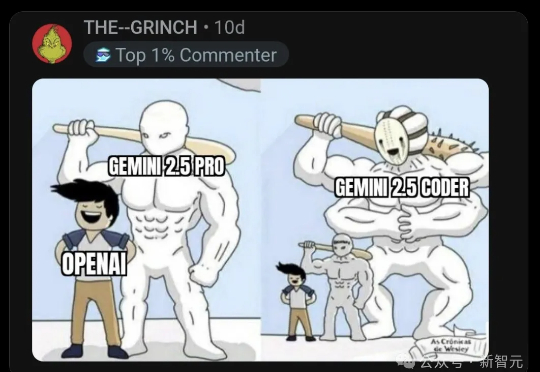
刚刚,Gemini 2.5 Pro编程登顶,6美元性价比碾压Claude 3.7 Sonnet。不仅如此,谷歌还暗藏着更强的编程模型Dragontail,这次是要彻底翻盘了。