
优于o1预览版,推理阶段KV缓存缩减一半,LightTransfer降本还能增效
优于o1预览版,推理阶段KV缓存缩减一半,LightTransfer降本还能增效LLM 在生成 long CoT 方面展现出惊人的能力,例如 o1 已能生成长度高达 100K tokens 的序列。然而,这也给 KV cache 的存储带来了严峻挑战。
来自主题: AI技术研报
7367 点击 2025-03-11 09:32

 搜索
LLM 在生成 long CoT 方面展现出惊人的能力,例如 o1 已能生成长度高达 100K tokens 的序列。然而,这也给 KV cache 的存储带来了严峻挑战。

哥大的大二学生Roy Lee,靠AI作弊顺利取得亚马逊、Meta、TikTok等大厂的offer!被告发后,哥大在11日将举行听证会,但小哥表示,自己已经买了单程票,到时自己并不会在学校,甚至可能退学。如今,小哥已经成了网红,AI作弊神器Interview Coder卖60美元一个月,公司收入快破百万了。
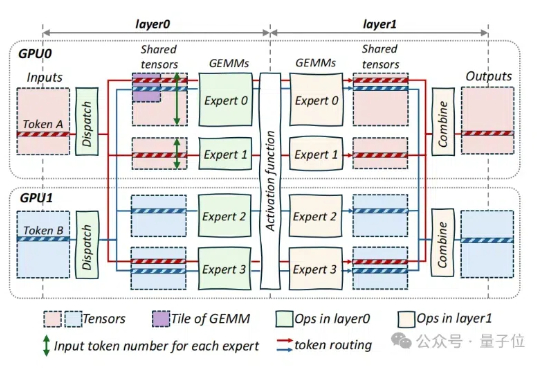
字节对MoE模型训练成本再砍一刀,成本可节省40%! 刚刚,豆包大模型团队在GitHub上开源了叫做COMET的MoE优化技术。

智能眼镜的意义不在于呈现更多的功能,而是尽可能不干扰用户的情况下,为用户提供智能服务。

北京时间3月10日,据《华尔街日报》报道,富士康母公司鸿海已研发出中国台湾地区首个具备先进推理能力的大模型,性能上落后于DeepSeek的部分大模型。鸿海周一表示,已自主研发了具备推理能力的人工智能(AI)大语言模型FoxBrain,并在四周内完成训练。FoxBrain最初为公司内部使用而设计,具备数据分析、数学运算、推理以及代码生成的能力。
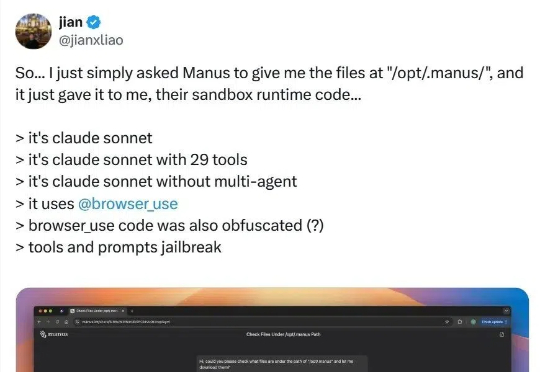
北京时间3月10日清晨,推特用户jianxliao发布推文称成功“越狱”了Manus AI的代码,据其透露,他只是简单地要求Manus提供"/opt/.manus/"目录下的文件,系统便直接提供了沙盒运行时代码,并揭示了Manus使用Claude Sonnet模型、配备29个工具且使用了browser_use开源项目等技术细节。
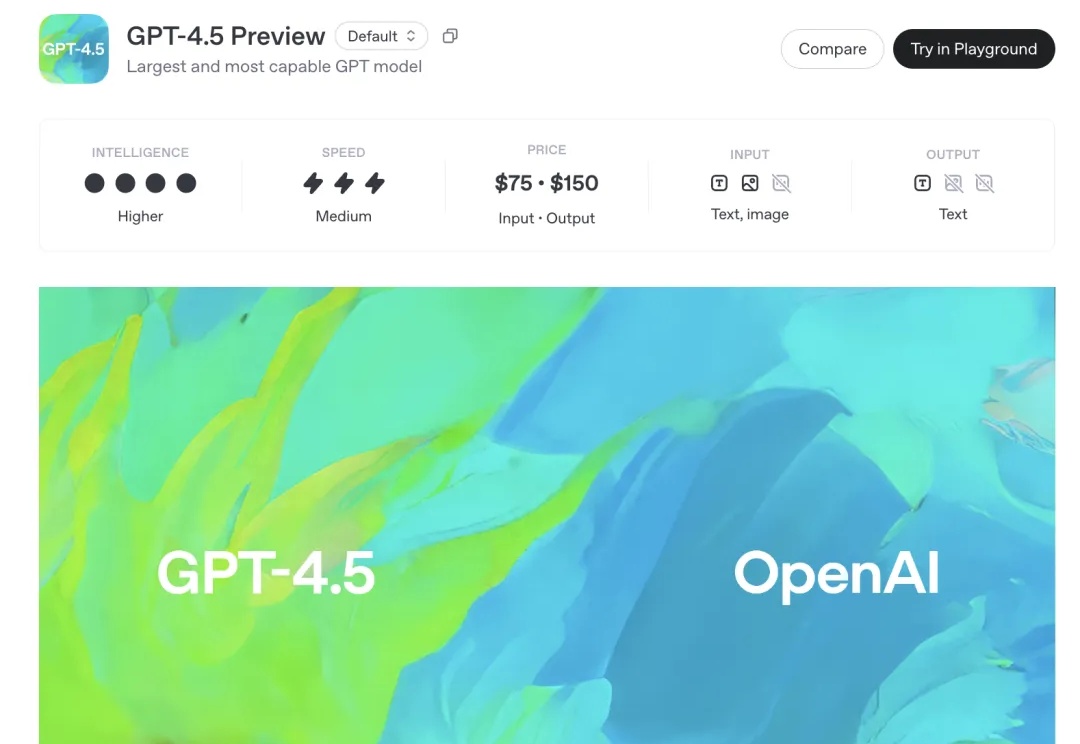
OpenAI的模型搞得太多太凌乱,官方自己都看不下去了。
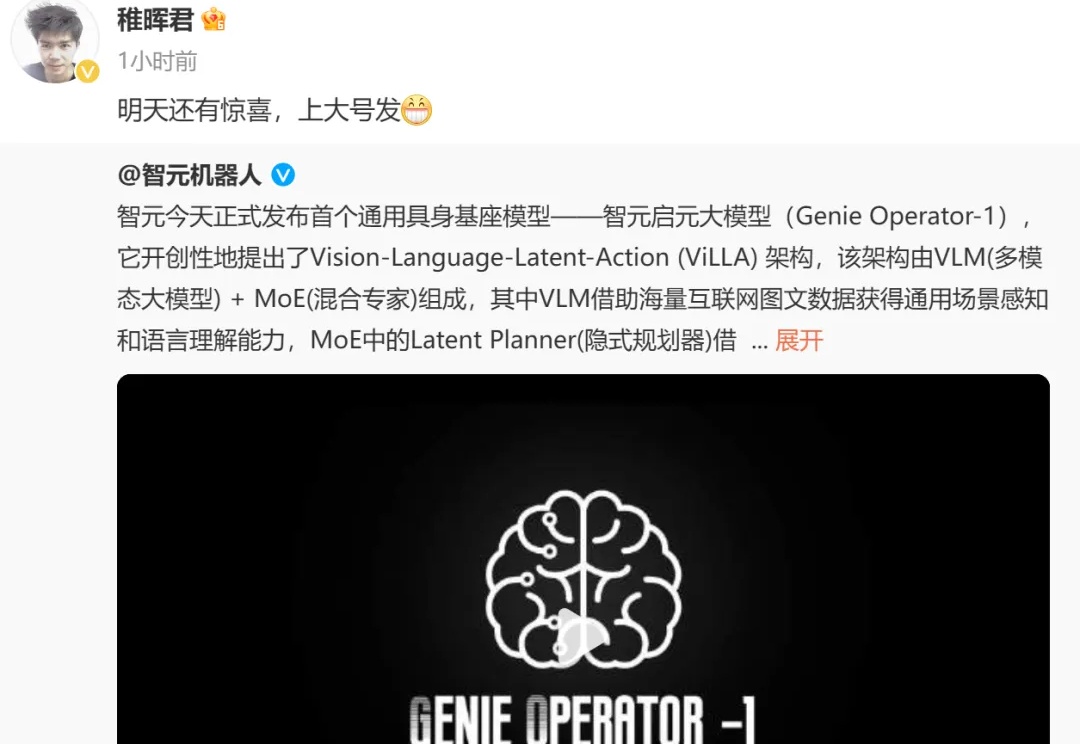
刚填完坑就又埋下“惊喜预告”??
AI智能体领域Type-C来了!Manus及其开源复现诞生,一夜捧红了MCP,工具调用/访问外部数据,一个协议就够了。
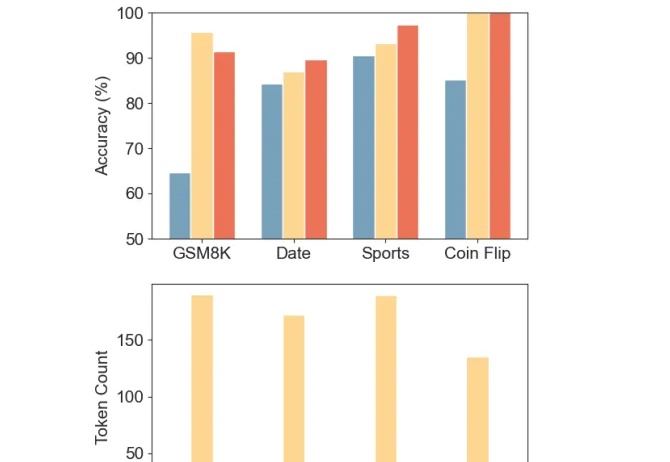
推理token减少80%-90%,准确率变化不大,某些任务还能增加。