AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
月流量超千万,中国大厂走出的创始团队做AI视频应用,流量超字节的CapCut

月流量超千万,中国大厂走出的创始团队做AI视频应用,流量超字节的CapCut

月流量超千万,中国大厂走出的创始团队做AI视频应用,流量超字节的CapCut

Similarweb 数据显示,在网站端,过去28天,视频编辑类产品Zeemo和Vizard的日平均访问量均超CapCut,在功能上,Zeemo和CapCut相似度更高,而在商业化范围的广度方面,Vizard的专业性更强。

来自主题: AI资讯
12400 点击    2025-02-11 10:57
花1400万美元投放广告的OpenAI,被DeepSeek逼到剑走偏锋?

花1400万美元投放广告的OpenAI,被DeepSeek逼到剑走偏锋?

花1400万美元投放广告的OpenAI,被DeepSeek逼到剑走偏锋?

OpenAI感受到不小的危机,甚至开始走营销的“捷径”。近日OpenAI以 60 秒的广告首次亮相超级碗(全国橄榄球联盟的年度冠军赛),这则广告上半年的投放成本约为 1400 万美元。
来自主题: AI资讯
9044 点击    2025-02-10 20:36
2025年将成Python主导AI领域的最后一年:Java强势入侵Python腹地

2025年将成Python主导AI领域的最后一年:Java强势入侵Python腹地

2025年将成Python主导AI领域的最后一年:Java强势入侵Python腹地

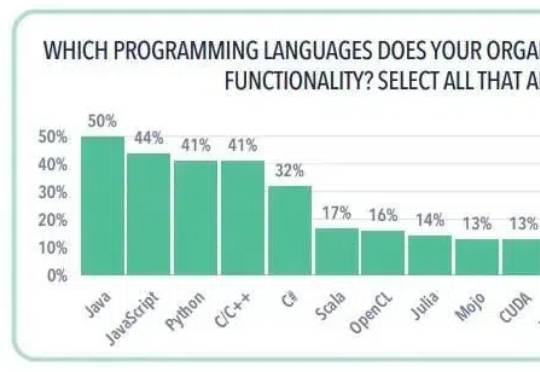
Java,这头在企业应用领域深耕 30 年的“猛兽”,如今正虎视眈眈地瞄准 AI 这块 Python 的“固有领地”。尤其是在企业级 AI 应用方面,Python 的优势似乎正在逐渐减弱。一家大型 Java 平台公司的技术负责人甚至预测,2025 年将是 Python 在 AI 领域占据主导地位的最后一年。
来自主题: AI资讯
8787 点击    2025-02-10 20:28
刚刚,奥特曼给出AGI三个判断:Scaling Law保持不变,没理由放缓投资

刚刚,奥特曼给出AGI三个判断:Scaling Law保持不变,没理由放缓投资

刚刚,奥特曼给出AGI三个判断:Scaling Law保持不变,没理由放缓投资

刚刚,OpenAI奥特曼的最新AI观察出炉:Scaling Law将保持不变,短时间内没有理由停止对AI进行指数增长级的投资!1、AI能力与投入资源呈对数关系 2、AI使用成本每年降低约10倍 3、AI带来的社会经济价值呈超级指数增长
来自主题: AI资讯
12210 点击    2025-02-10 17:48
马克龙豪掷1090亿开欧洲「星际之门」,Mistral狂飙登顶法国APP榜首!

马克龙豪掷1090亿开欧洲「星际之门」,Mistral狂飙登顶法国APP榜首!

马克龙豪掷1090亿开欧洲「星际之门」,Mistral狂飙登顶法国APP榜首!

史上首次,Mistral AI的超级助手Le Chat登顶法国免费APP榜首!开发者们激动表示,谢谢Mistral AI,欧洲终于在AI竞赛中有了一席之地。马克龙也宣布,法国将投资1090亿欧元建设欧洲版「星际之门」。
来自主题: AI资讯
11666 点击    2025-02-10 17:41
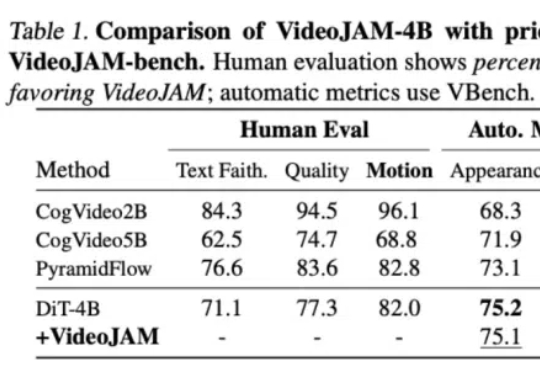
Meta新视频生成框架拿捏倒立杂技,双人舞也能完美同步!运动一致性暴增近20%,可无缝集成DiT模型

Meta新视频生成框架拿捏倒立杂技,双人舞也能完美同步!运动一致性暴增近20%,可无缝集成DiT模型

Meta新视频生成框架拿捏倒立杂技,双人舞也能完美同步!运动一致性暴增近20%,可无缝集成DiT模型

针对视频生成中的运动一致性难题,Meta GenAI团队提出了一个全新框架VideoJAM。VideoJAM基于主流的DiT路线,但和Sora等纯DiT模型相比,动态效果直接拉满:
来自主题: AI技术研报
11033 点击    2025-02-10 17:25
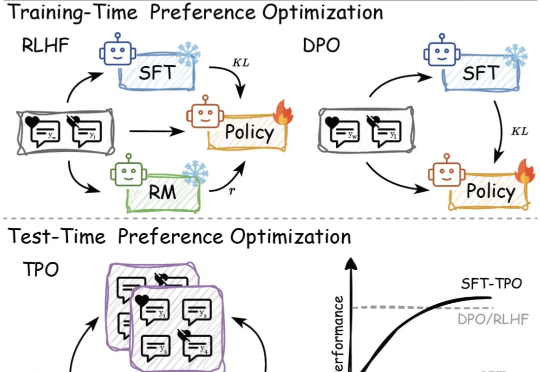
推理时也能做偏好优化,无需额外重训练,来自上海AI Lab港中文等

推理时也能做偏好优化,无需额外重训练,来自上海AI Lab港中文等

推理时也能做偏好优化,无需额外重训练,来自上海AI Lab港中文等

传统的偏好对⻬⽅法,如基于⼈类反馈的强化学习(RLHF)和直接偏好优化(DPO),依赖于训练过程中的模型参数更新,但在⾯对不断变化的数据和需求时,缺乏⾜够的灵活性来适应这些变化。
来自主题: AI技术研报
9801 点击    2025-02-10 17:19
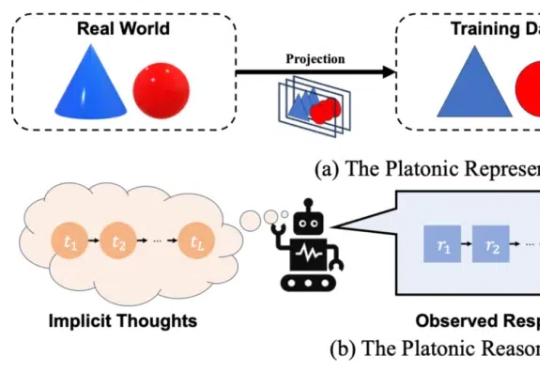
人大刘勇团队「慢思考」机理分析:从雪球误差到正确推理概率

人大刘勇团队「慢思考」机理分析:从雪球误差到正确推理概率

人大刘勇团队「慢思考」机理分析:从雪球误差到正确推理概率

「慢思考」(Slow-Thinking),也被称为测试时扩展(Test-Time Scaling),成为提升 LLM 推理能力的新方向。近年来,OpenAI 的 o1 [4]、DeepSeek 的 R1 [5] 以及 Qwen 的 QwQ [6] 等顶尖推理大模型的发布,进一步印证了推理过程的扩展是优化 LLM 逻辑能力的有效路径。
来自主题: AI技术研报
8346 点击    2025-02-10 17:04
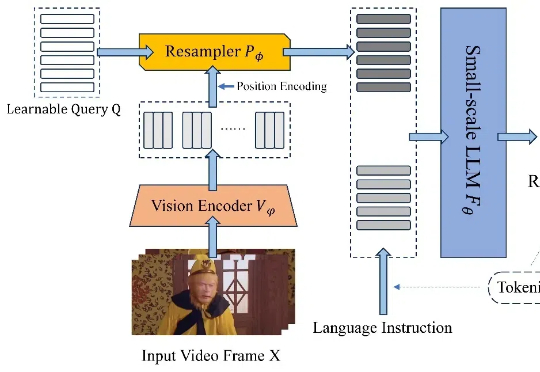
北航推出TinyLLaVA-Video,有限计算资源优于部分7B模型,代码、模型、训练数据全开源

北航推出TinyLLaVA-Video,有限计算资源优于部分7B模型,代码、模型、训练数据全开源

北航推出TinyLLaVA-Video,有限计算资源优于部分7B模型,代码、模型、训练数据全开源

近日,北京航空航天大学的研究团队基于 TinyLLaVA_Factory 的原项目,推出小尺寸简易视频理解框架 TinyLLaVA-Video,其模型,代码以及训练数据全部开源。在计算资源需求显著降低的前提下,训练出的整体参数量不超过 4B 的模型在多个视频理解 benchmark 上优于现有的 7B + 模型。
来自主题: AI技术研报
9928 点击    2025-02-10 16:54
诺奖得主DeepMind CEO放话:DeepSeek是中国最好AI模型,但没任何科学进步

诺奖得主DeepMind CEO放话:DeepSeek是中国最好AI模型,但没任何科学进步

诺奖得主DeepMind CEO放话:DeepSeek是中国最好AI模型,但没任何科学进步

xAI、谷歌DeepMind和Anthropic的CEO们纷纷对DeepSeek的技术创新性提出质疑,认为其并未带来实质性的科学突破。AI大佬纷纷泼冷水,到底是技术讨论还是各怀目的?

来自主题: AI资讯
9758 点击    2025-02-10 16:50