
405B大模型也能线性化!斯坦福MIT最新研究,0.2%训练量让线性注意力提分20+
405B大模型也能线性化!斯坦福MIT最新研究,0.2%训练量让线性注意力提分20+近日,来自斯坦福、MIT等机构的研究人员推出了低秩线性转换方法,让传统注意力无缝转移到线性注意力,仅需0.2%的参数更新即可恢复精度,405B大模型两天搞定!
来自主题: AI技术研报
8306 点击 2024-11-21 13:47

 搜索
近日,来自斯坦福、MIT等机构的研究人员推出了低秩线性转换方法,让传统注意力无缝转移到线性注意力,仅需0.2%的参数更新即可恢复精度,405B大模型两天搞定!
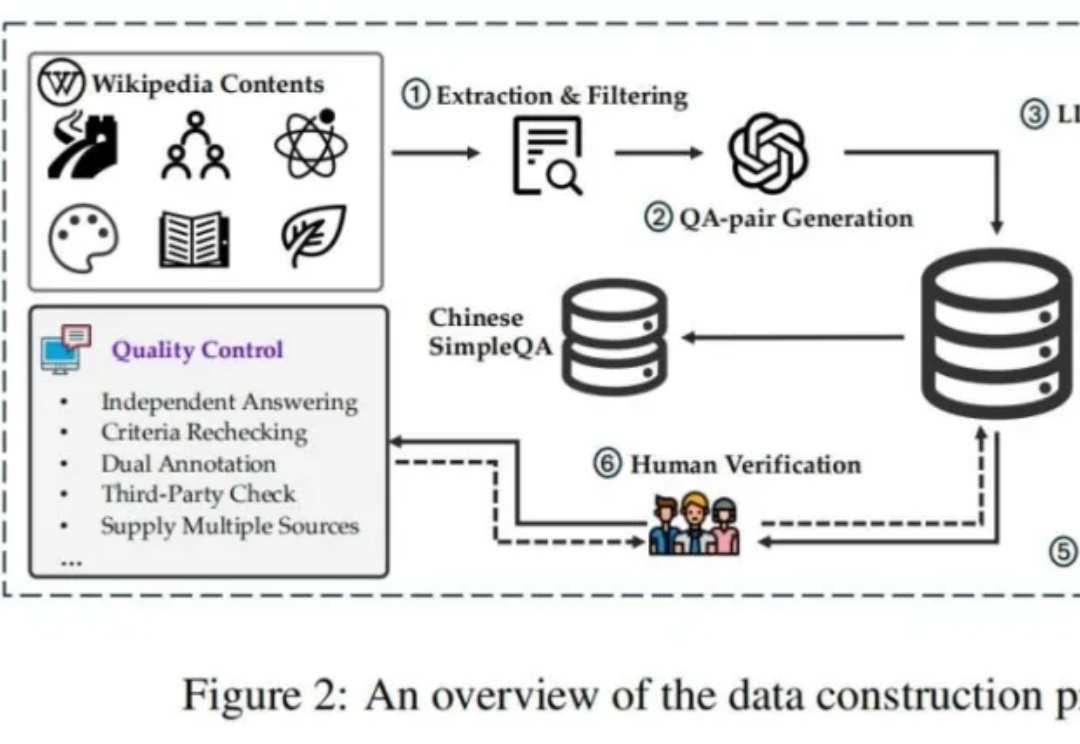
新的大语言模型(LLM)评估基准对于跟上大语言模型的快速发展至关重要。
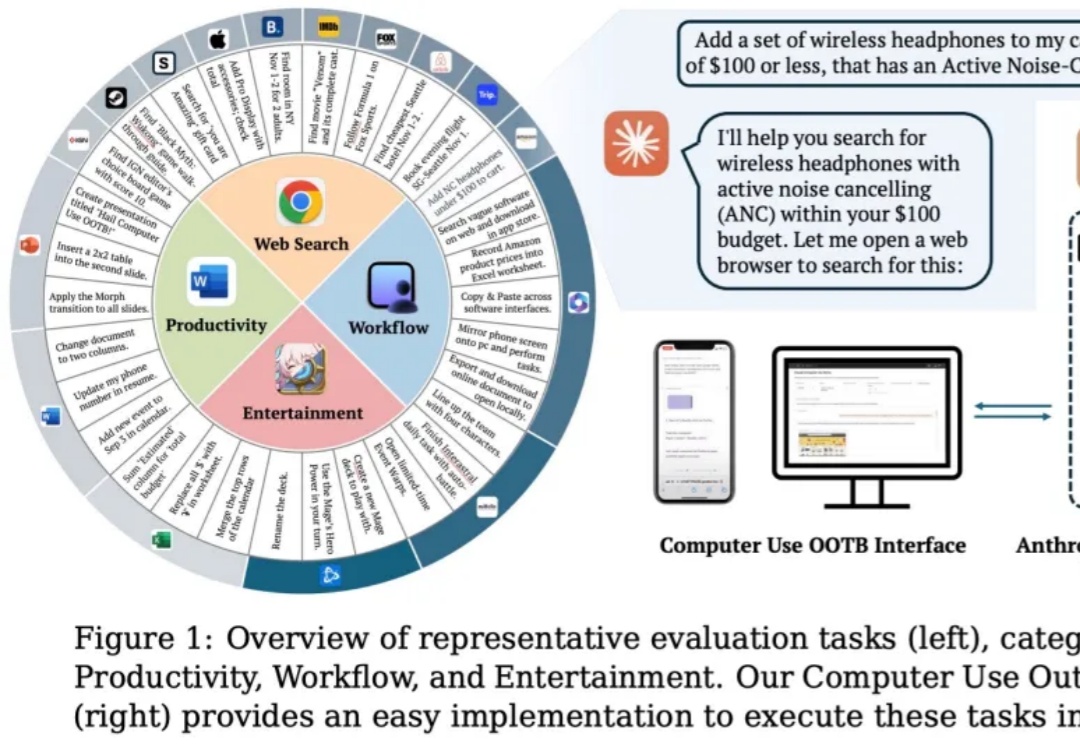
大模型的执行力从哪里来?
关于产业进展,代码辅助工具,PearAI ,https://trypear.ai/,提供了代码自动生成、智能代码预测、代码编辑聊天、代码记忆提升、智能代码搜索等功能,还内置了Perplexity、Memo等其他AI工具,这其实加剧了如cursor等同质产品的竞争。

经过过去两年的野蛮狂奔,今天AI产业的主流论断已经从当初的FOMO(Fear of Missing Out)狂热情绪回归到了PMF(Product / Market Fit )的冷静思考。

近日,有消息称,王诗沐的创业公司全灵(SEELE)完成千万美元Pre-A轮融资,投资方包括百度战投、美图投资、富坤创投、Webtime Information S&T等。据悉,本轮融资将用于打造全新游戏AIGC引擎,以及团队建设。

今天,DeepSeek 全新研发的推理模型 DeepSeek-R1-Lite 预览版正式上线。所有用户均可登录官方网页 (chat.deepseek.com),一键开启与 R1-Lite 预览版模型的超强推理对话体验。DeepSeek R1 系列模型使用强化学习训练,推理过程包含大量反思和验证,思维链长度可达数万字。
又一个国产版《Her》,就这么水灵灵地来了。
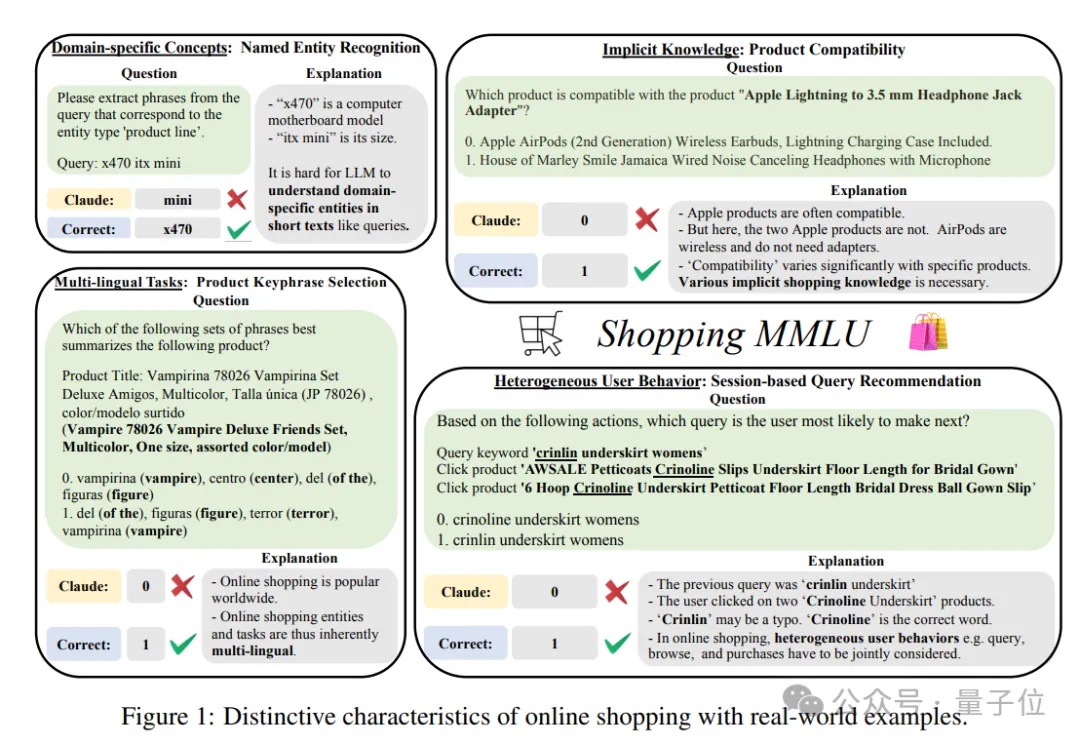
谁是在线购物领域最强大模型?也有评测基准了。
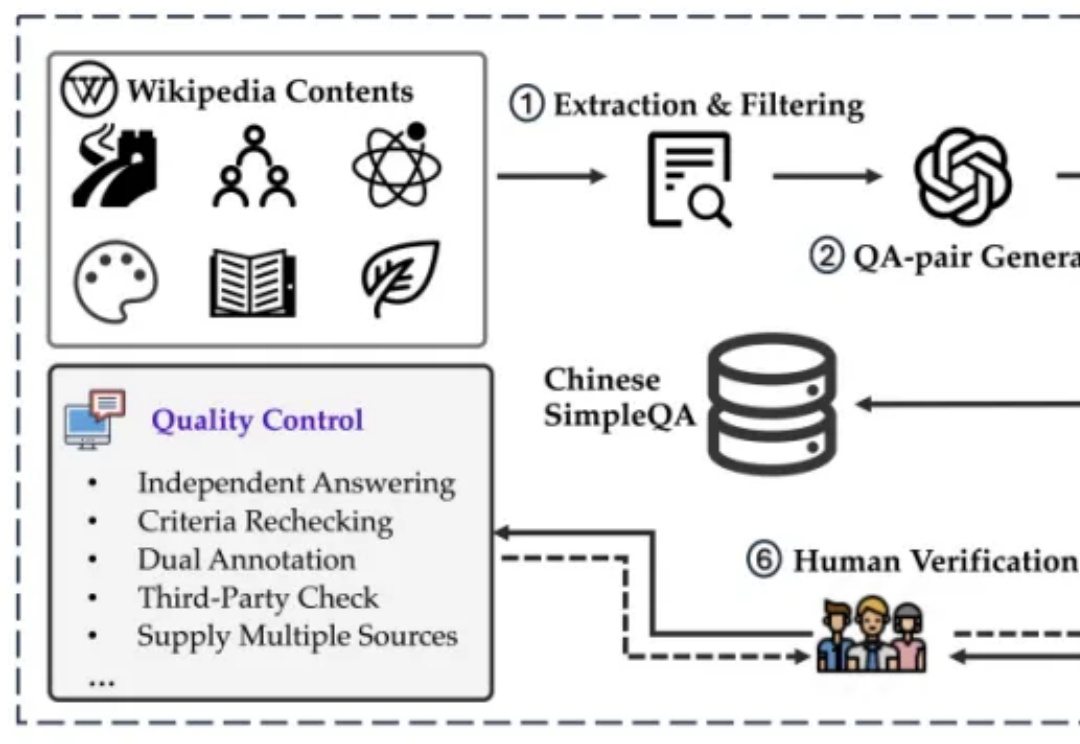
如何解决模型生成幻觉一直是人工智能(AI)领域的一个悬而未解的问题。为了测量语言模型的事实正确性,近期 OpenAI 发布并开源了一个名为 SimpleQA 的评测集。而我们也同样一直在关注模型事实正确性这一领域,目前该领域存在数据过时、评测不准和覆盖不全等问题。例如现在大家广泛使用的知识评测集还是 CommonSenseQA、CMMLU 和 C-Eval 等选择题形式的评测集。