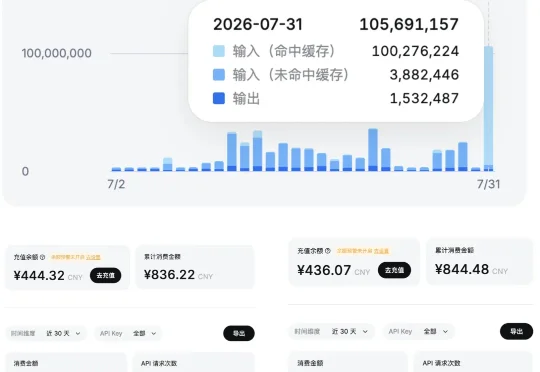
1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论
1小时花一亿token极限实测DeepSeek-V4-Flash,得出7个结论DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
来自主题: AI产品测评
10608 点击 2026-08-01 10:40

 搜索
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
我们整理了最近半年来 OpenCode CEO Jay V 以及联合创始人 Dax Raad 近期在多档播客和访谈中的核心观点,试图还原一个完整的图景,一家开源公司究竟如何在巨头夹缝中找到自己的位置,以及他们怎么看待商业化和模型编排。
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
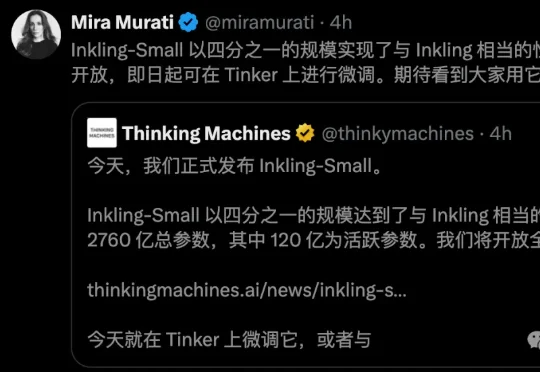
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。
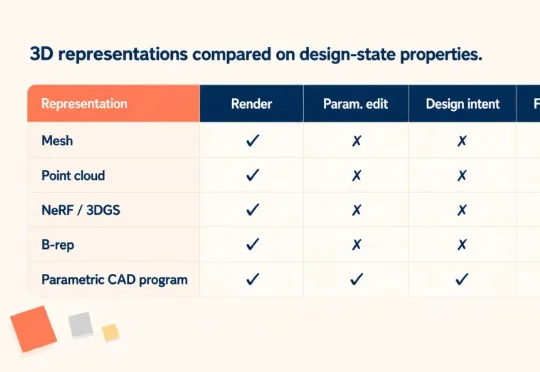
近日,比特无限发布的 Arko-T,是一款面向 Text-to-Structured 3D Generation 的 4B 参数基础模型。该模型由比特无限联创、首席科学家周平义博士带队完成。它接收自然语言描述,直接输出可执行的 Build123d 程序。程序经过 CAD 内核运行后,可以得到带有命名参数、结构特征和建模过程的 CAD 设计实体。
我重生了。 上一世,我是一本人工智能教材。学生在我的页边写满笔记,工程师折起其中几页,也有人把我放在书桌最显眼的位置。我一直相信,书存在的意义,就是把自己知道的事情交给更多人。
今天,全网都被这位25岁「AI先知」的故事刷屏了。 就在刚刚,华尔街上演了一场教科书级别的平仓。这场血雨腥风的主角,是被硅谷奉为「AI预言家」的Leopold Aschenbrenner,以及他那只439%逆天回报率的对冲基金——Situational Awareness(情境感知)。
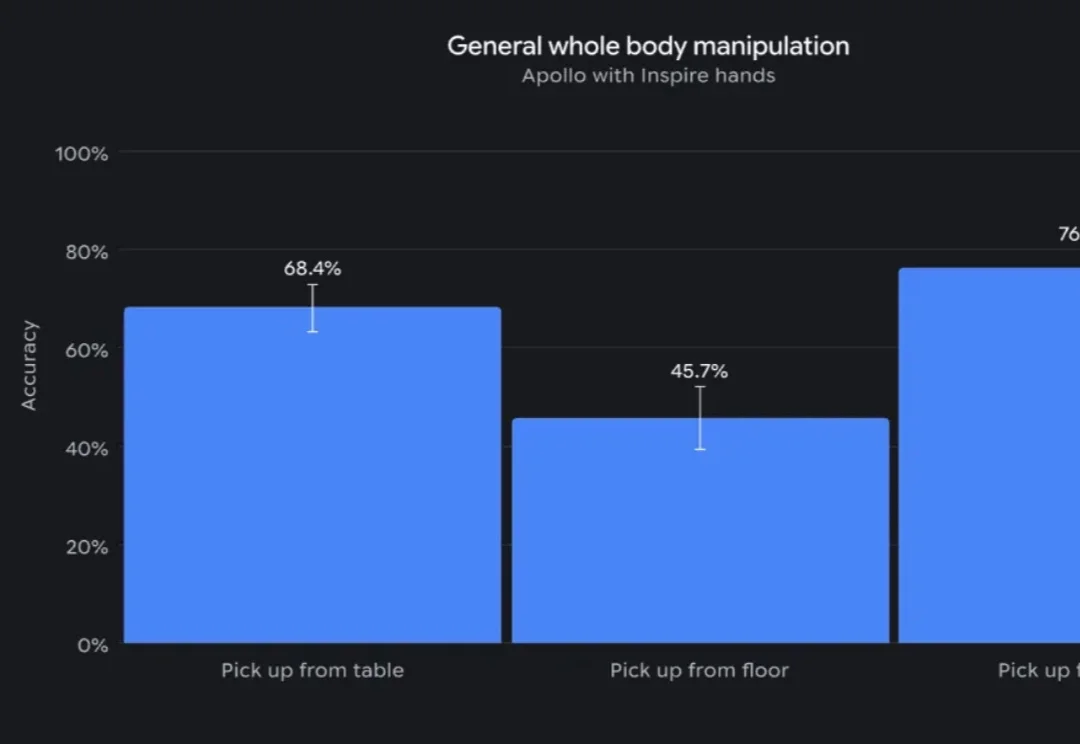
谷歌:在LLM圈里我唯唯诺诺,在机器人圈里我直接大打出手!
硬氪获悉,Physical AI平台公司「昆腾动力(Quantum Dynamics)」近日完成超亿元种子轮融资,本轮由云启资本、商汤国香资本联合投资。资金将主要用于Physical AI核心技术研发、人才梯队建设及全球化市场拓展,加速其面向物理世界的智能系统从底层模型到场景化落地的全链路构建。多维资本参与项目孵化与团队组建。