单一作者论文,谷歌提出百万专家Mixture,超越密集前馈、稀疏MoE
单一作者论文,谷歌提出百万专家Mixture,超越密集前馈、稀疏MoE释放进一步扩展 Transformer 的潜力,同时还可以保持计算效率。
来自主题: AI技术研报
11445 点击 2024-07-10 18:39

 搜索
释放进一步扩展 Transformer 的潜力,同时还可以保持计算效率。
神经网络拟合数据的能力受哪些因素影响?CNN一定比Transformer差吗?ReLU和SGD还有哪些神奇的作用?近日,LeCun参与的一项工作向我们展示了神经网络在实践中的灵活性。
全球首个芯片设计开源大模型SemiKong正式发布,基于Llama 3微调而来,性能超越通用大模型。未来5年,SemiKong或将重塑价值5000亿美元的半导体行业。

面对GenAI的技术浪潮,很多人都会在不断迭代更新的技术中逐渐迷失。站在潮头的Sapphire、Emergence、Menlo等风投公司,又会如何看待这场AI变局的现状与走向?
就在昨天,OpenAI正式封锁了中国地区API,但微软却向开发者们大方伸出橄榄枝:速来Azure!与此同时,中国大模型,已经准备好了一波爆发。
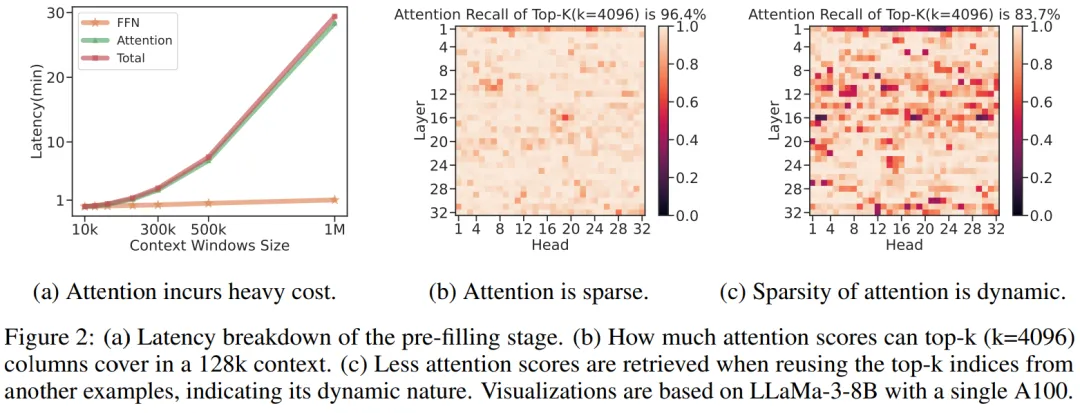
微软的这项研究让开发者可以在单卡机器上以 10 倍的速度处理超过 1M 的输入文本。
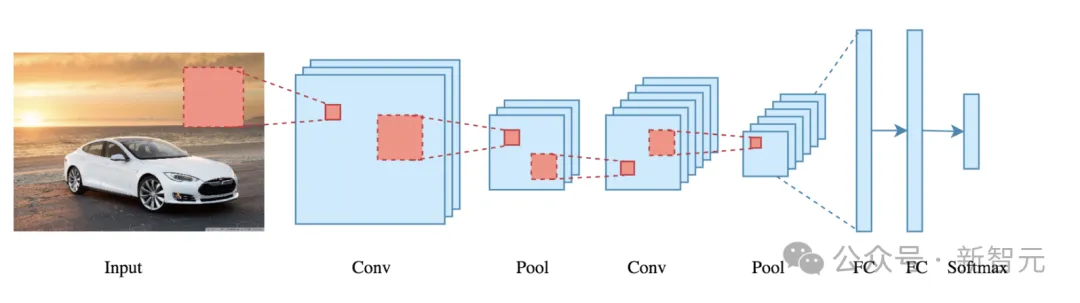
下一代视觉模型会摒弃patch吗?Meta AI最近发表的一篇论文就质疑了视觉模型中局部关系的必要性。他们提出了PiT架构,让Transformer直接学习单个像素而不是16×16的patch,结果在多个下游任务中取得了全面超越ViT模型的性能。
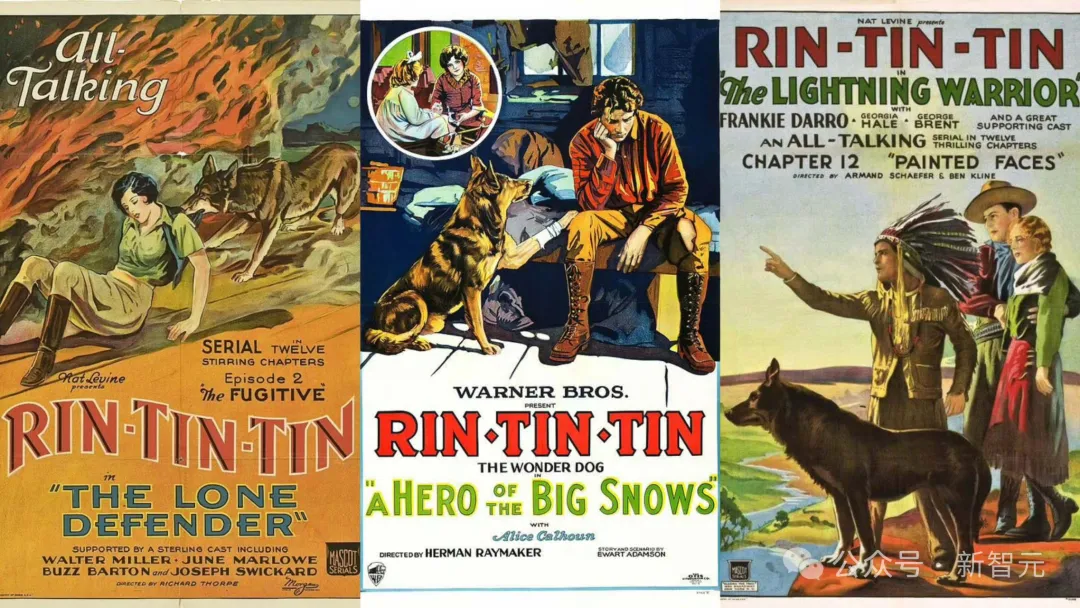
今日,Odyssey视觉AI发布预告,这款获得GV 900万美元种子资金的创新技术,旨在用AI技术讲好电影故事。具备强大的视觉内容生成与控制能力,视觉效果对标好莱坞制作水平。

超越Transformer和Mamba的新架构,刚刚诞生了。斯坦福UCSD等机构研究者提出的TTT方法,直接替代了注意力机制,语言模型方法从此或将彻底改变。

人类采访了机器人,足足一个多小时,还是对答如流的那种!