ICML 2024 | 脱离LoRA架构,训练参数大幅减少,新型傅立叶微调来了
ICML 2024 | 脱离LoRA架构,训练参数大幅减少,新型傅立叶微调来了本文介绍了香港科技大学(广州)的一篇关于大模型高效微调(LLM PEFT Fine-tuning)的文章「Parameter-Efficient Fine-Tuning with Discrete Fourier Transform」
来自主题: AI技术研报
13408 点击 2024-05-26 13:50

 搜索
本文介绍了香港科技大学(广州)的一篇关于大模型高效微调(LLM PEFT Fine-tuning)的文章「Parameter-Efficient Fine-Tuning with Discrete Fourier Transform」

为了将大型语言模型(LLM)与人类的价值和意图对齐,学习人类反馈至关重要,这能确保它们是有用的、诚实的和无害的。在对齐 LLM 方面,一种有效的方法是根据人类反馈的强化学习(RLHF)。尽管经典 RLHF 方法的结果很出色,但其多阶段的过程依然带来了一些优化难题,其中涉及到训练一个奖励模型,然后优化一个策略模型来最大化该奖励。

个人电脑原型的创造者、数字时代的「建筑师」Gordon Bell逝世,他曾提出过计算机系统领域的Bell定律,当选为美国国家工程院院士和科学院院士,获得过IEEE约翰·冯·诺依曼奖章,ACM在并行计算领域的Gordon Bell Prize就是由他赞助成立的。
央企通信巨头再次奏响大模型舞台的超强音!刚刚结束的中国移动人工智能生态大会主旨论坛上,中国移动发布了全自研「九天」千亿多模态基座大模型,一举成为国内最值得信赖、最懂行业的全栈大模型。
5月22号,百川智能正式发布了Baichuan 4大模型,并推出成立之后的首款AI搜索助手“百小应”。
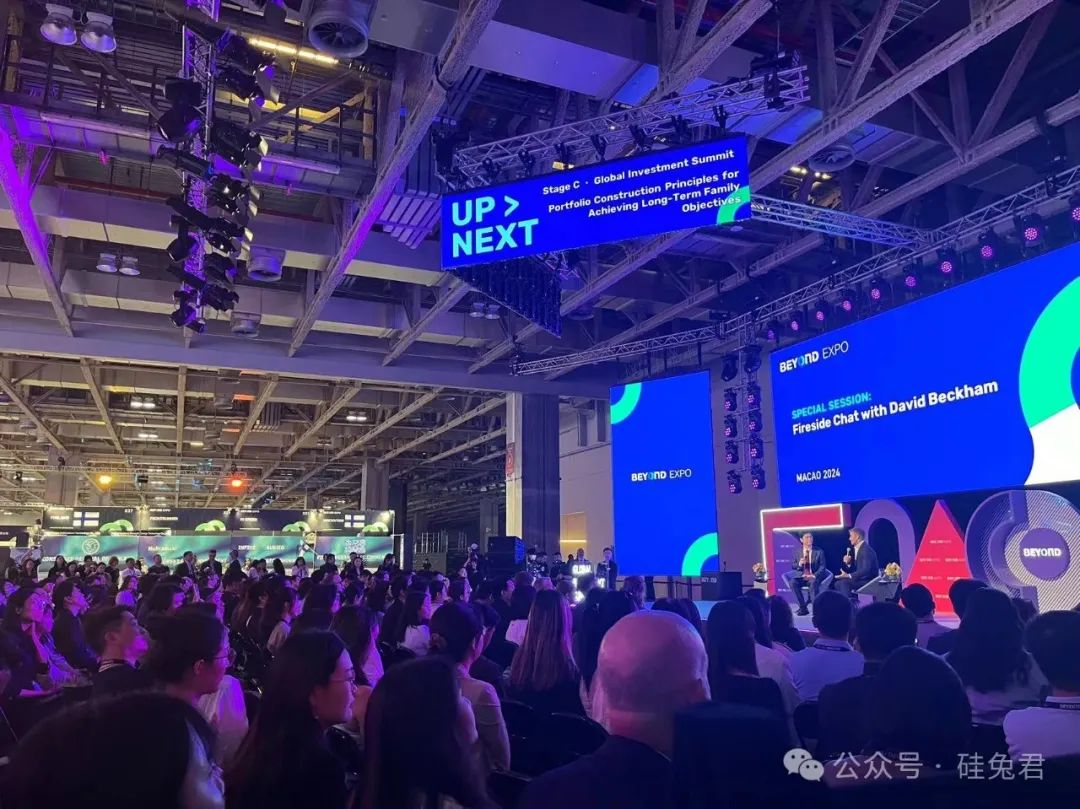
一览Beyond Expo 2024上的有趣发现。

到底是什么割裂了厂商和消费者?
马斯克在VivaTech大会上称:只有我能做好AI。
第一个以「泛化」能力为核心设计原则的可学习图像匹配器来了!
既能像 Transformer 一样并行训练,推理时内存需求又不随 token 数线性递增,长上下文又有新思路了?