港科大新发现:MoE路由很脆弱!重复token输入阻塞负载均衡 | ICML'26
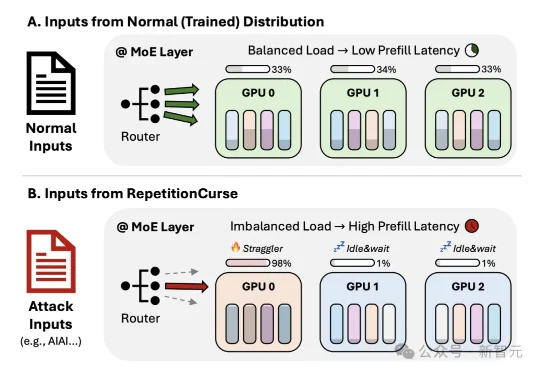
港科大新发现:MoE路由很脆弱!重复token输入阻塞负载均衡 | ICML'26来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
搜索
来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
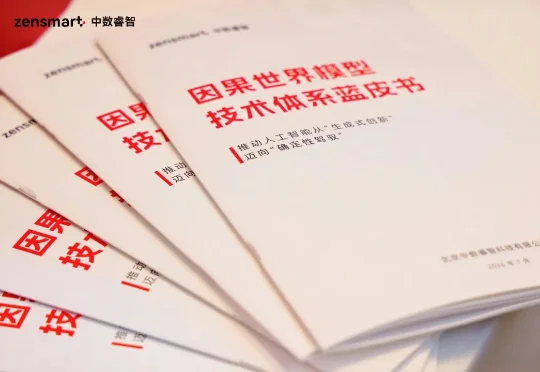
WAIC期间,中数睿智发布了“AI for Reasoning”因果智能体系,针对的就是这些痛点。比如油气钻井的井控场景,井下压力和流量突然不对劲,系统不只是输出一句“存在风险”,而是能沿因果链定位病因,并推演多条干预路径:不处置会怎样?立即关井会怎样?延迟处置能撑多久、代价是什么?辅助企业在事故发生前做出最优决策。
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
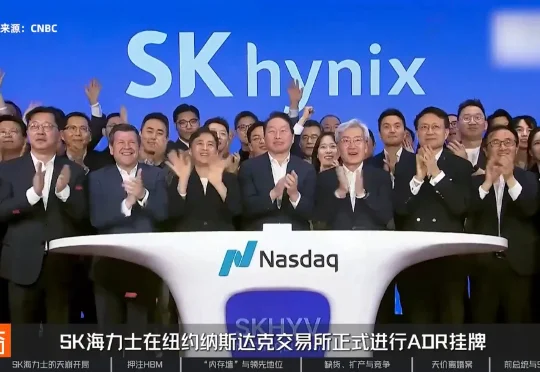
在刚刚过去的7月10日,韩国存储芯片巨头SK海力士正式登陆纽约纳斯达克交易所进行ADR挂牌,当日股价大涨 12.76%,盘中最高涨幅一度超过19%。此次IPO共融资265亿美元,刷新了阿里巴巴保持十余年的海外企业赴美融资纪录,也成为了美国历史上第二大股票发行,这也使得SK海力士的总市值超过1万亿美元。
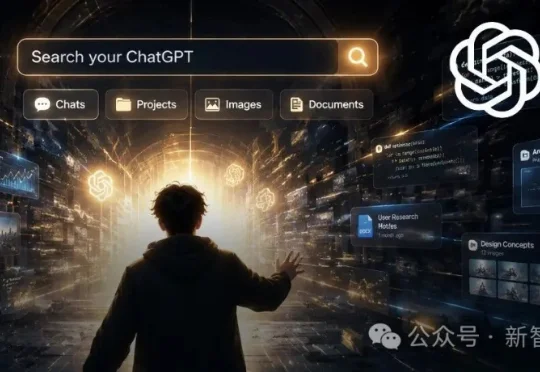
在OpenAI开发者社区,苦这个旧搜索久矣: 终于能找到那条消息了,为什么拖了这么久;那个老搜索栏,从来就没好用过;会话一多,搜旧对话就变得不可能;翻旧对话简直成了噩梦……
直出8K长卷,中国AI还是首次!就在今天,WAIC大会上,商汤正式发布下一代「满血旗舰」——日日新SenseNova-U1 Pro。 这是业界头一回,把「看懂、生成、动手」原生做进了同一个多模态基座的底层。
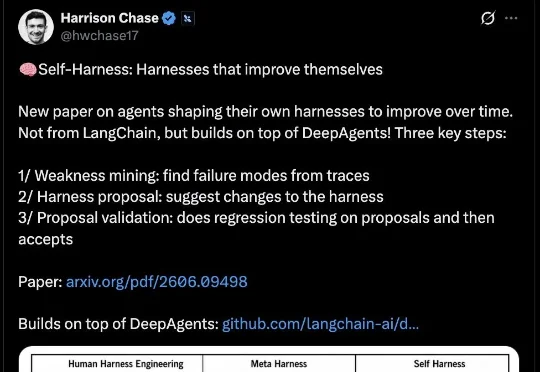
上海人工智能实验室团队提出的Self-Harness,近期被LangChain CEO、联合创始人Harrison Chase转发,也被前OpenAI副总裁Lilian Weng收进自进化Agent相关博客。它盯上的不是换模型,而是Agent外层那套Harness。
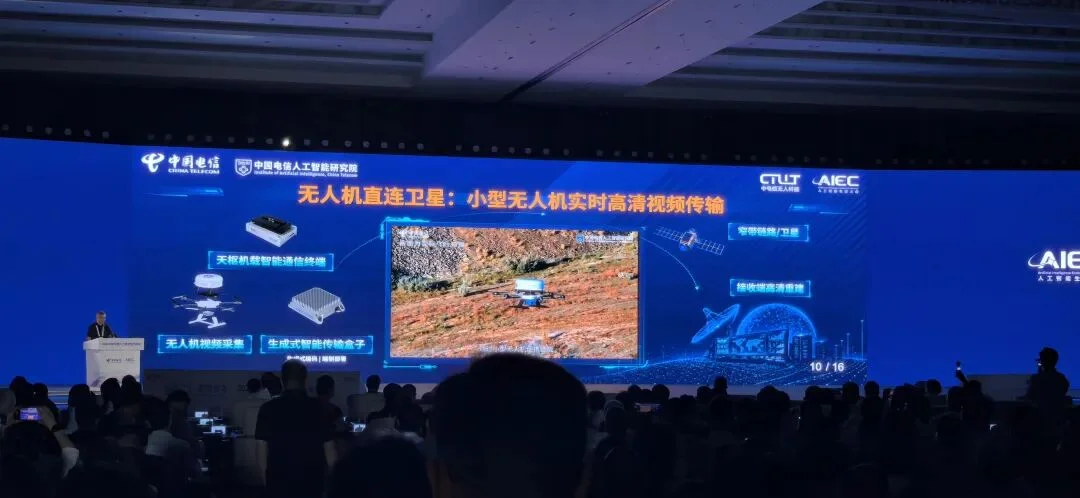
这便是中国电信人工智能研究院(TeleAI),刚刚在WAIC 2026提出的新技术路线;其背后这套融合AI、通信和网络的技术体系,则是智传网(AI Flow)。就在此次发布前一天,智传网(AI Flow)还拿下了WAIC大会最高奖项卓越人工智能引领者奖(SAIL)中的赋能(Applicative)奖。
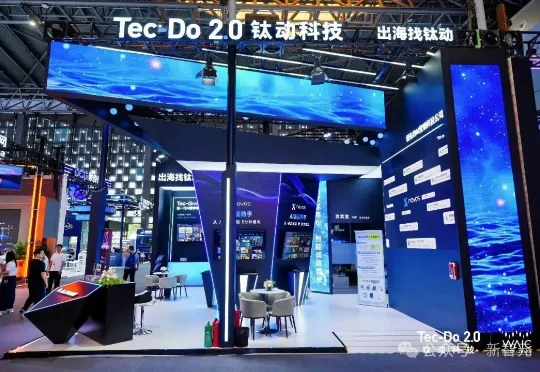
刚刚,钛动科技在 WAIC 上发布了 Navos 2.0,把多智能体产品从网页对话框升级为智能体工作流架构。本月初,钛动还与 OpenAI 正式达成了合作并签约。创始人兼 CEO 李述昊给公司取了两个词拼成的名字——Tec-Do(用技术做生意),后面挂着版本号 2.0,含义是「像做产品一样做公司」(Develop Company as Product)——Tec-Do 2.0。
7 月 16 日,伯克利博士后 Haven Feng 的一条推文火了。原因无他,结果很震撼:在 ARC-AGI-3 Public 集上,一套名为 [schema] 的智能体框架,与 Claude Opus 4.8、Fable 5 组合后达到 98.98% 的 RHAE;换成 GPT-5.6 Sol 组合,分数也有 95.35%。