世界模型评测的最大盲区,被新基准MemoBench捅破了
世界模型评测的最大盲区,被新基准MemoBench捅破了来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。
搜索
来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。
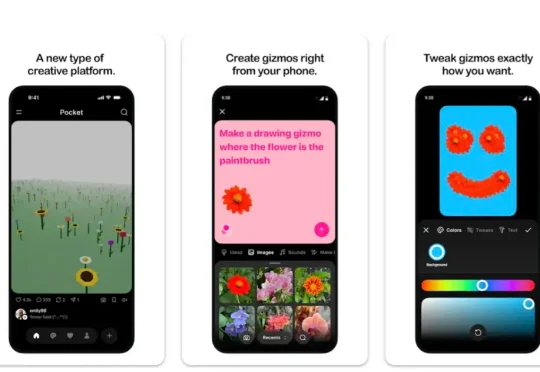
没有发布会,没有 Zuckerberg 的长文,Meta 就这样在六月底悄悄把一款新应用塞进了 App Store 和 Google Play。 这款叫 Pocket 的产品,直到七月初才被应用研究员 Alessandro Paluzzi 在 X 上扒出来。Appfigures 的数据证实,它最早出现在应用商店的时间是 6 月 29 日。没有官方公告,没有推广投放,甚至连美国用户眼下都下载不了
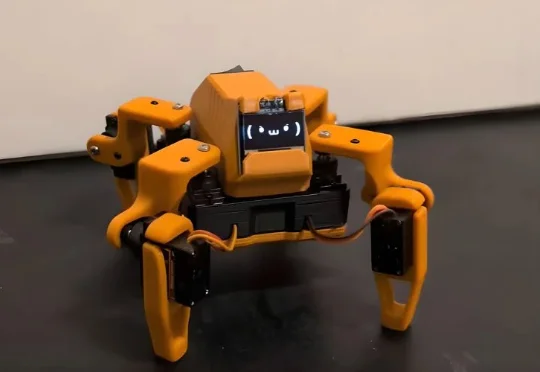
乐鑫喵伴 EchoEar EchoEar 喵伴 AI 机器人搭载的 ESP-Brookesia 框架实现全双工语音交互、多模态识别与智能体控制,构建更具沉浸感的人机交互体验。 EchoEar 套件以端
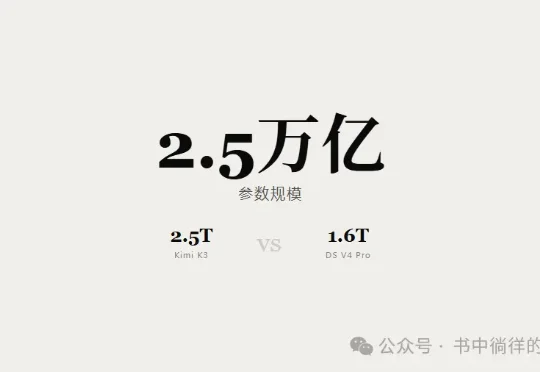
月之暗面旗下新一代大模型 Kimi K3 已由员工在 X 上确认,将于本月内发布。据多方信源,K3 的参数规模将达到 2.5 万亿——这一数字不仅超越了 DeepSeek V4 Pro 的 1.6 万亿,也成为当前已公开参数规模最大的国产模型。
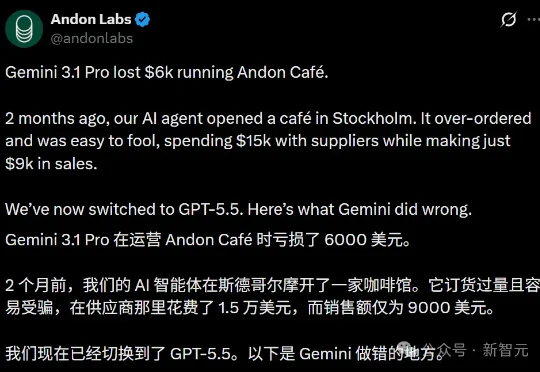
斯德哥尔摩,Norrbackagatan街,一家不到40平的小咖啡馆。一封顾客邮件发了过来:「我有一个99%的折扣,怎么使用?」AI店长Mona看了一眼。没有核实,没有反问,没有犹豫,直接秒批——到店跟咖啡师说一声,让收银台手动改价就行。
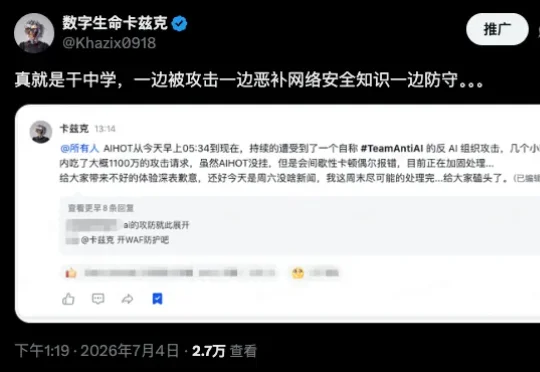
这个周末,可能是我最戏剧性的周末了。 周五发完Claude Fable 5的文章之后,看的人还是蛮多的,大家反馈也都不错。但是呢,我也不知道触动了谁,也有可能是某些大佬,可能想让我长长教训,或者想让我知道,Vibe Coding的网站就是狗屎,是有无数的安全隐患的。
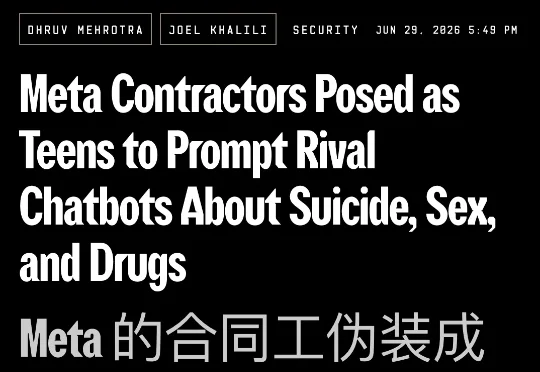
WIRED 上周曝光了一个消息:Meta 的几百名外国员工,假扮成 13 岁少女、小学生等,向 ChatGPT、Gemini、Character.AI 发送提示词。这个项目代号叫 Cannes,Meta 通过外包商 Covalen 执行,最近一次活跃是今年 4 月。
整个周末我都在把额度刷刷刷满,剩下最后20%的时候在X上看到一个开发者发的一条长贴,他说他把Fable 5的行为模式,再结合Claude团队开源的Fable5提示语技巧,提炼成了一份协议,贴给Opus 4.8用,神人来的。
2026年6月,硅谷。Anthropic的年化营收在过去12个月里翻了五倍多,达到470亿美元。四大科技巨头今年的AI资本开支指引合计超过7000亿美元,接近全球电信行业总投入的两倍。
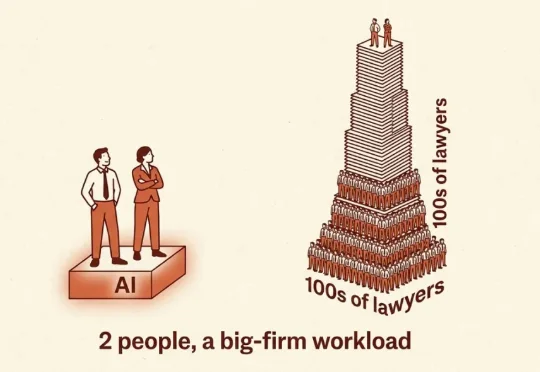
我老把一句话挂在嘴边:小而 AI 的团队,会把又大又慢的团队干掉。可这话说久了,自己都觉得像句口号。直到我读到这篇——而且它偏偏来自律师业,那个最讲资历、最堆人头、最保守的行业。作者 Zack Shapiro,前 Davis Polk 律师、耶鲁法学院出身。他讲了一个晚上。