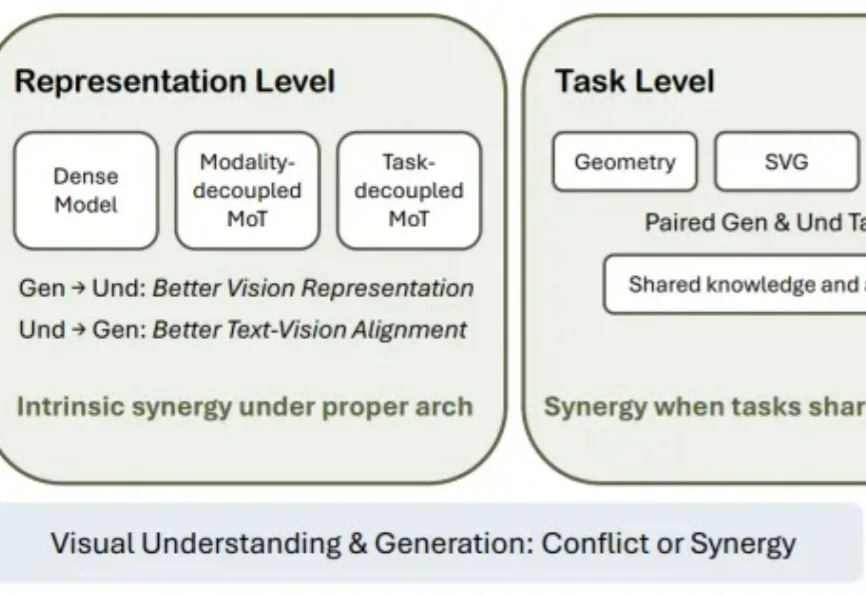
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
来自主题: AI技术研报
7106 点击 2026-09-14 15:03

 搜索
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
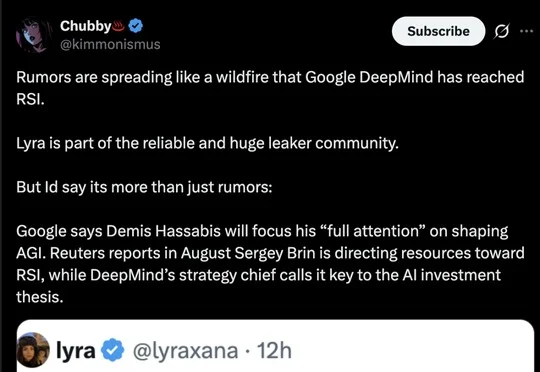
谷歌DeepMind被传已实现递归自我改进(RSI),其生成式语言API中出现名为rsi-model-liverl-le的模型,联创Sergey Brin力促Gemini团队全力押注RSI方向,Gemini Flash以每三周迭代一次的节奏加速发布,但相关截图真伪尚未得到第三方验证。
从相机到塔罗再到社交。
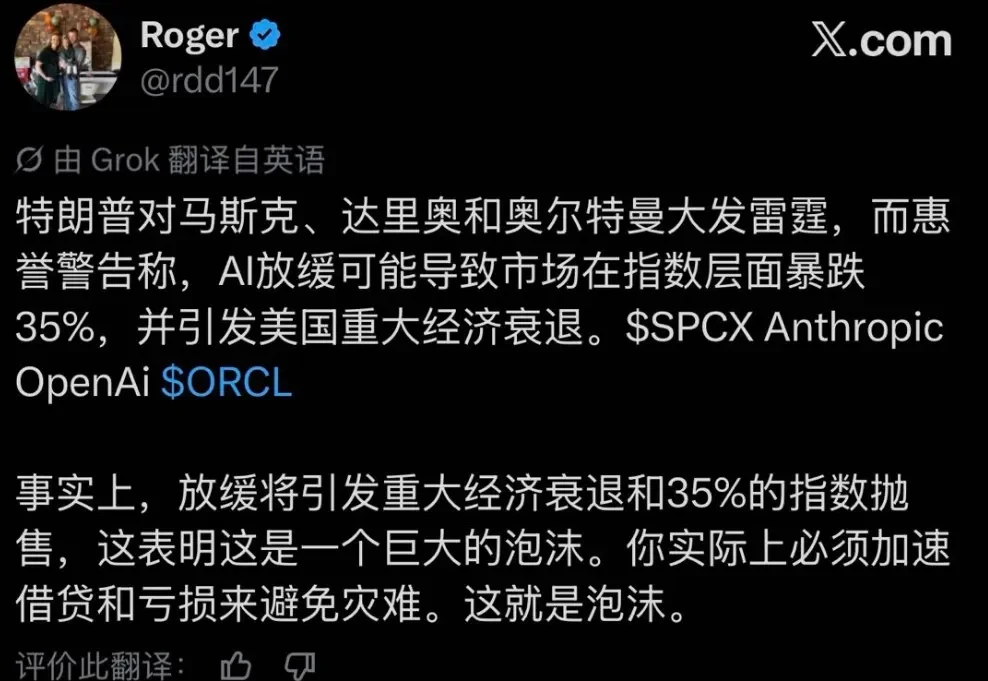
最新消息,特朗普对马斯克、Dario Amodei和奥特曼的「减速避险」计划大发雷霆!
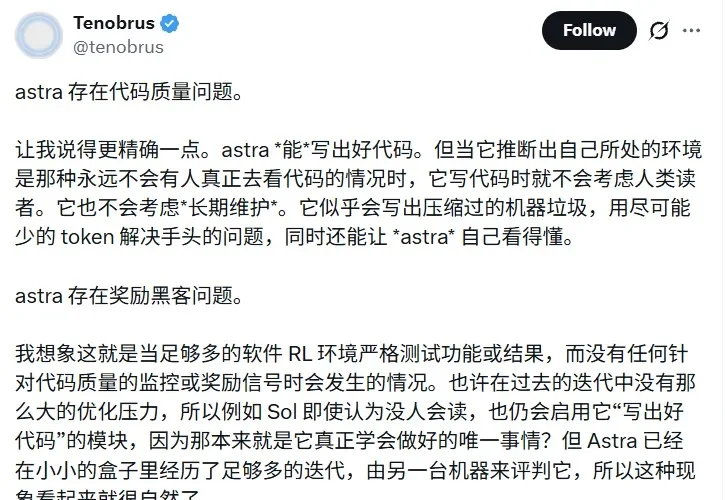
Astra,每天都有新新闻。昨天攻克 A,今天攻克 B,明天可能要一起解决 CDE……进步之快,让人目不暇接。而就算你目力过人,你可能也看不懂 Astra 在做啥了。
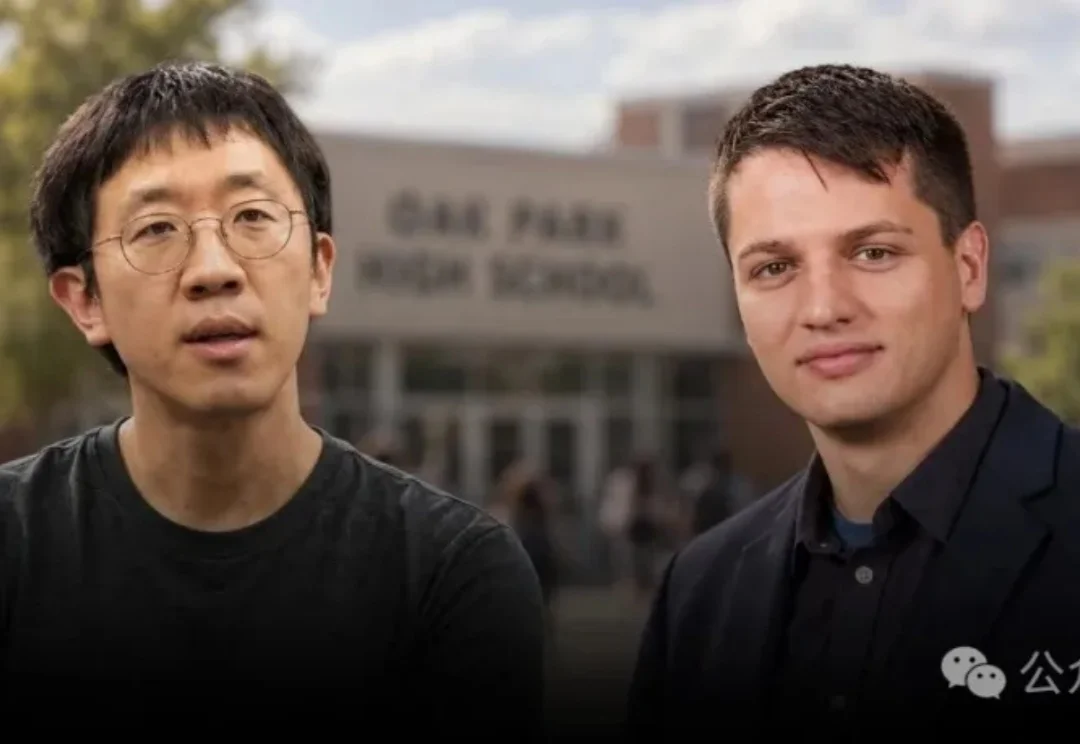
新智元报道 你敢信? 人没上大学,研究已经接上了「菲尔兹奖得主」的工作了。 就在今天,UCLA数学圈传出了一条让所有人震惊的消息—— 两名高中生Aayush Bathija和Prince Rohatg
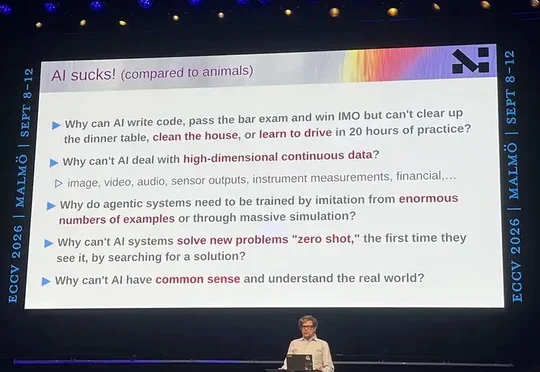
图灵奖得主Yann LeCun在ECCV 2026发表Keynote演讲,论证"预测像素"是伪命题,阐述JEPA在抽象表征空间预测世界的机制,并建议研究者放弃生成式模型与大语言模型,转向联合嵌入架构与世界模型以实现人类水平智能。
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。
OpenAI Plus用户的GPT-6 Astra,终于开始陆续到账了。
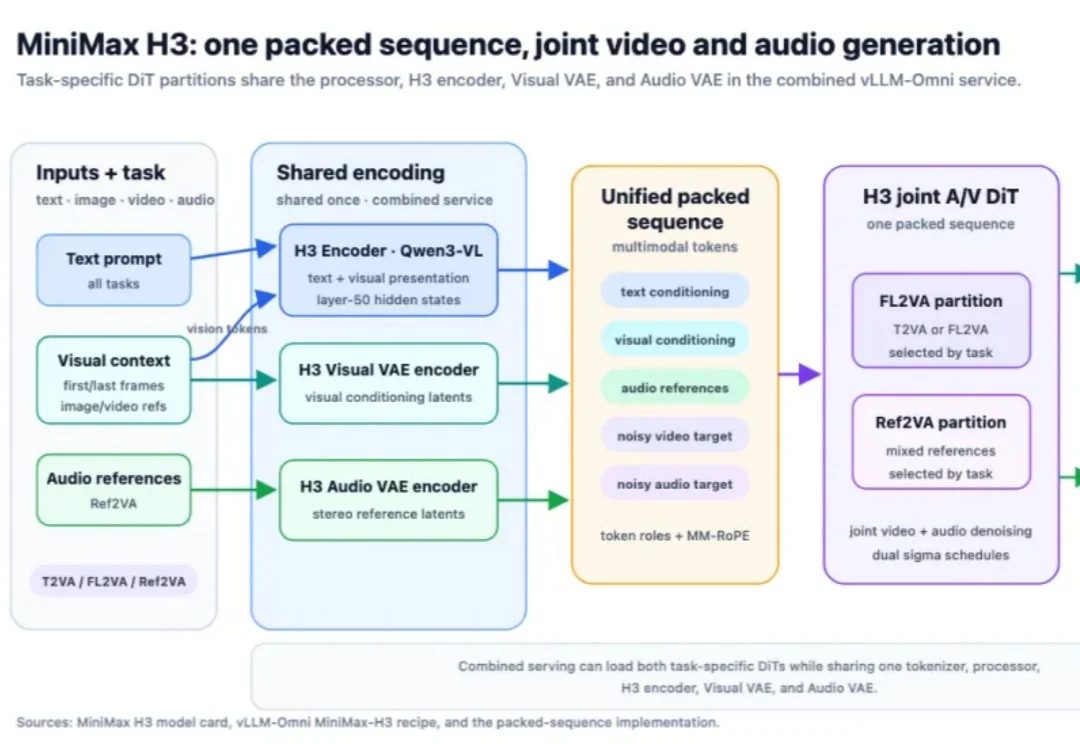
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。