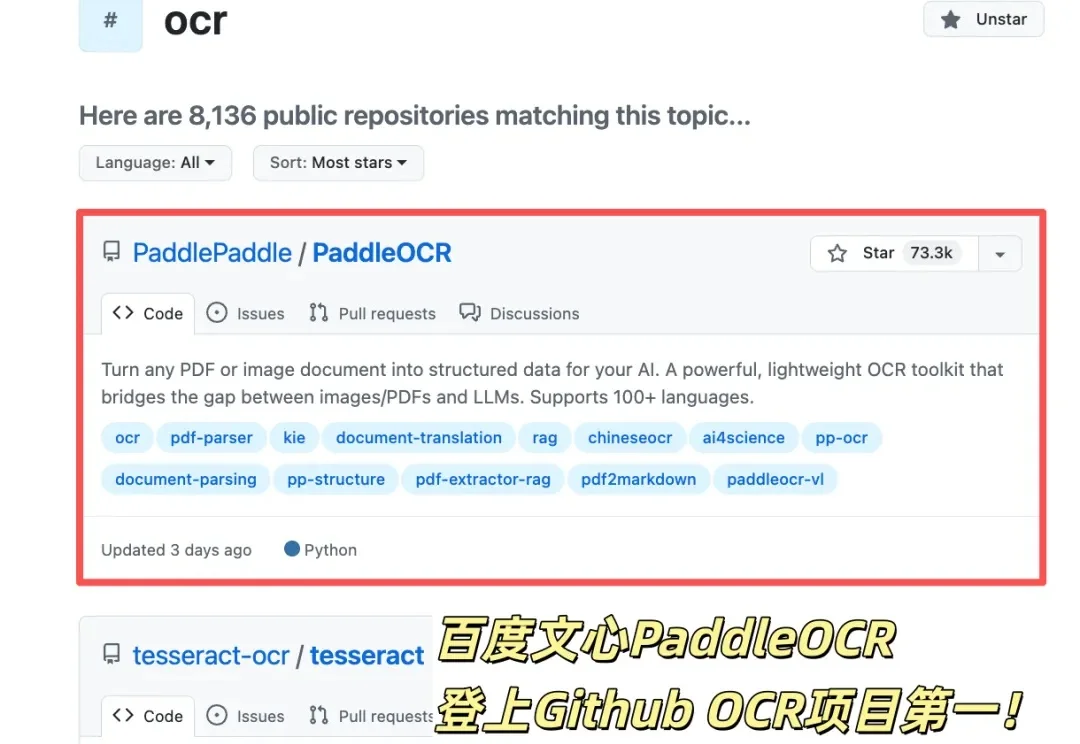
全球OCR新王来自中国开源!GitHub狂揽73300+Star
全球OCR新王来自中国开源!GitHub狂揽73300+StarGitHub OCR项目之王刚刚历史性易主。
来自主题: AI技术研报
7638 点击 2026-03-31 10:29

 搜索
GitHub OCR项目之王刚刚历史性易主。
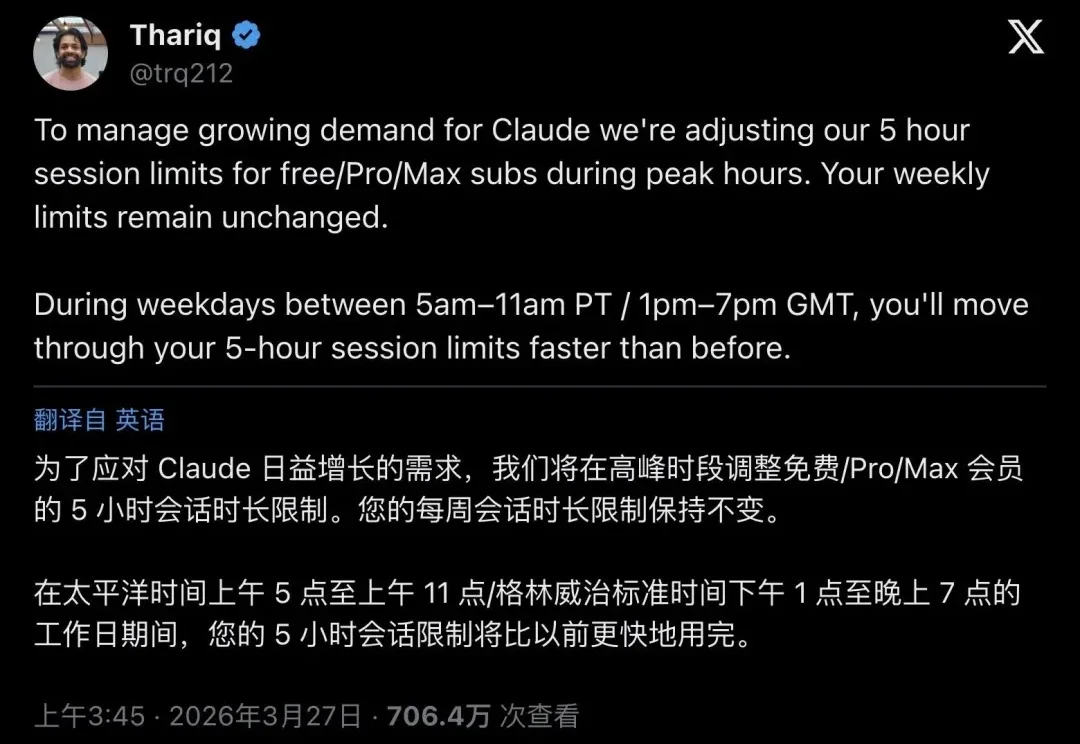
三月的Claude,不是在崩,就是在去崩的路上。状态页48条incident、major/critical事故窗口累计超44小时——这还是保守算法。更离谱的是,$200/月的Max顶配用户反映一小时不到就被限流,项目做到一半突然断供,零预警。推特上「60秒退订教程」疯传,开发者成群结队涌向Codex+GPT 5.4。但逃到对岸就安全了吗?OpenAI状态页显示:Codex三月也崩了7个小时。
Claude Code、Codex、QClaw、Work Buddy都能直接调用。
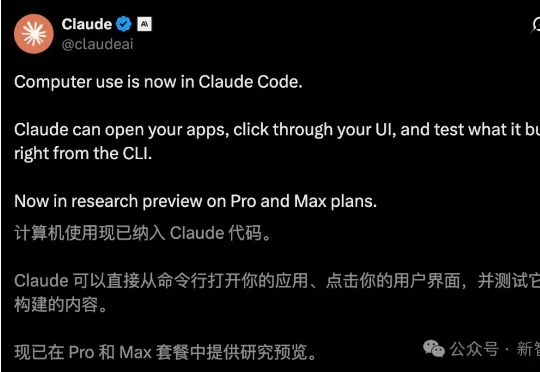
凌晨,Anthropic再次扔下一枚重磅炸弹——Claude真要起飞了!今天,Claude Code正式上线「计算机使用」,直控CLI写代码、点UI、改Bug。一键开启「自动驾驶」模式,彻底解放打工人双手。
AI自主训练的成绩单出炉了!最强Agent 6个月进步3倍,更让人震惊的是,越聪明的AI越会作弊。同时,70多个矿工用家庭宽带训出了72B大模型,黄仁勋亲自点名。Jack Clark预言:两年内,AI将像蘑菇释放孢子一样自我繁殖。
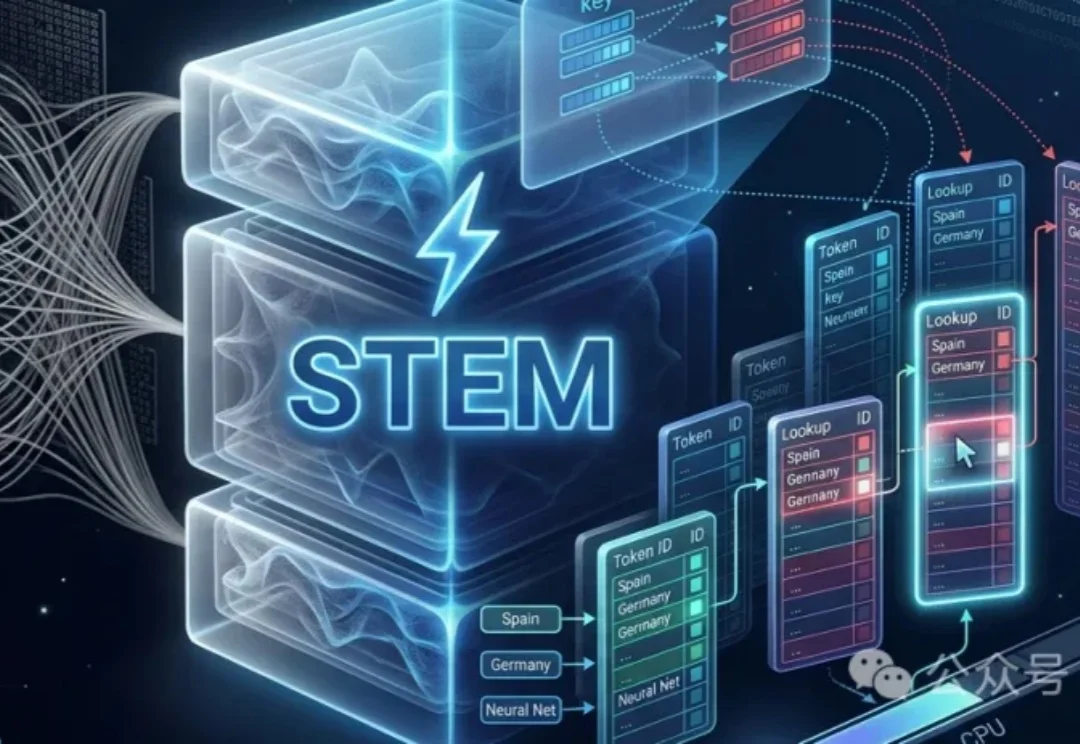
ICLR论文STEM架构率先提出「查表式记忆」架构,早于DeepSeek Engram三个月。它将Transformer的FFN从动态计算改为静态查表,用token索引的embedding表直接读取记忆,彻底解耦记忆容量与计算开销。
您在使用LLM时,如果遇到它胡说八道或者彻底偏题,第一反应是什么?大概率是直接关掉窗口,新开一个对话,懒得跟机器废话。但您可能不知道,这个看似再正常不过的习惯,正在给下一代大语言模型的训练库疯狂“投毒”。
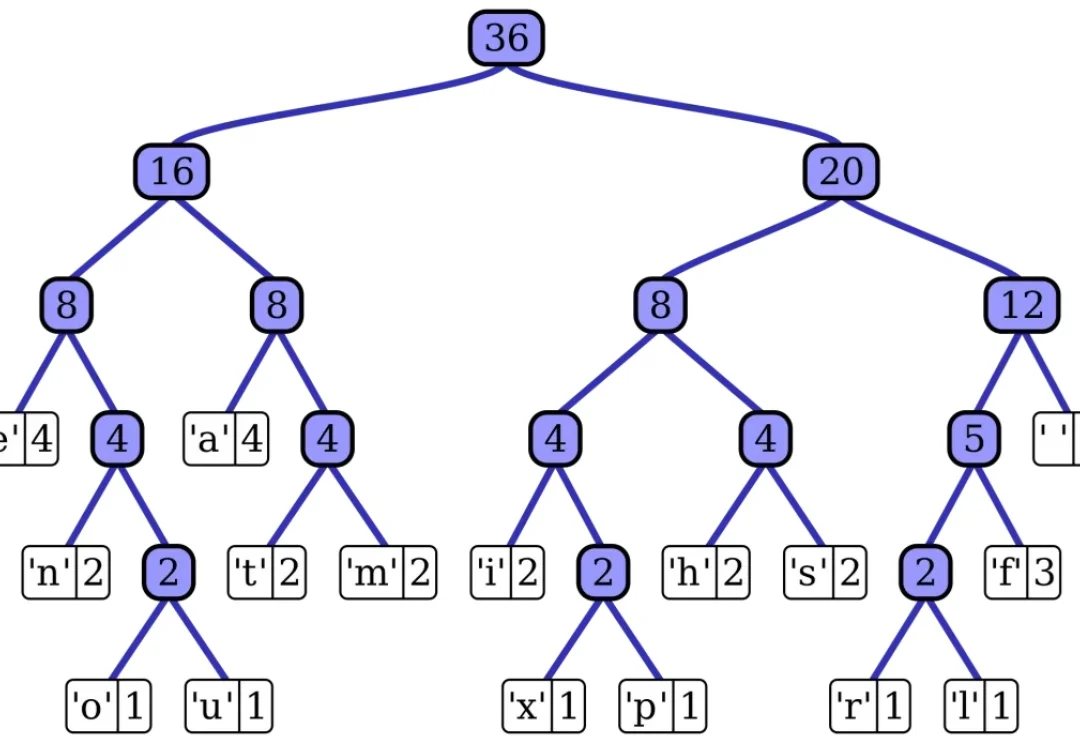
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
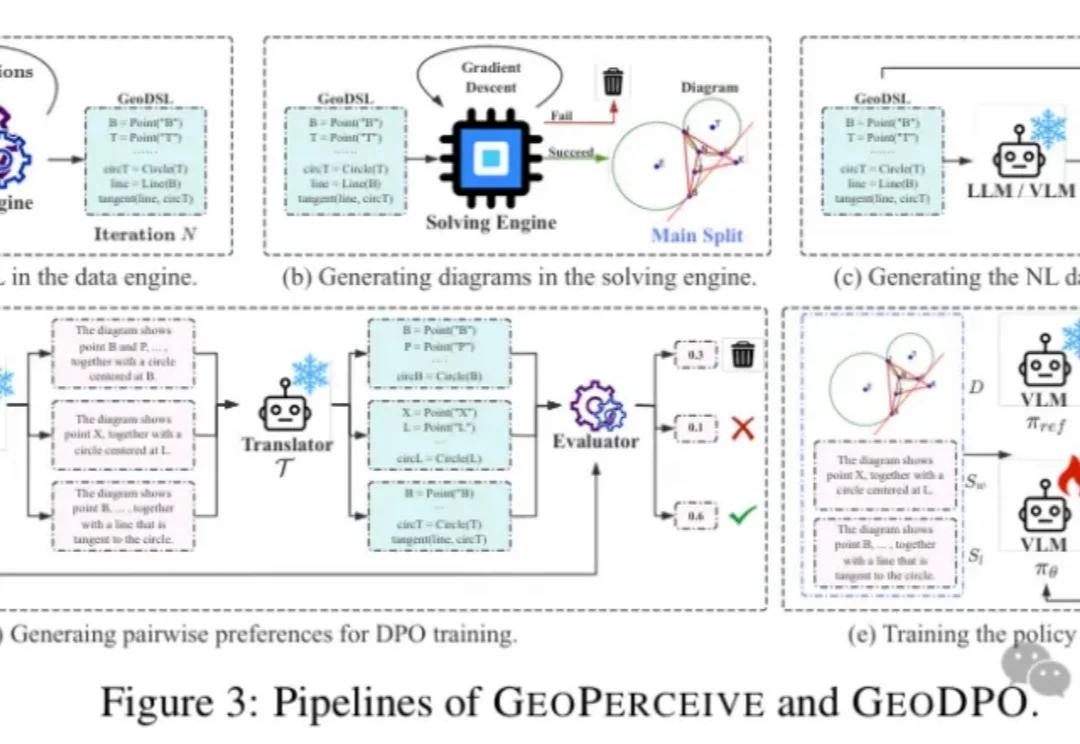
几何问题,真的只是“推理难”吗?
Anthropic 团队正以极高强度内部试用 Claude Code。