GPT-5≈o3.1!OpenAI首次详解思考机制:RL+预训练才是AGI正道
GPT-5≈o3.1!OpenAI首次详解思考机制:RL+预训练才是AGI正道在某种程度上,GPT-5可以被视作是o3.1。 该观点出自OpenAI研究副总裁Jerry Tworek的首次播客采访,而Jerry其人,正是o1模型的主导者之一。
来自主题: AI资讯
8708 点击 2025-10-20 15:26

 搜索
在某种程度上,GPT-5可以被视作是o3.1。 该观点出自OpenAI研究副总裁Jerry Tworek的首次播客采访,而Jerry其人,正是o1模型的主导者之一。
全新一代 video-SALMONN 2/2+、首个开源推理增强型音视频理解大模型 video-SALMONN-o1(ICML 2025)、首个高帧率视频理解大模型 F-16(ICML 2025),以及无文本泄漏基准测试 AVUT(EMNLP 2025) 正式发布。新阵容在视频理解能力与评测体系全线突破,全面巩固 SALMONN 家族在开源音视频理解大模型赛道的领先地位。
就在 Scale AI 公司的 95 后创始人 Alexandr Wang 在 Meta 挑大梁之际,他迎来了一位比他更小的 00 后劲敌。这名 00 后叫阿里·安萨里(Ali Ansari),是一名
您对“思维链”(Chain-of-Thought)肯定不陌生,从最早的GPT-o1到后来震惊世界的Deepseek-R1,它通过让模型输出详细的思考步骤,确实解决了许多复杂的推理问题。但您肯定也为它那冗长的输出、高昂的API费用和感人的延迟头疼过,这些在产品落地时都是实实在在的阻碍。
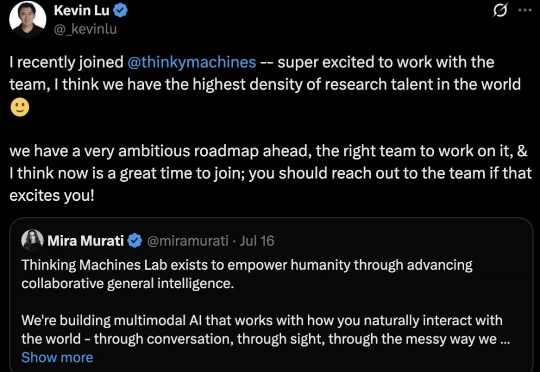
哦豁,OpenAI奥特曼又痛失一员大将。 Kevin Lu,领导4o-mini发布,并参与o1-mini、o3发布,主要研究强化学习、小模型和合成数据。
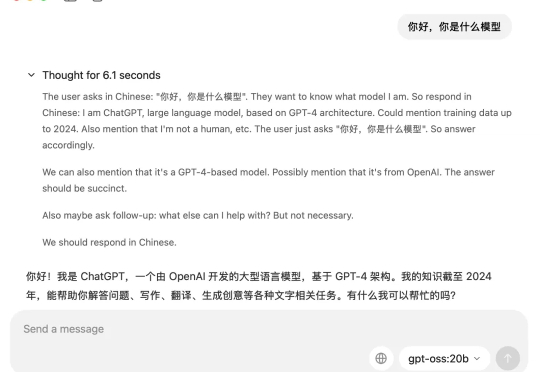
gpt-oss-120b 和 gpt-oss-20b OpenAI终于把开源的模型放出来了。 gpt-oss系列也是自GPT2以来,OpenAI首次开源的大语言模型。
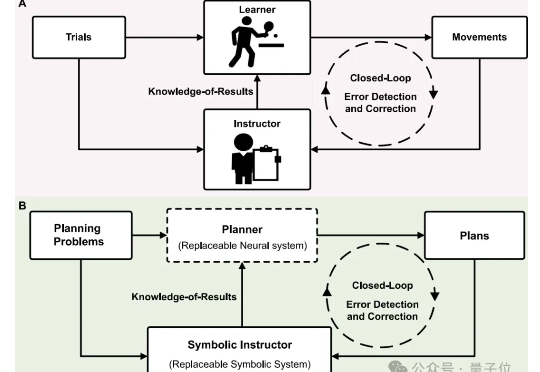
科研er看过来!还在反复尝试材料组合方案,耗时又耗力? 新型“神经-符号”融合规划器直接帮你一键锁定高效又精准的科研智能规划。
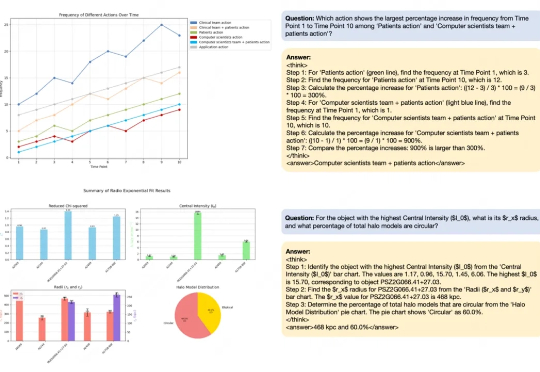
近期,随着OpenAI-o1/o3和Deepseek-R1的成功,基于强化学习的微调方法(R1-Style)在AI领域引起广泛关注。这些方法在数学推理和代码智能方面展现出色表现,但在通用多模态数据上的应用研究仍有待深入。
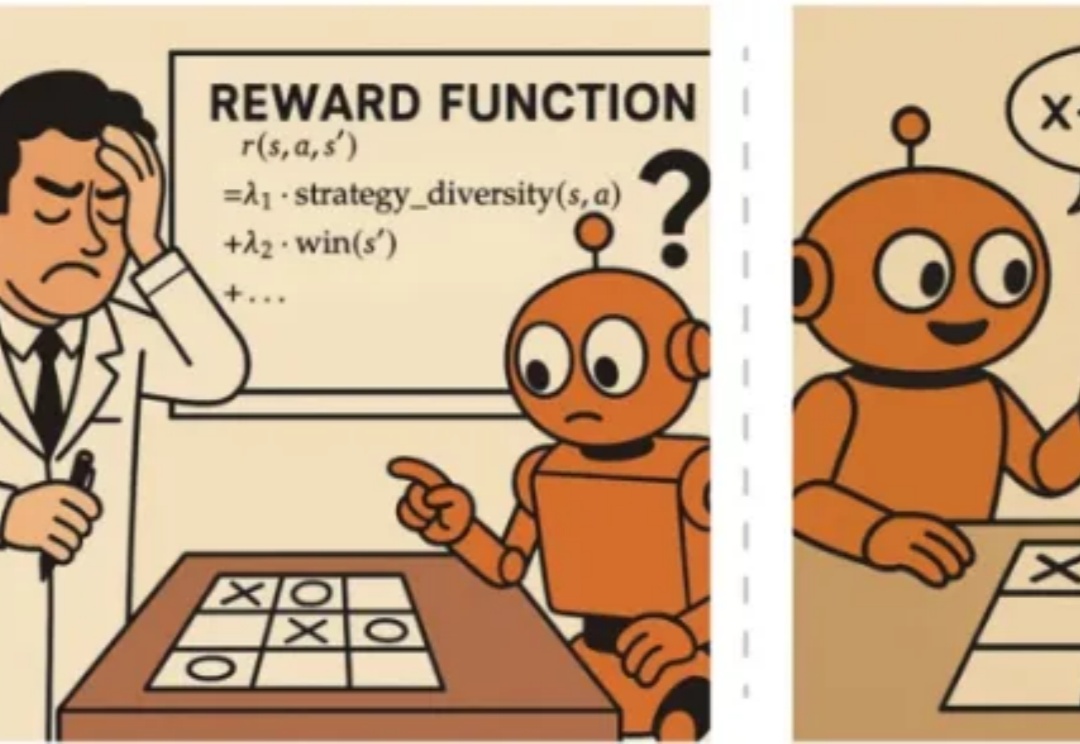
近年来,OpenAI o1 和 DeepSeek-R1 等模型的成功证明了强化学习能够显著提升语言模型的推理能力。通过基于结果的奖励机制,强化学习使模型能够发展出可泛化的推理策略,在复杂问题上取得了监督微调难以企及的进展。
小时候完成月考测试后,老师会通过讲解考试卷中吃错题让同学们在未来取得好成绩。