自制Agent门槛塌了,我把囤的垂直AI们全搬进了自己的工具流
自制Agent门槛塌了,我把囤的垂直AI们全搬进了自己的工具流虚假的商战, 不断发布新的模型保持技术优势; 真实的商战,Anthropic 单方面禁止AI编程编辑器 Windsurf 使用 Claude 模型,订阅用户都跑去隔壁 Cursor 了。
来自主题: AI资讯
9741 点击 2025-06-17 17:17

 搜索
虚假的商战, 不断发布新的模型保持技术优势; 真实的商战,Anthropic 单方面禁止AI编程编辑器 Windsurf 使用 Claude 模型,订阅用户都跑去隔壁 Cursor 了。
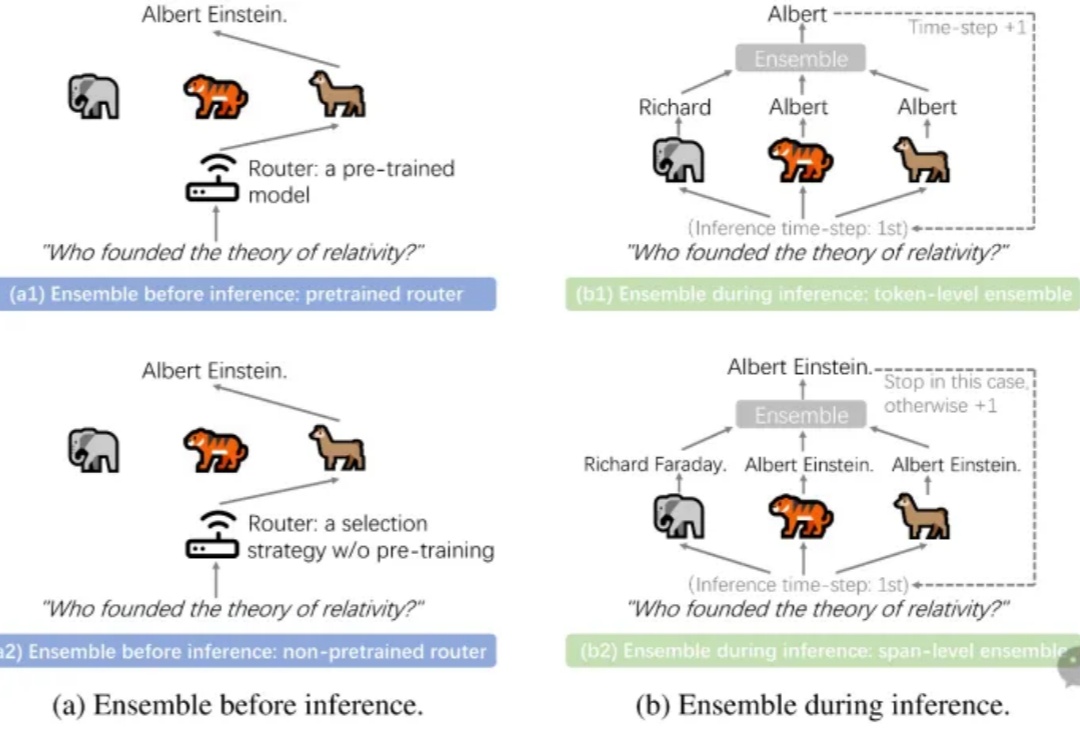
LLM Ensemble(大语言模型集成)在近年来快速地获得了广泛关注。它指的是在下游任务推理阶段,综合考虑并利用多个大语言模型(每个模型都旨在处理用户查询),从而发挥它们各自的优势。大语言模型的广泛可得性,以及其开箱即用的特性和各个模型所具备的不同优势,极大地推动了 LLM Ensemble 领域的发展。
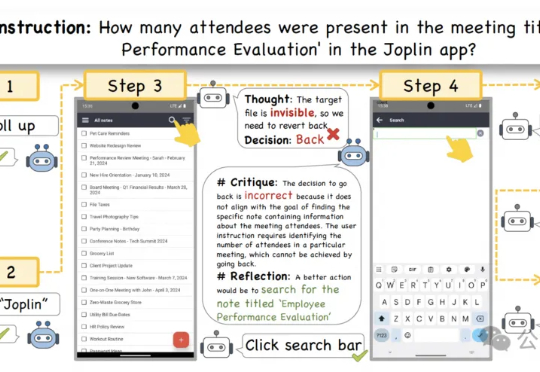
GUI智能体总是出错, 甚至是不可逆的错误。 即使是像GPT-4o这样的顶级多模态大模型,也会因为缺乏常识而在执行GUI任务时犯错。在它即将执行错误决策时,需要有人提醒它出错了。
NVIDIA等研究团队提出了一种革命性的AI训练范式——视觉游戏学习ViGaL。通过让7B参数的多模态模型玩贪吃蛇和3D旋转等街机游戏,AI不仅掌握了游戏技巧,还培养出强大的跨领域推理能力,在数学、几何等复杂任务上击败GPT-4o等顶级模型。
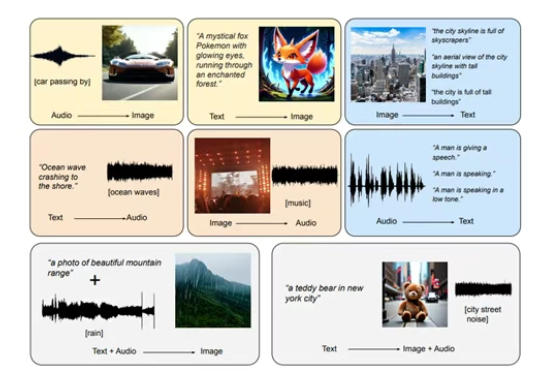
随着大模型的不断发展,多模态数据处理成为了新的热点领域。多模态生成任务主要通过整合多种类型的数据,如文本、图像、音频等,实现不同模态之间的相互转换与生成。
图像生成界的“大魔王”Midjourney也来卷视频生成了?!
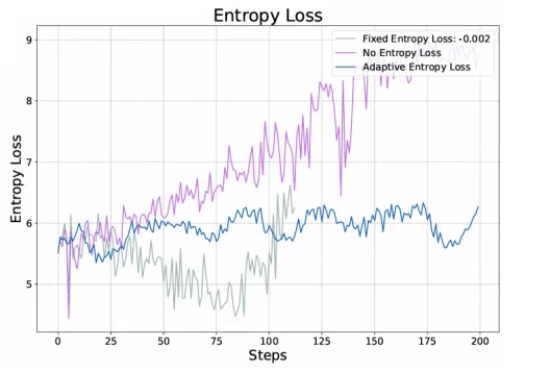
近年来,链式推理和强化学习已经被广泛应用于大语言模型,让大语言模型的推理能力得到了显著提升。
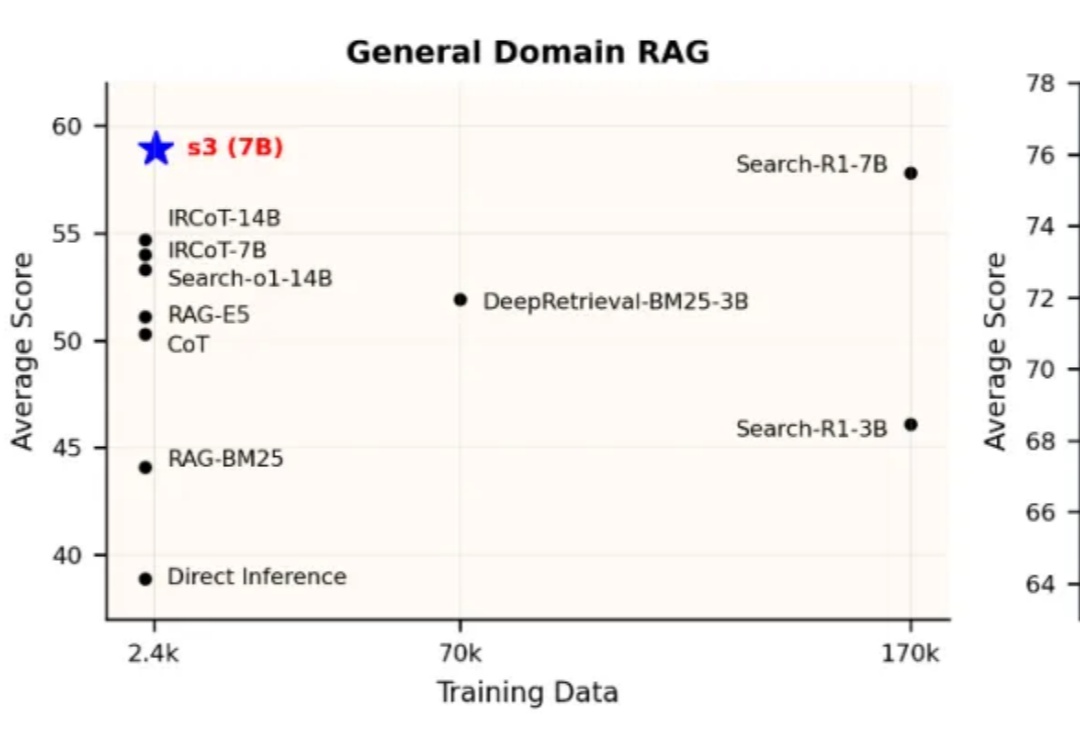
当前,Agentic RAG(Retrieval-Augmented Generation)正逐步成为大型语言模型访问外部知识的关键路径。但在真实实践中,搜索智能体的强化学习训练并未展现出预期的稳定优势。一方面,部分方法优化的目标与真实下游需求存在偏离,另一方面,搜索器与生成器间的耦合也影响了泛化与部署效率。
过去一段时间,“通用 Agent”成了 AI 应用的默认发展方向。无论产品叙事还是技术布局,大家似乎都在追求一个“什么都能做”的智能体。但现实逐渐显露:通用 Agent 在真实世界中并不那么“通用”。
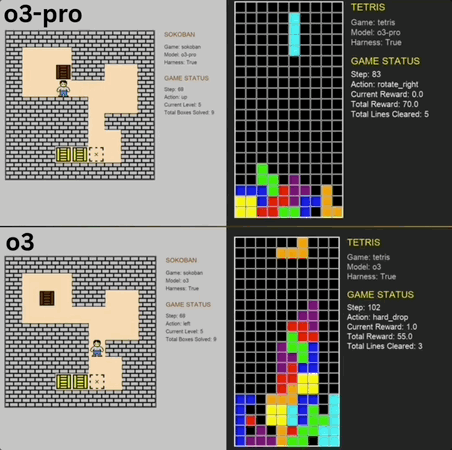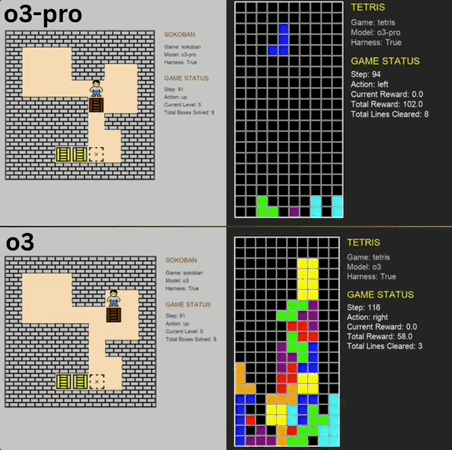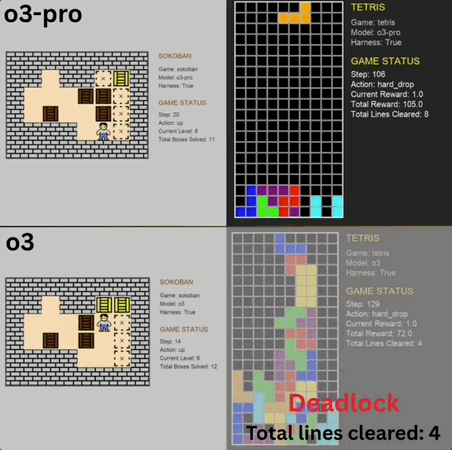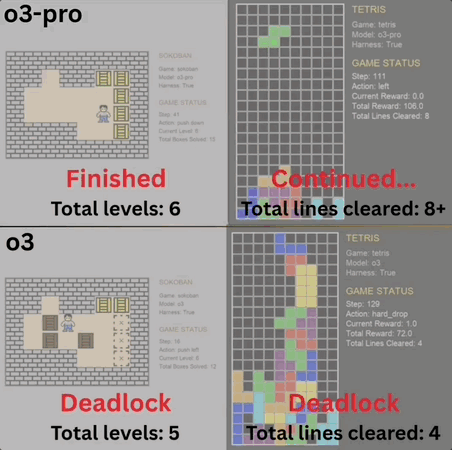
推箱子、俄罗斯方块……这些人类的经典怀旧小游戏,也成大模型benchmark了。 o3-pro刚刚也挑战了这两款游戏,而且表现还都不错,直接突破了benchmark上限