CMU清华教LLM练成数学高手,LeanSTaR训练模型边思考边证明,登顶新SOTA
CMU清华教LLM练成数学高手,LeanSTaR训练模型边思考边证明,登顶新SOTALLM数学水平不及小学生怎么办?CMU清华团队提出了Lean-STaR训练框架,在语言模型进行推理的每一步中都植入CoT,提升了模型的定理证明能力,成为miniF2F上的新SOTA。
来自主题: AI技术研报
8482 点击 2024-08-10 11:45

 搜索
LLM数学水平不及小学生怎么办?CMU清华团队提出了Lean-STaR训练框架,在语言模型进行推理的每一步中都植入CoT,提升了模型的定理证明能力,成为miniF2F上的新SOTA。
RLHF到底是不是强化学习?最近,AI大佬圈因为这个讨论炸锅了。和LeCun同为质疑派的Karpathy表示:比起那种让AlphaGo在围棋中击败人类的强化学习,RLHF还差得远呢。
前段时间冲上热搜的问题「9.11比9.9大吗?」,让几乎所有LLM集体翻车。看似热度已过,但AI界大佬Andrej Karpathy却从中看出了当前大模型技术的本质缺陷,以及未来的潜在改进方向。
用光训练神经网络,清华成果最新登上了Nature!
GPT-4o的怪癖暴露了,还是被官方公开的!

GPT-5 大模型?不要太着急。
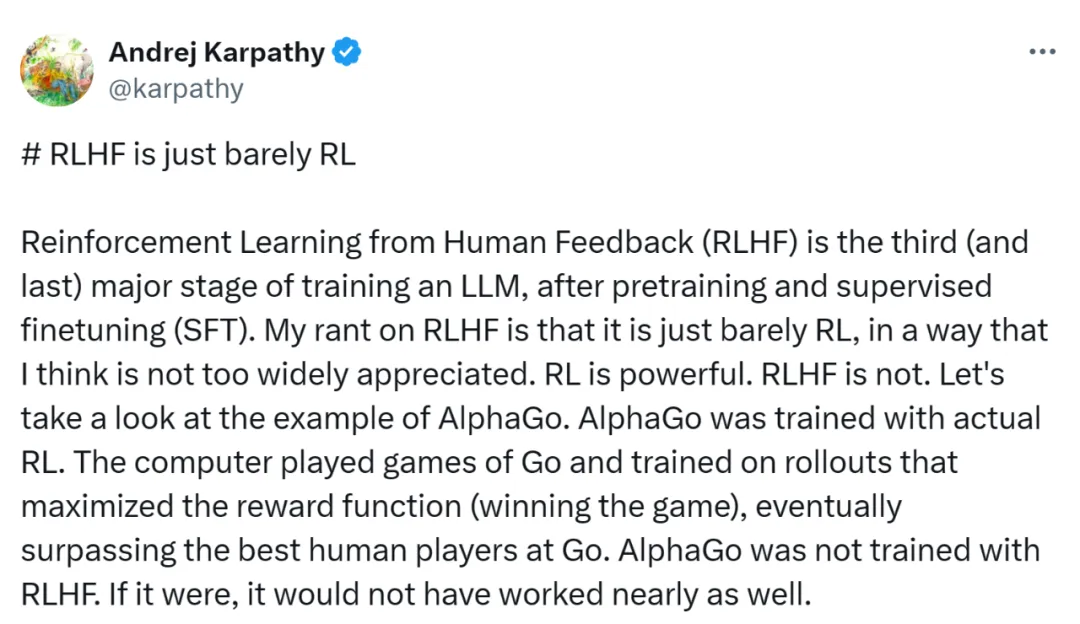
RLHF 与 RL 到底能不能归属为一类,看来大家还是有不一样的看法。
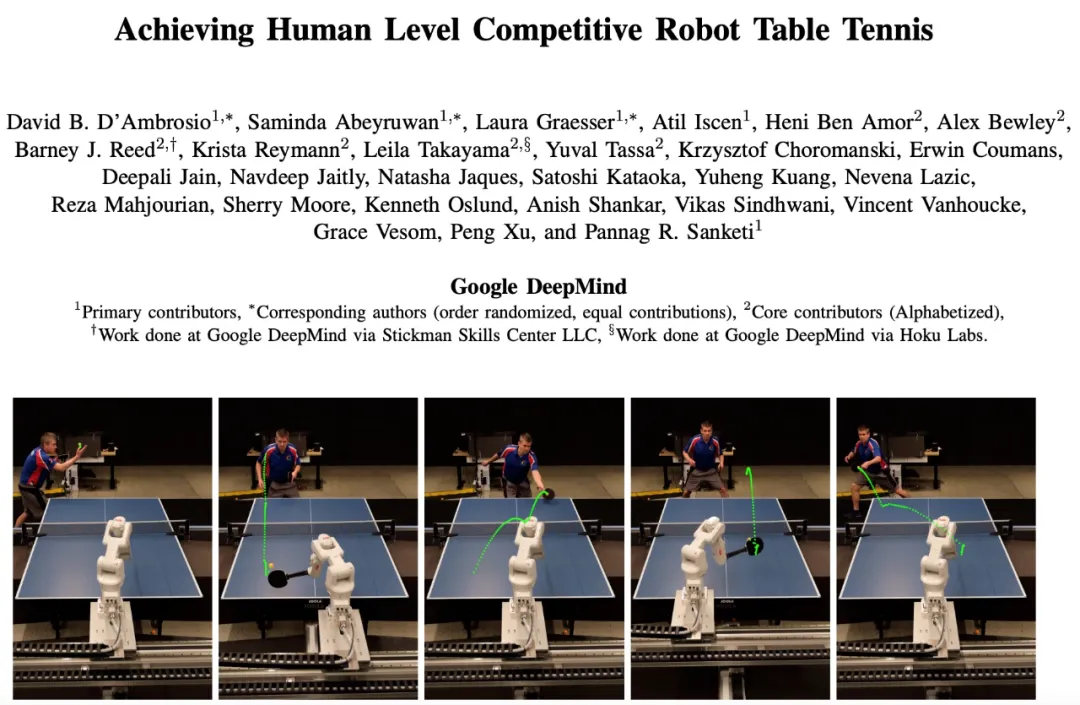
但可能打不过公园里的老大爷?

端到端是不是被“神话”了。
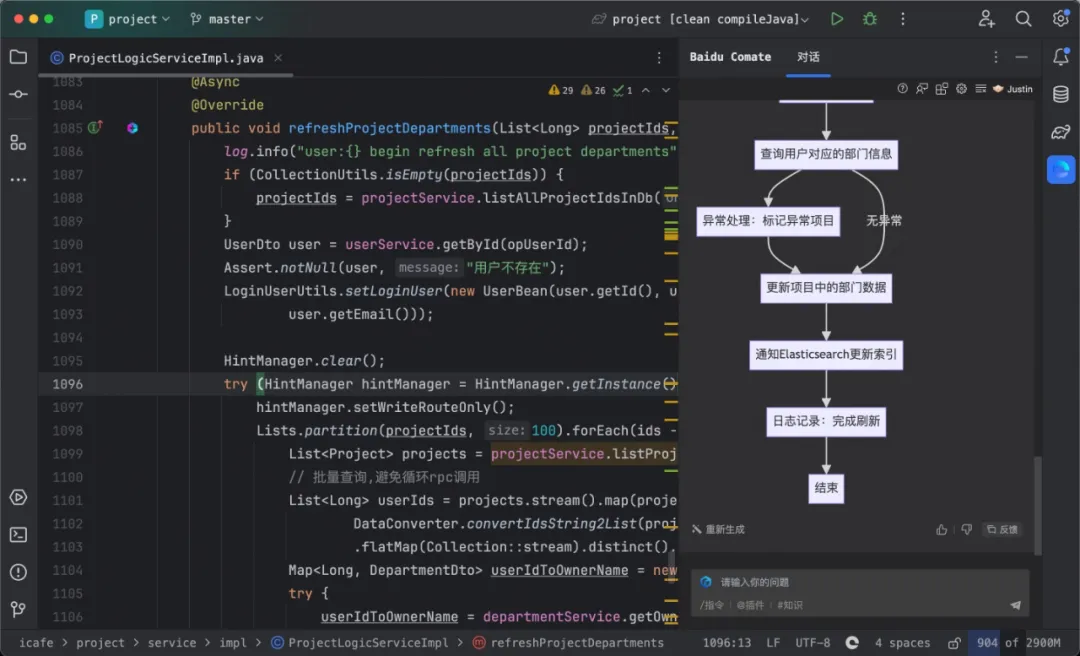
你敢想,AI 已经不满足只做程序员了,如今又向架构师这一进阶职业发起挑战。