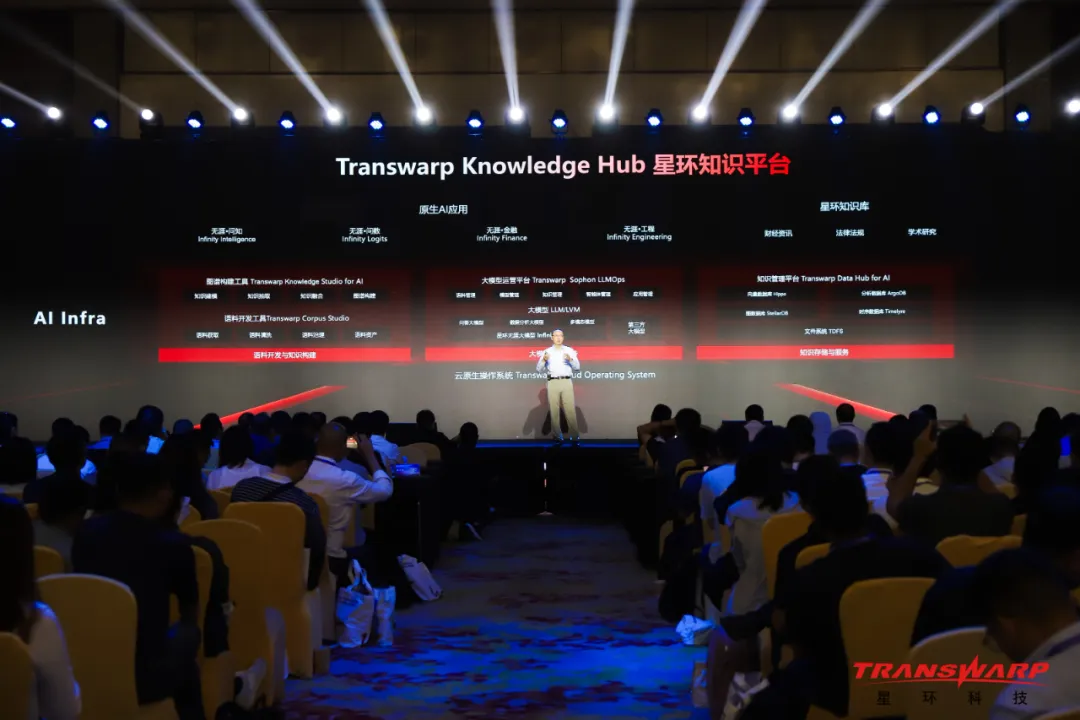
星环科技孙元浩:语料已经是大模型最大的挑战
星环科技孙元浩:语料已经是大模型最大的挑战「原来以为语料已经匮乏了,大模型训练已经没有语料了,实际上不是的,数据还远远没有跑光」。
来自主题: AI资讯
10768 点击 2024-06-16 18:09

 搜索
「原来以为语料已经匮乏了,大模型训练已经没有语料了,实际上不是的,数据还远远没有跑光」。
Meta AI的NLLB-200登上Nature,「不让任何一门语言掉队」,能翻译200种语言的大模型获得Nature社论的盛赞——复兴了濒临灭绝的语言,但是Nature研究人员也郑重提醒Meta,必须将使用这些语言的社区也纳入进来,才会真正减缓语言的消亡。
大模型是世界模型吗?UA微软等机构最新研究发现,GPT-4在复杂环境的模拟中,准确率甚至不及60%。对此,LeCun激动地表示,世界模型永远都不可能是LLM。
GPT-4o掀起一股全模态(Omni-modal)热潮,去年的热词多模态仿佛已经不够看了。
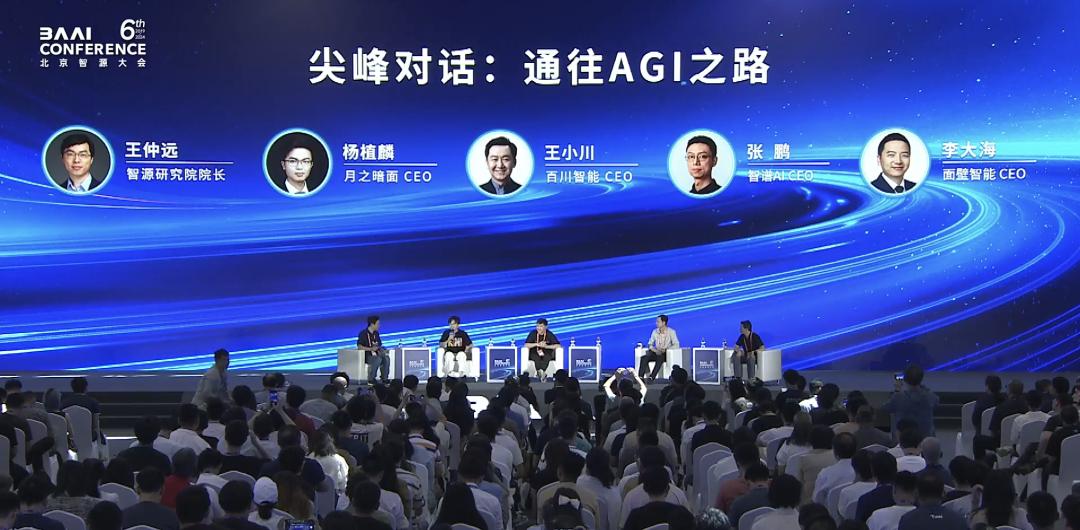
AGI太遥远,只有模型降价是共识。
训练数据的数量和质量,对LLM性能的重要性已经是不言自明的事实。然而,Epoch AI近期的一篇论文却给正在疯狂扩展的AI模型们泼了冷水,他们预测,互联网上可用的人类文本数据将在四年后,即2028年耗尽。

「超级对齐」团队集体出走后,OpenAI最近正在频繁招聘,但不是技术团队,而是高管。前有CFO走马上任,今天又有一个退役的陆军上将成为董事会新成员。
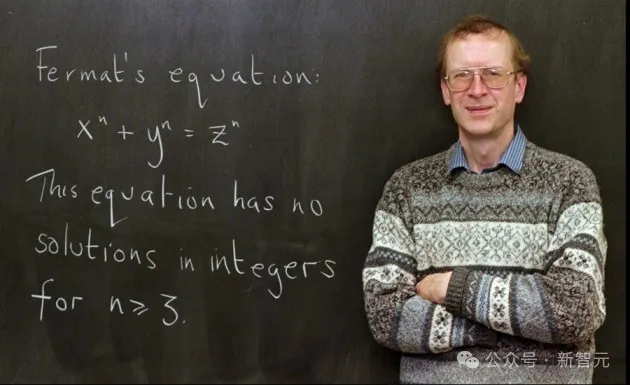
陶哲轩在最新的采访中,系统地谈到了AI可能会对数学领域产生的影响。他乐观地认为,使用Lean等工具「形式化」数学,在AI的辅助下实现规模化生产——一次证明数百或数千条定理。但他也审慎地预测,数学问题在短期内不会像国际象棋一样被「解决」,但有可能会提高人类科学家的洞察力。
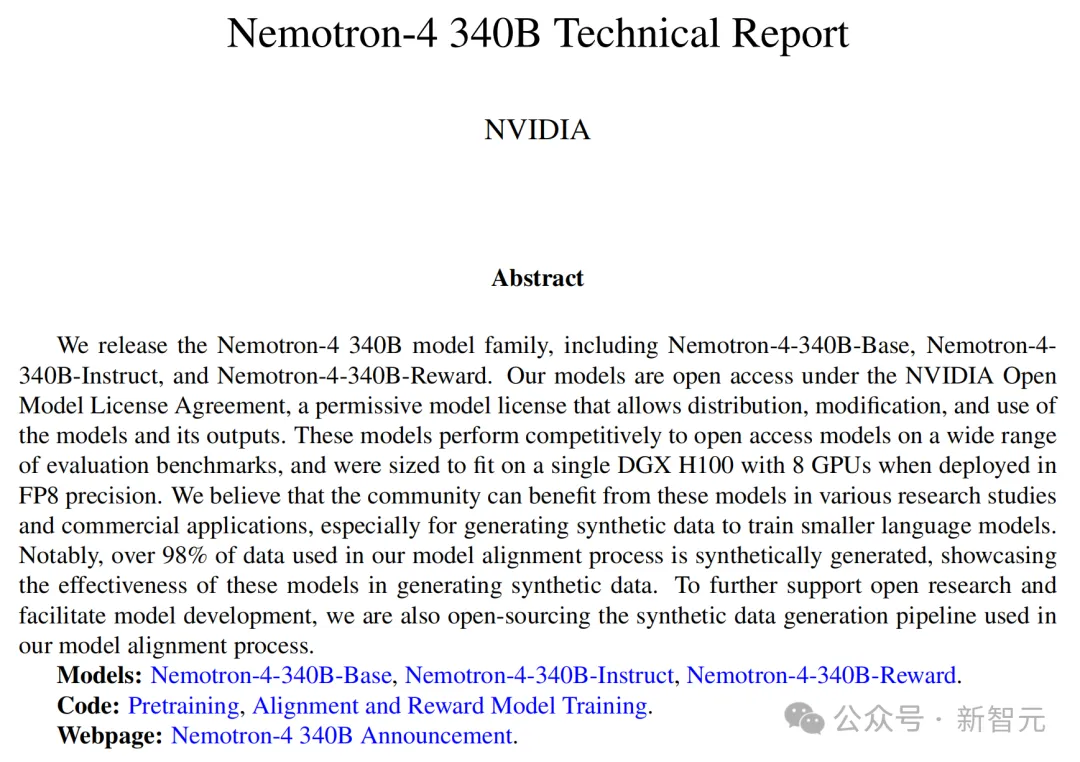
刚刚,英伟达全新发布的开源模型Nemotron-4 340B,有可能彻底改变训练LLM的方式!从此,或许各行各业都不再需要昂贵的真实世界数据集了。而且,Nemotron-4 340B直接超越了Mixtral 8x22B、Claude sonnet、Llama3 70B、Qwen 2,甚至可以和GPT-4掰手腕!
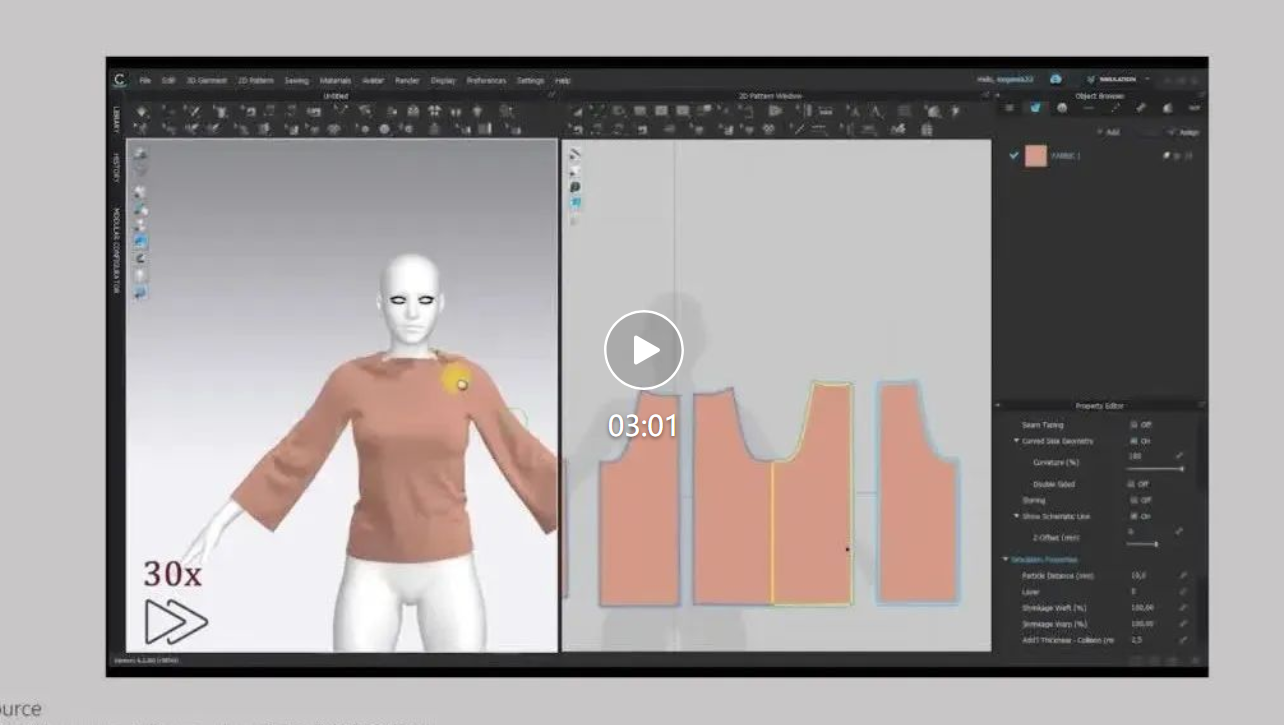
3D生成是生成式人工智能和计算机图形学领域最引人注目的话题之一,符合影视、游戏标准的3D生成尤其受产业界关注。在生产流程中,一般品类的3D资产往往通过手工建模或者扫描的方式制作。但作为3D资产的一个重要类别,服装资产的往往来源于平面板片与物理模拟等流程,而不是直接在3D上建模。