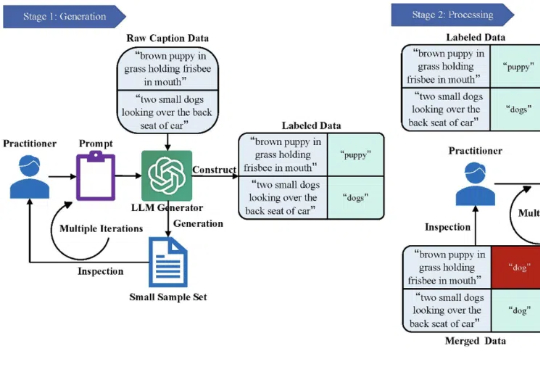
突破AI视觉“选择性失明”,哈工大首次实现指令驱动的全景式感知
突破AI视觉“选择性失明”,哈工大首次实现指令驱动的全景式感知对于AI视觉多模态大模型只关注显著信息这一根本性缺陷,哈工大GiVE实现突破!
来自主题: AI技术研报
8463 点击 2025-04-18 15:13

 搜索
对于AI视觉多模态大模型只关注显著信息这一根本性缺陷,哈工大GiVE实现突破!
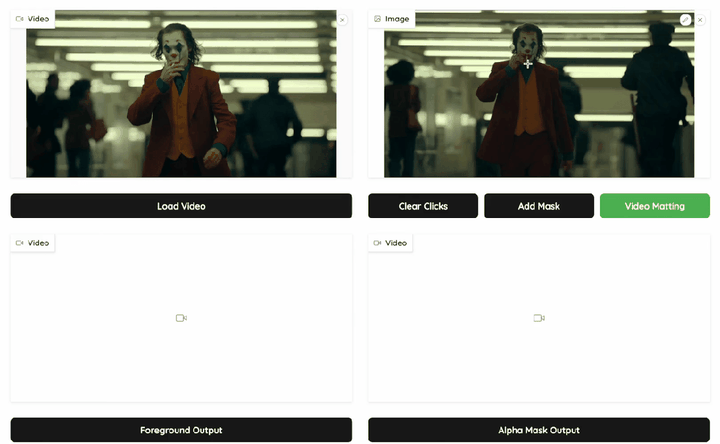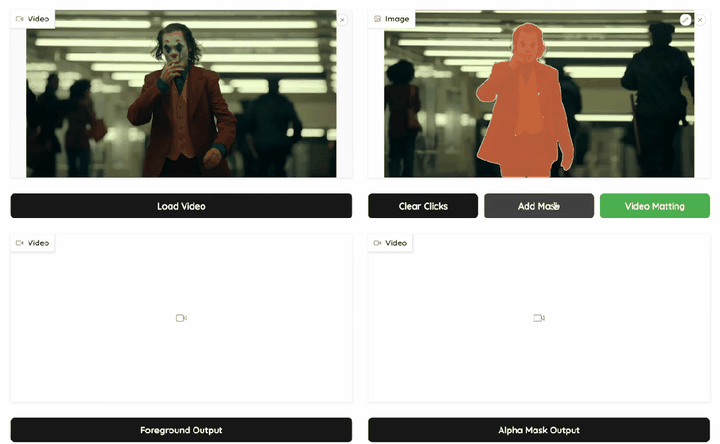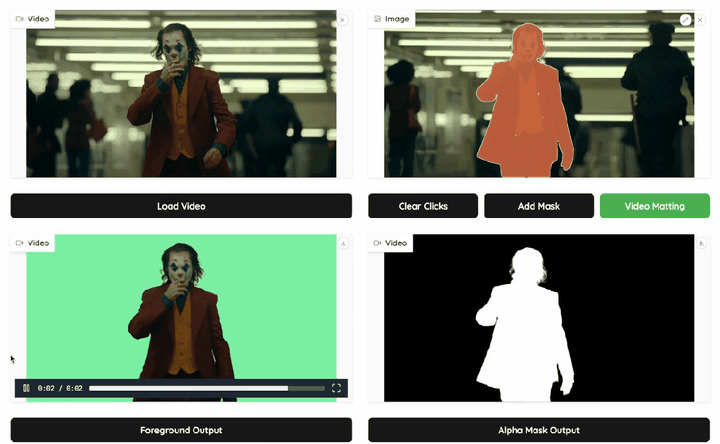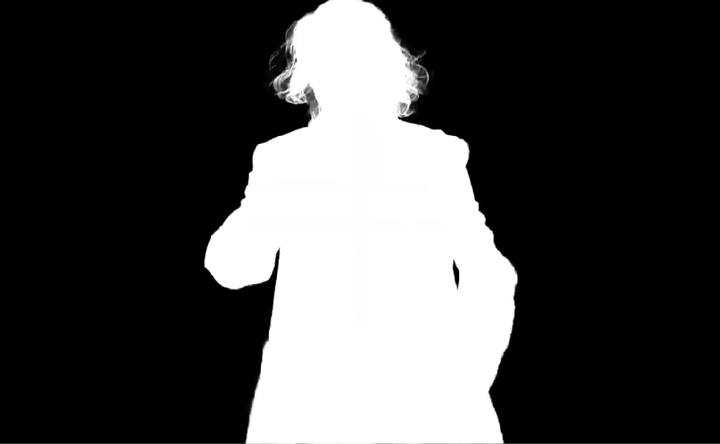
视频人物抠像技术在电影、游戏、短视频制作和实时视频通讯中具有广泛的应用价值,但面对复杂背景和多目标干扰时,如何实现一套兼顾发丝级细节精度及分割级语义稳定的视频抠图系统,始终是个挑战。
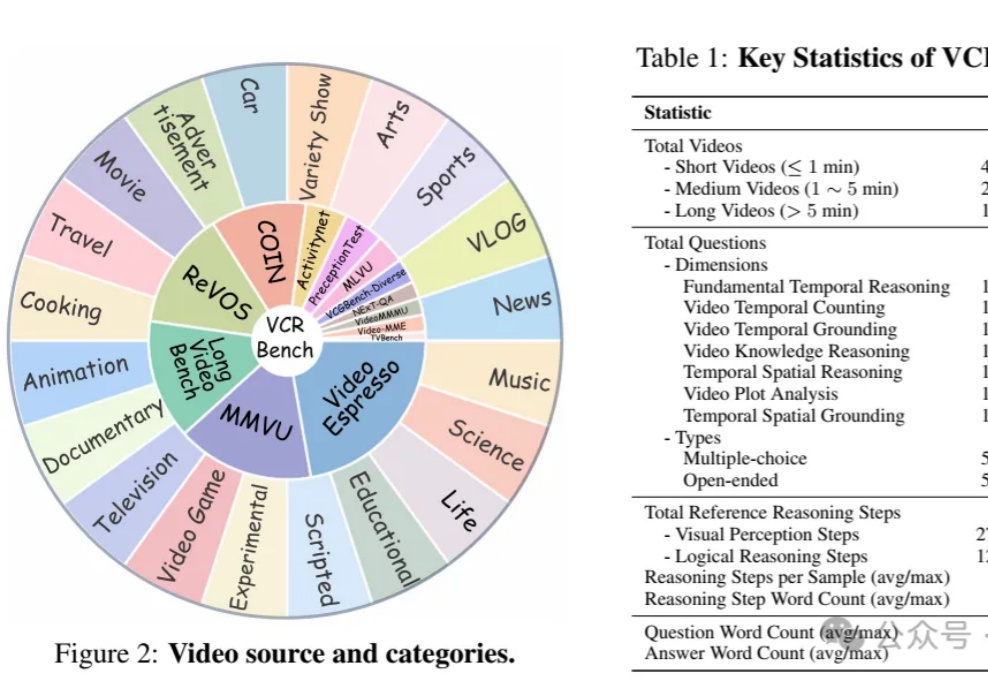
视频理解的CoT推理能力,怎么评?
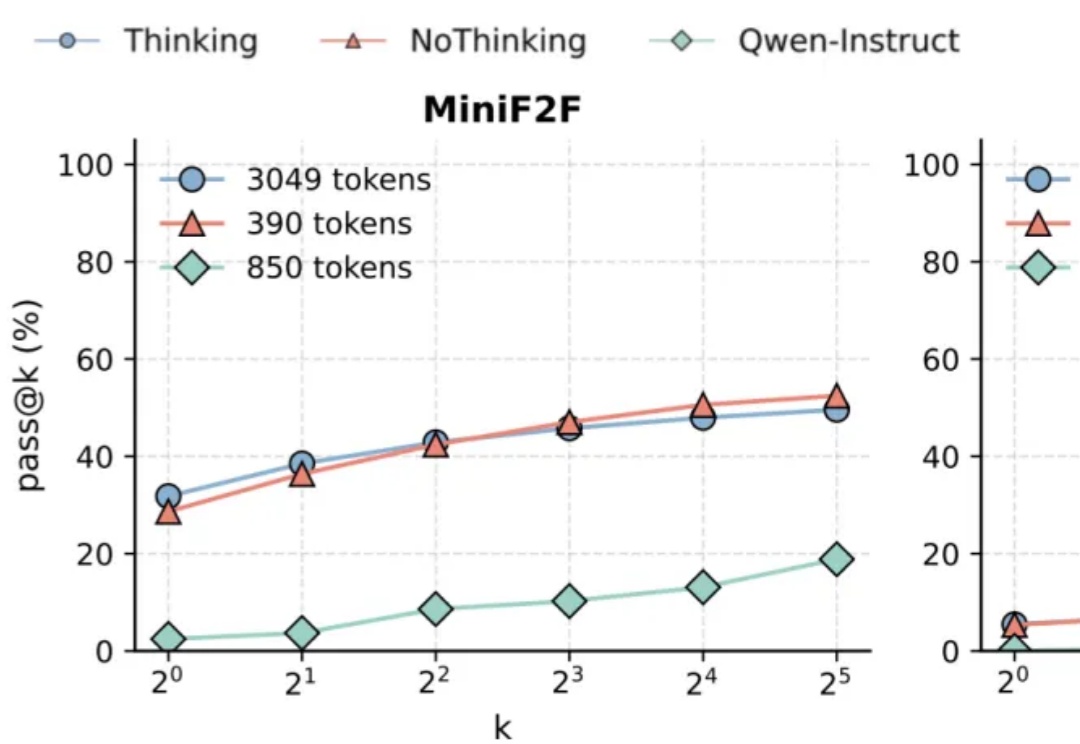
让推理模型不要思考,得到的结果反而更准确?

最近,来自大连理工和莫纳什大学的团队提出了物理真实的视频生成框架 VLIPP。通过利用视觉语言模型来将物理规律注入到视频扩散模型的方法来提升视频生成中的物理真实性。

Transformer架构主导着生成式AI浪潮的当下,但它并非十全十美,也并非没有改写者。
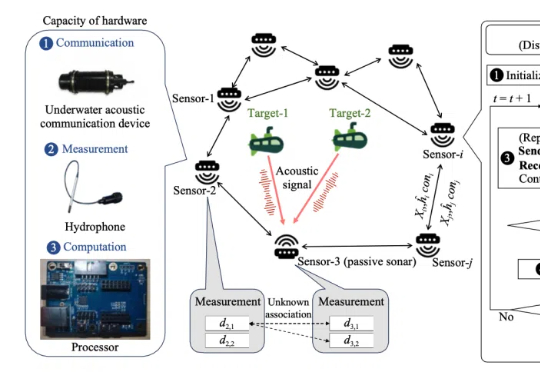
多智能体系统分布式共识优化的一系列研究来了!

这是一份142页的研究论文,本文深入解析了大型推理模型DeepSeek-R1如何通过"思考"解决问题。研究揭示了模型思维的结构化过程,以及每个问题都存在甜蜜点"最佳推理区间"的惊人发现。这标志着"思维学"这一新兴领域的诞生,为我们理解和优化AI推理能力提供了宝贵框架。
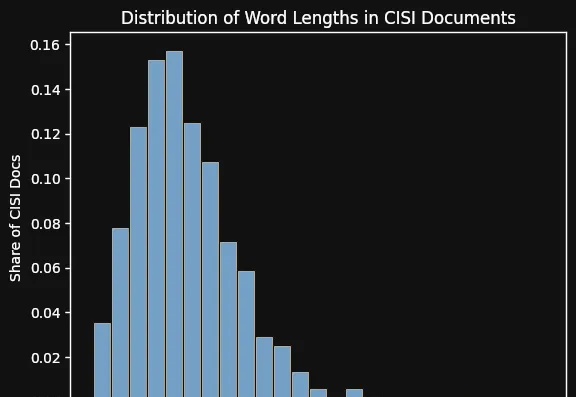
向量模型的核心功能是测量语义相似度,但这个测量结果很容易受到多种干扰因素的影响。在本文中,我们将着眼于文本向量模型中一个普遍存在的偏差来源:输入内容的长度。
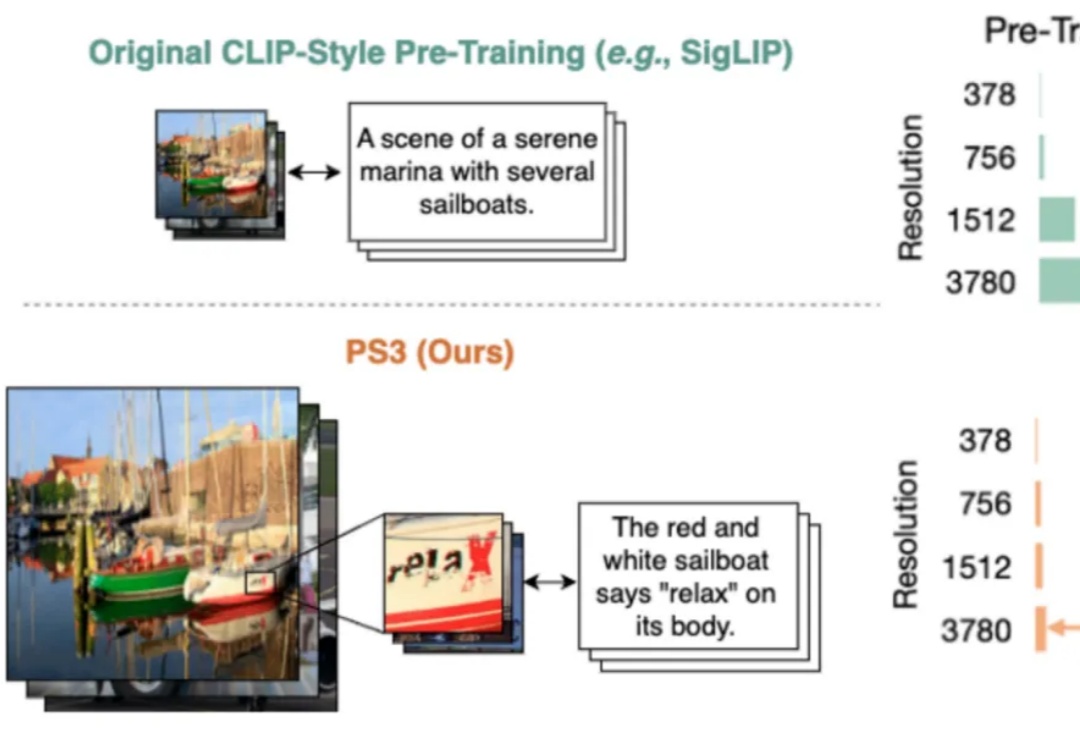
当前,所有主流的视觉基础模型(如 SigLIP、DINOv2 等)都仍然在低分辨率(如 384 * 384 分辨率)下进行预训练。对比人类视觉系统可以轻松达到 10K 等效分辨率,这种低分辨率预训练极大地限制了视觉模型对于高清细节的理解能力。